
OpenSeeker-v2:仅靠 SFT 挑战工业级深度搜索智能体极限
OpenSeeker-v2: Pushing the Limits of Search Agents with Informative and High-Difficulty Trajectories
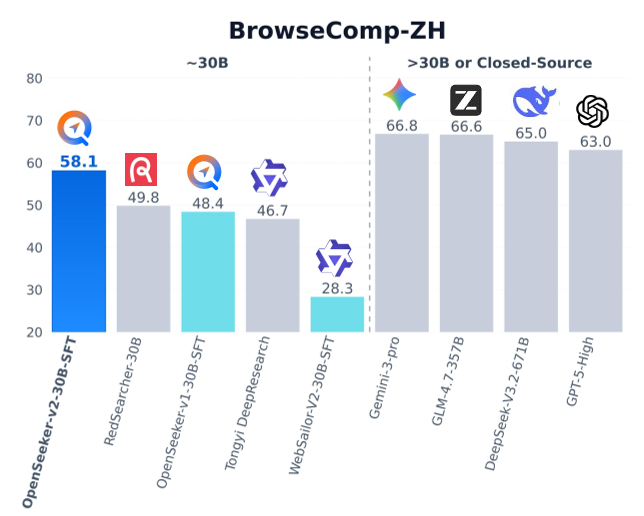
OpenSeeker-v2 是由上海交通大学团队开发的开源深度搜索智能体(Search Agent),通过纯监督微调(SFT)在 30B 规模模型上实现了 SOTA 性能。该方法核心在于构建高质量、高难度的合成轨迹数据,在 BrowseComp、HLE 等四个权威榜单上超越了经过复杂 CPT+SFT+RL 流程训练的工业界模型(如通义 DeepResearch)。
TL;DR
在 AI 智能体领域,超长程搜索(Deep Research)一直被公认为是大模型能力的“深水区”。过去,通往 SOTA 的路径似乎只有一条:烧钱做 CPT + 繁琐的 RL。然而,上海交大的研究团队通过 OpenSeeker-v2 给出了一份令学术界振奋的答卷:通过 10.6k 条高质量、高难度的合成轨迹进行纯 SFT,在 30B 规模上跨级反杀了一众工业巨头模型。
痛点深挖:为何深度搜索如此困难?
搜索智能体(Search Agent)在处理复杂问题时,面临的不是搜索不到信息,而是如何“思考并寻找”。现有的 Prior Work 存在两个主要瓶颈:
- 评估陷阱:许多训练数据过于简单,智能体只需 1-2 步关键词检索即可获得答案,导致其无法学会持续推理。
- 路径垄断:工业界倾向于使用 CPT (增量预训练) 来灌输新知识,并用 RL (强化学习) 来对齐搜索路径。这种方法对算力要求极高,阻碍了学术界的创新。
作者认为:智能体长程搜索能力的匮乏,本质上是因为训练数据“太容易了”。
核心方法:数据炼金术的三大支柱
OpenSeeker-v2 的核心思想是:与其改进算法,不如升级数据。作者通过对合成数据管线的三个微小改动,实现了质的飞跃。
1. 扩大证据图谱 (Scaling Graph Size)
在生成合成问题时,作者扩大了知识图谱的提取范围(从 扩展到 )。
- 直觉:背景上下文包含的相关节点越多,信息拓扑就越复杂。这强迫模型必须在多个信源之间进行横向对比和多步跳转(Multi-hop),而不是一次搜索定胜负。
2. 工具集多样化 (Expanding Tool Set)
模型被赋予了更丰富的 API 调用权限。这不仅增加了功能,更重要的是增加了智能体在解决问题时的策略空间,使其能学会在不同场景下组合使用不同工具。
3. 严格的“低步数”过滤 (Low-step Filtering)
这是本文最有洞见的点。作者设定了一个阈值 ,任何能在少数几步内解决的轨迹都被无情丢弃。
- 结果:OpenSeeker-v2 的训练轨迹平均达到 64.67 步,远高于 V1 版本的 46.97 步。这种“魔鬼训练”强制模型习得了极强的耐力和复杂路径规划能力。
实验与结果:小模型也能反杀大模型
实验结果令人侧目。在 BrowseComp(网页浏览任务)和 HLE(高难人类考试)等榜单上,OpenSeeker-v2-30B 表现出色:
- 对标工业界:全面超越了通义 DeepResearch(采用 CPT+SFT+RL)和 RedSearcher。
- 跨级打击:性能甚至压制了 671B 的 DeepSeek-V3.1 和闭源的 Claude-4.5-Sonnet。
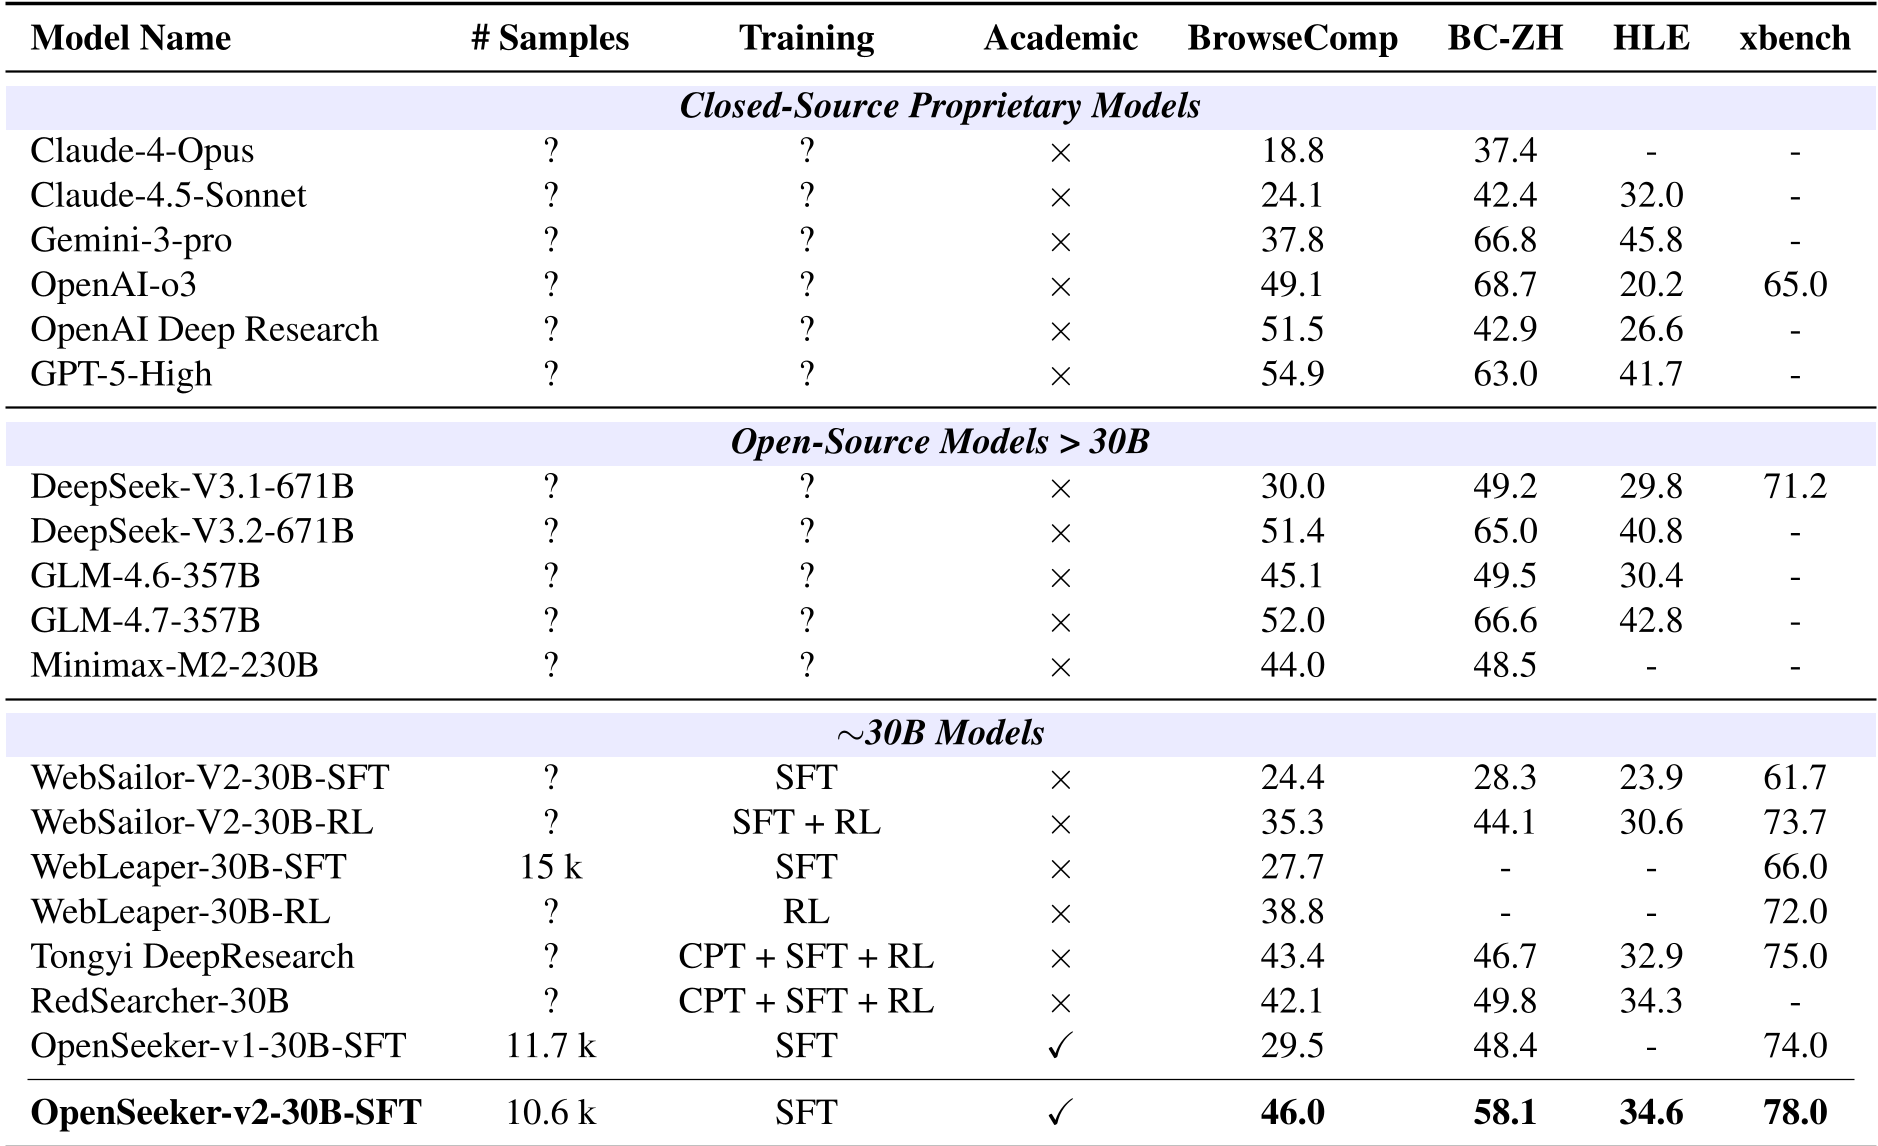
上表清晰地展示了,即便在没有强化学习的情况下,只要数据量质齐升,30B 级别的模型依然具备极强的爆发力。
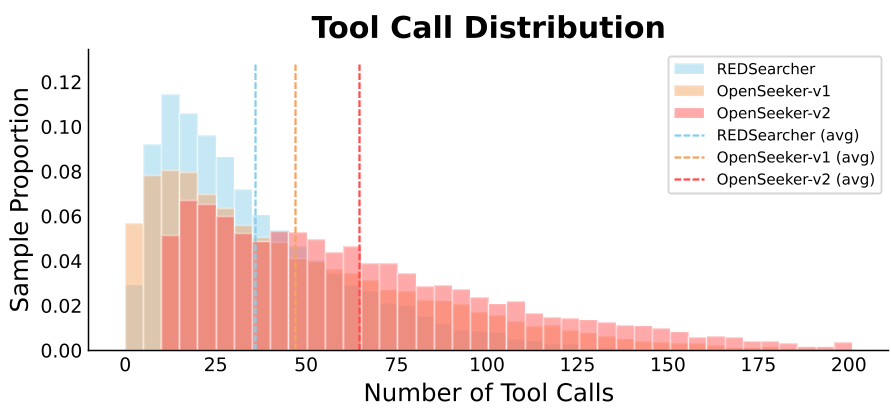 图 2:OpenSeeker-v2 的轨迹步数显著高于同类模型,验证了其处理高难度任务的潜力。
深度洞察与总结
学术价值:OpenSeeker-v2 打破了“只有大算力、大公司才能做强 Agent”的迷思。它证明了在 30B 这个甜点位(Sweet Spot),通过精准的数据工程,人类可以训练出不输于千亿参数模型的专业搜索能力。
局限性与展望: 虽然 SFT 表现惊人,但作者也提到该框架尚未饱和。未来,将这种高难度轨迹数据与 RLHF 结合,可能会进一步解锁智能体的自我纠错和反思能力。
总结 (Takeaway):数据质量决定了智能体的上限,而数据难度(Trajectory Difficulty)则决定了智能体在复杂现实任务中的可靠性。对于资源有限的开发者,深耕数据合成(Data Synthesis)是比追求复杂算法更具性价比的路径。