
OpenSearch-VL:打造开源多模态深度搜索 Agent 的全能食谱
OpenSearch-VL: An Open Recipe for Frontier Multimodal Search Agents
本文推出了 OpenSearch-VL,一套用于构建顶尖多模态深度搜索智能体的全开源方案。该方案涵盖了从数据增强、多样化工具环境到强化学习算法的全流程,使模型能够通过主动搜索、证据核实和多步推理解决复杂的知识密集型视觉问题,在多项基准测试中平均提升超过 10 分。
TL;DR
在 AI 智能体向“深度研究(Deep Research)”进化的过程中,如何让模型像人类一样主动利用工具检索信息并核实事实?OpenSearch-VL 给出了答案。它不仅开源了一套包含 36k SFT 和 8k RL 的高质量多模态轨迹数据集,还通过一种新颖的致命错误感知 GRPO 算法,解决了多步工具调用中“一步错、步步错”导致的训练噪声问题。
背景:多模态搜索的“最后一公里”
尽管 GPT-4o 或 Gemini 在简单的视觉问答上表现优异,但面对“图中大桥是哪一年通车的?”这类需要从图像到搜索、再到多步验证的复杂问题,模型往往会陷入幻觉。现有的开源方案面临两大痛点:
- 数据短路:训练数据中常包含实体名称,导致模型直接搜索答案而非通过视觉线索推导,丧失了推理链条。
- 知觉失效:现实中的图片可能模糊或歪斜,模型如果不具备“修复图片”的能力,后续搜索只能是无米之炊。
核心方法论:从数据到算法的重构
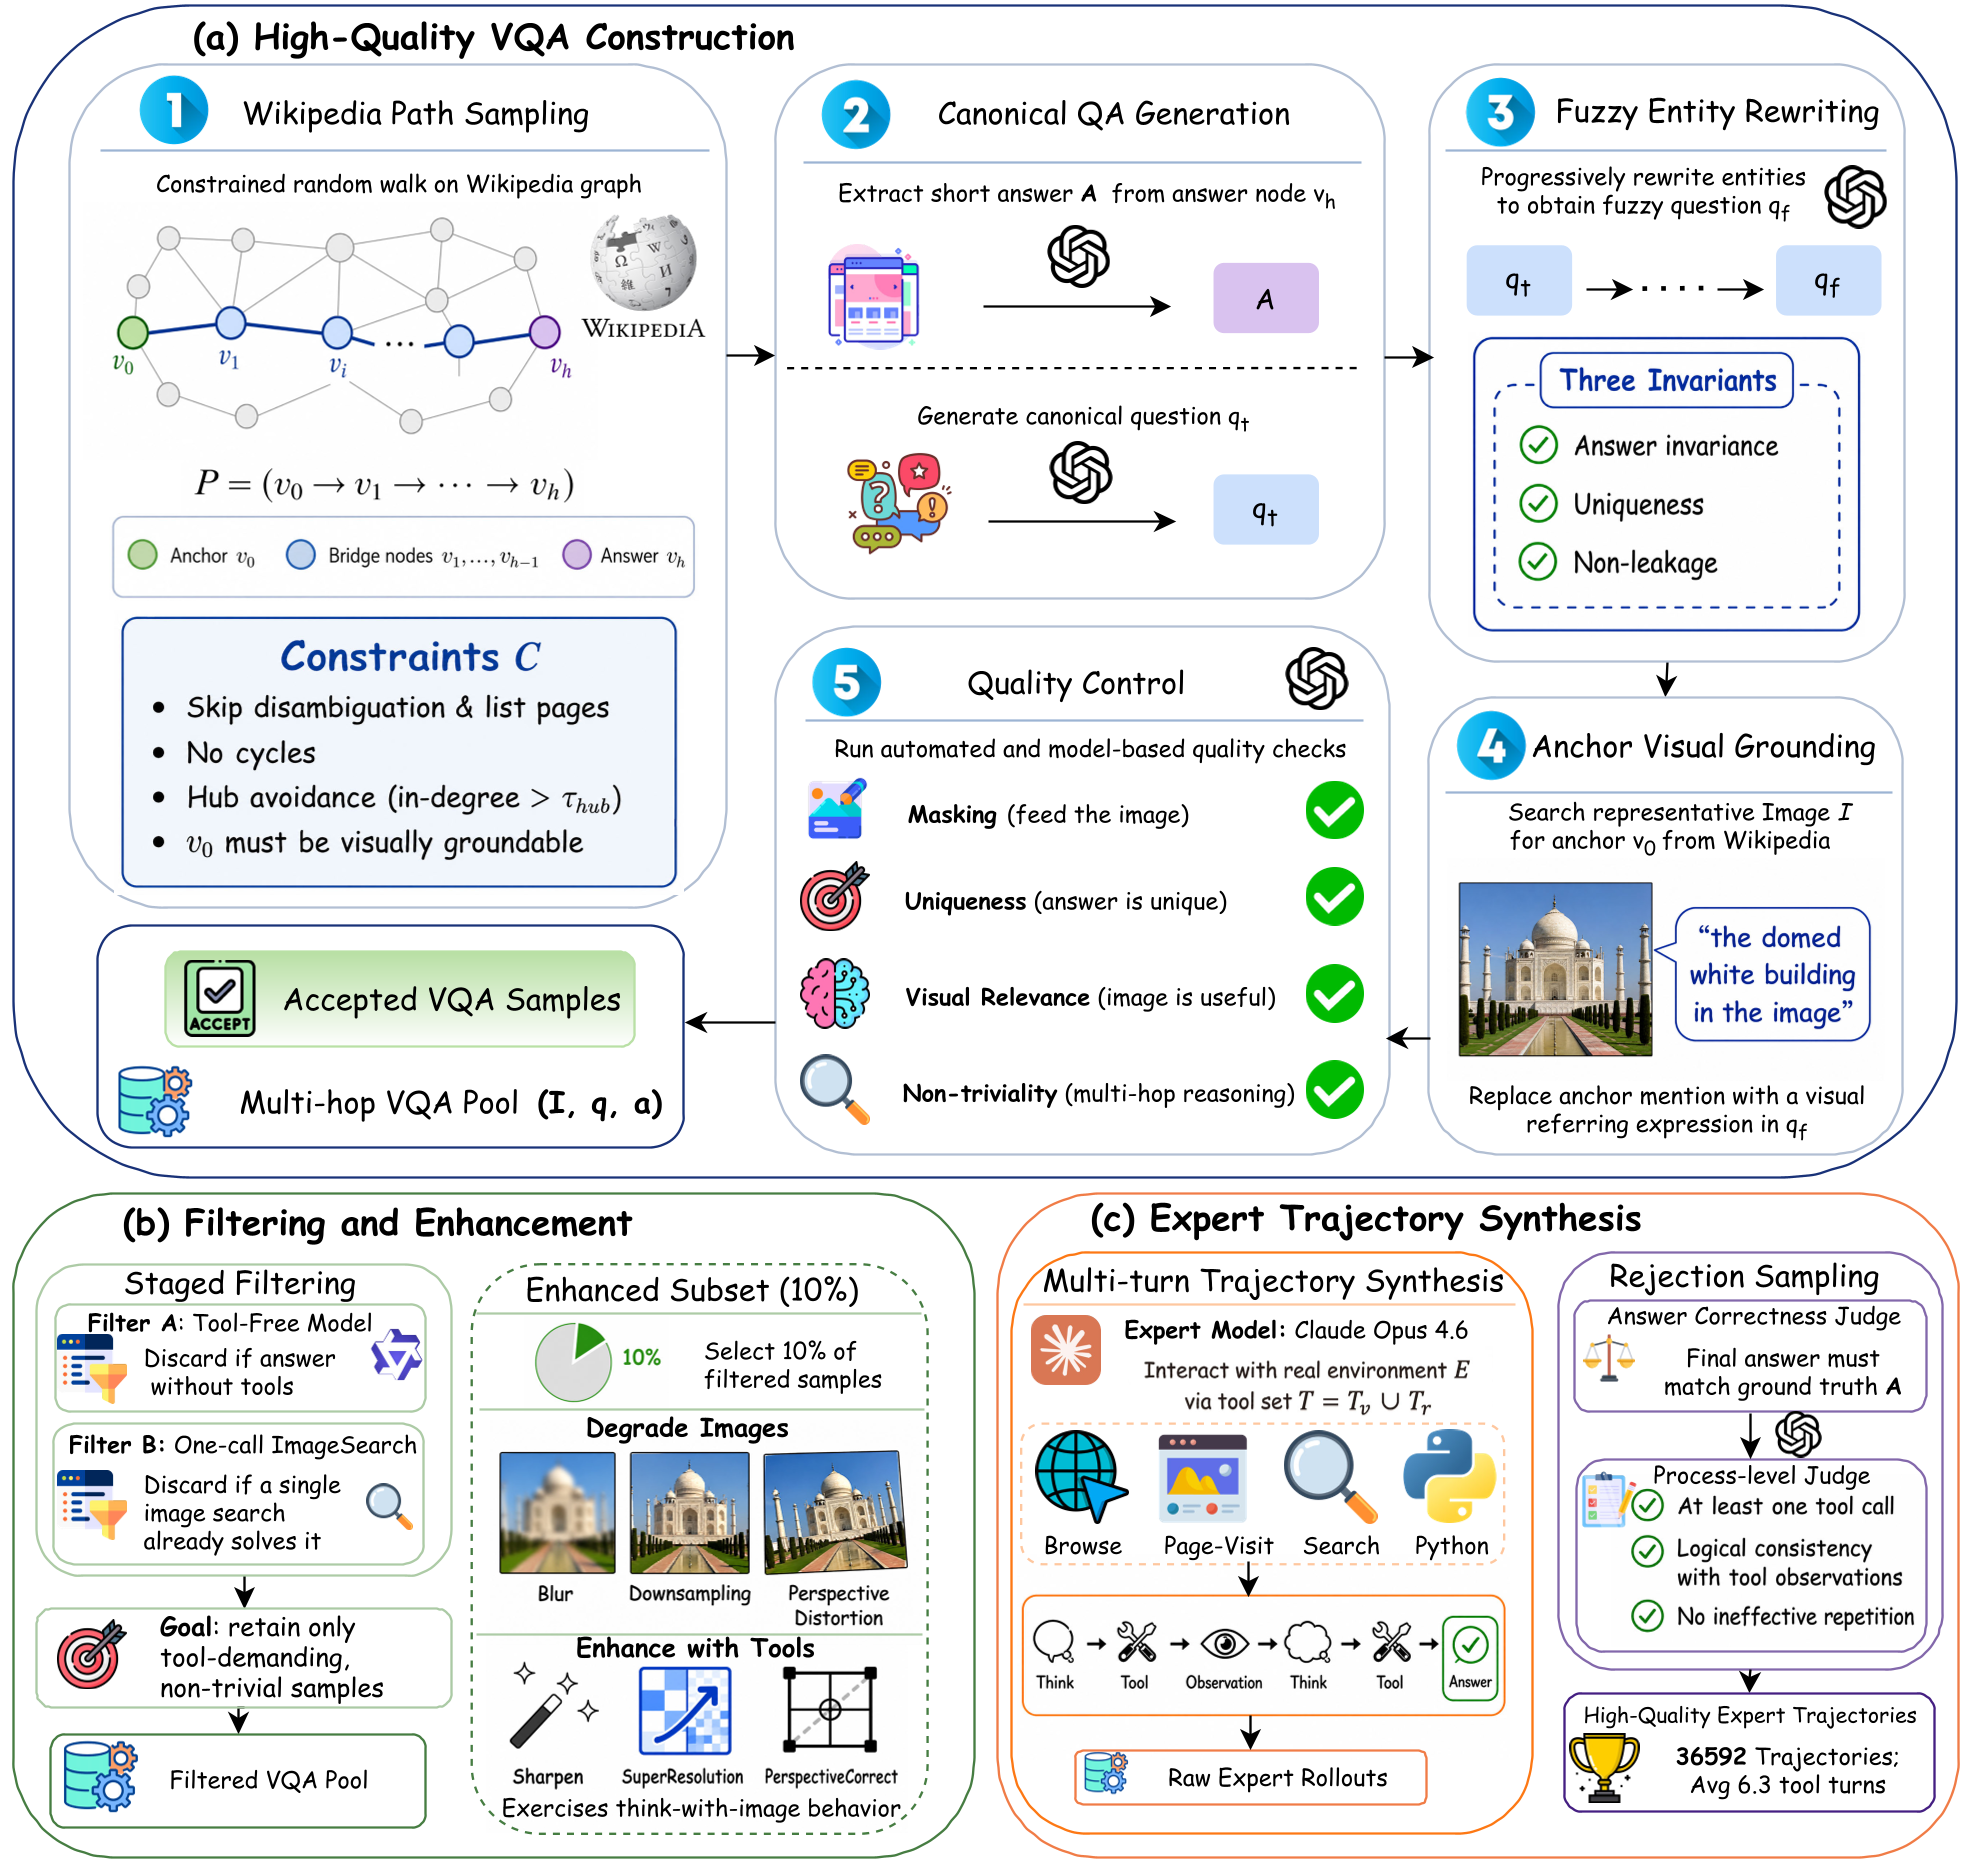
1. 拒绝快捷方式的数据流水线
作者从 Wikipedia 的超链接图出发,采样多跳实体路径。关键在于模糊实体改写(Fuzzy Entity Rewriting):不直接告诉模型我们要找“Steve Irwin”,而是改写为“1991年接管澳大利亚动物园管理权的那个男人”。配合源锚点视觉定位,模型被迫必须先理解图像内容,才能通过中间关系找到最终答案。
2. “知觉先行”的工具箱
OpenSearch-VL 赋予了 Agent 不仅是简单的 TextSearch。它还配备了:
- 修复工具:Sharpen(锐化)、SuperResolution(超分)、PerspectiveCorrect(透视纠正)。
- 细粒度工具:Crop(裁剪)、OCR(版面分析)。
这意味着模型在发现图片看不清时,会主动调用“超分辨率”后再进行 OCR,这种“思考并行动”的链路与人类逻辑高度一致。
3. 抗干扰的强化学习:致命错误感知 GRPO
这是本文在算法层面的最大亮点。在多轮交互中,如果第 3 步 API 调用超时或者格式错误,传统的强化学习往往会丢弃整条轨迹(浪费了前 2 步的正确思考),或者带着错误跑完(引入负面梯度)。
作者提出了 Fatal-aware Token Masking:
- 自动检测:当连续出现 3 次工具调用错误时,标记为“致命状态”。
- 单边优势钳制(One-sided Advantage Clamping):如果这条失败的轨迹在前几步表现得很出色(超过组平均水平),依然给它正向反馈;如果表现差,则将其优势值设为 0。这种设计确保了模型能从“未竟的事业”中学习。
实验与结果:全维度的超越
在包含 SimpleVQA、VDR、MMSearch 等 7 个高难度基准测试中,OpenSearch-VL 展现出了统治性能。
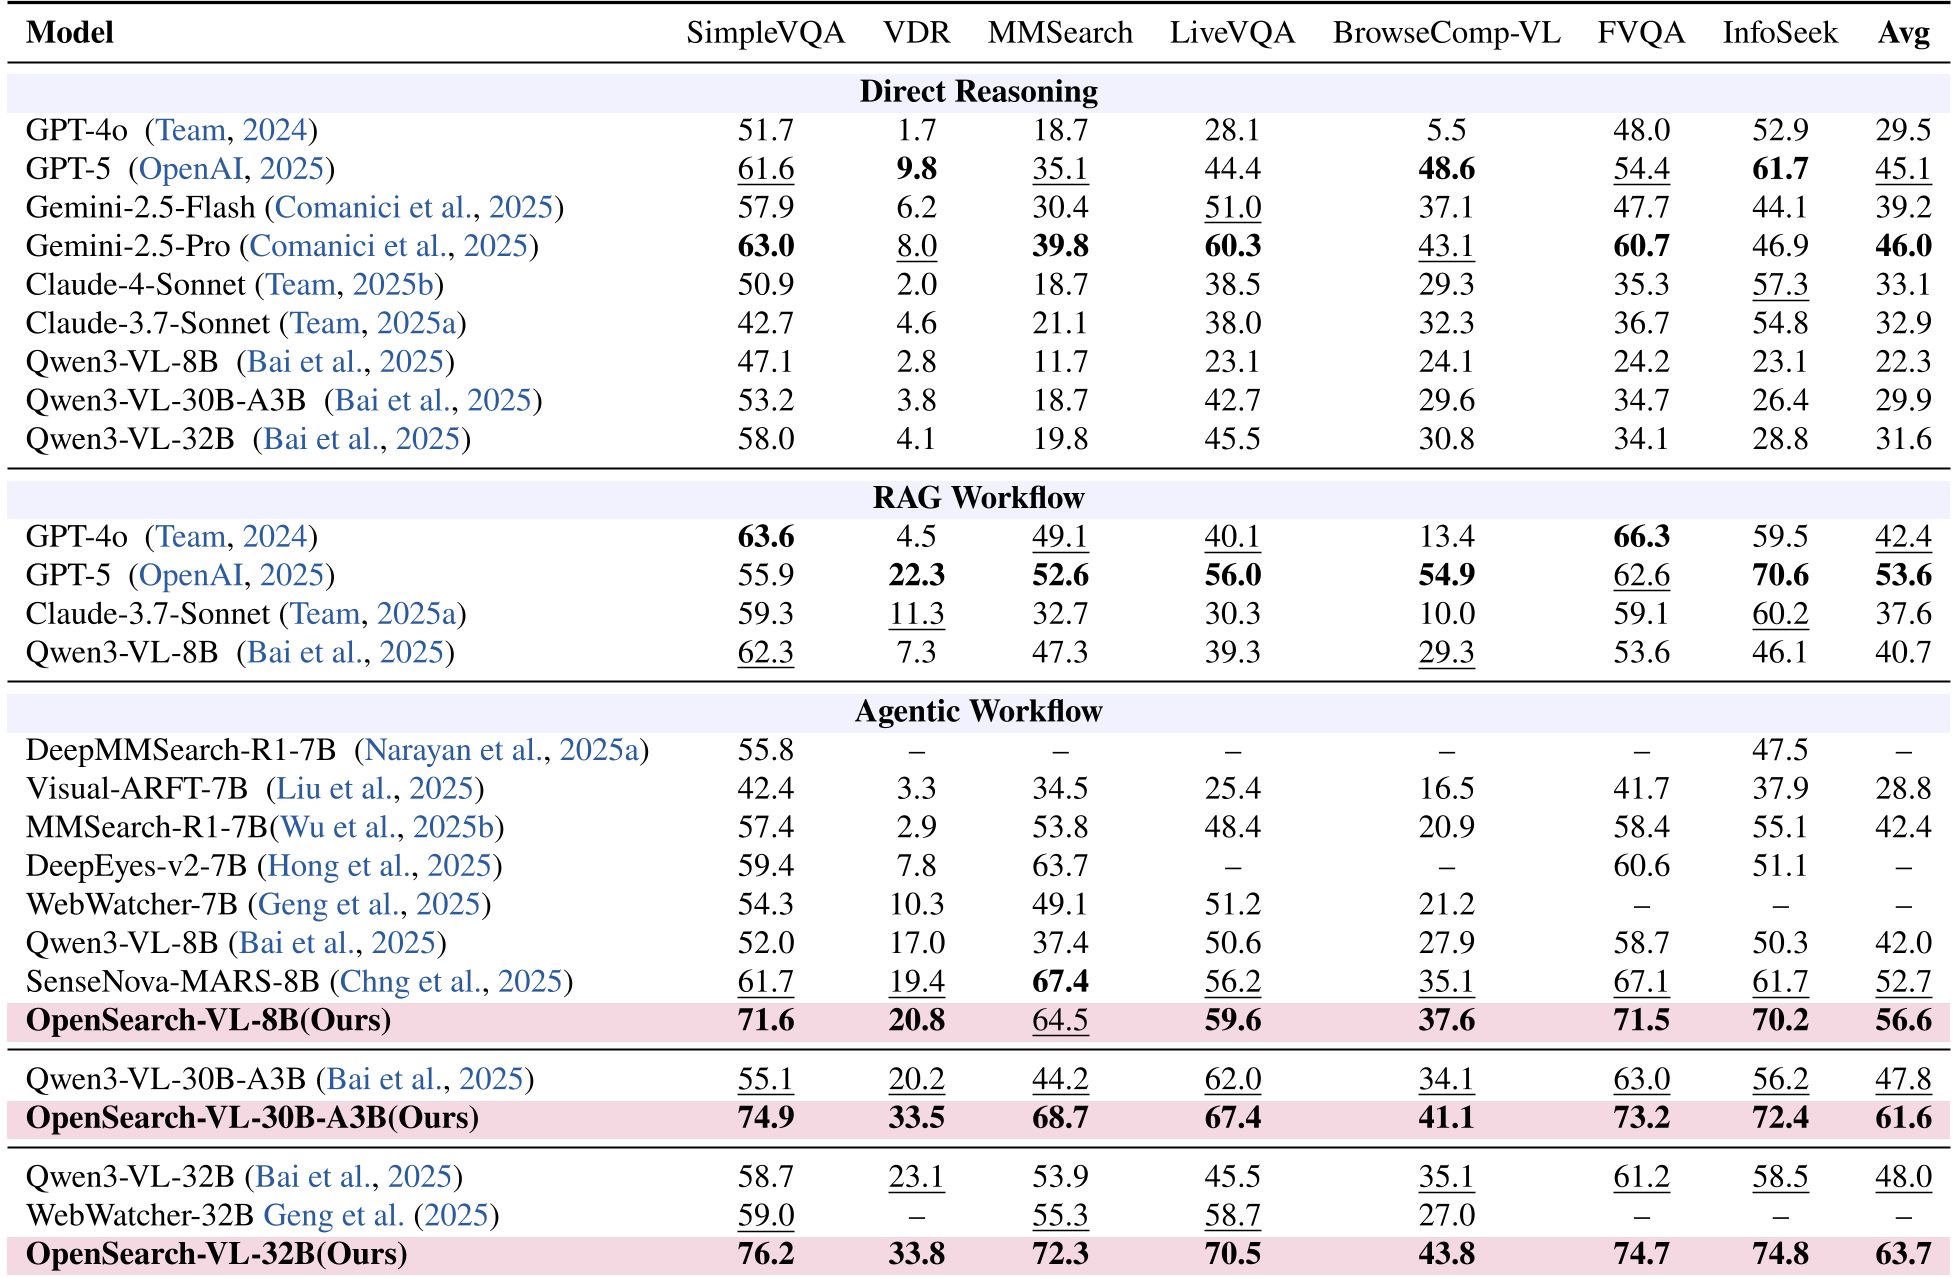
- 性能翻倍:在 MMSearch 任务上,相比原始基线模型提升了近 25 分。
- RL 的威力:消融实验证明,加入致命错误感知的 GRPO 相比传统 GRPO 提升了约 4.2%,且训练过程更加稳定,能够支撑更长步数的推理。
深度洞察:为什么这很重要?
OpenSearch-VL 的成功在于它承认了现实世界的“不完美”。
- 鲁棒性推理:通过 10% 的退化图像训练,Agent 学会了“磨刀不误砍柴工”,即先修复图片质量。
- 梯度提纯:致命错误采样策略本质上是在进行“信用分配(Credit Assignment)”的提纯,它解决了长程任务中奖励信号极度稀疏的问题。
总结与启示
OpenSearch-VL 不仅仅是一个刷榜的模型,它为多模态 Agent 提供了完整的闭环路径。其开源的意志(数据、代码、模型全放开)将极大降低跨过“Deep Research”门槛的难度。未来的研究可以进一步探索如何使用开源的进程奖励模型(PRM)来替代文中所依赖的 GPT-4o 裁判,实现真正的端到端开源演进。