
PaddleOCR-VL-1.5:以小博大,0.9B 参数刷爆真实场景文档解析记录
PaddleOCR-VL-1.5: Towards a Multi-Task 0.9B VLM for Robust In-the-Wild Document Parsing
本文推出了 PaddleOCR-VL-1.5,这是一个参数量仅为 0.9B 的超轻量级多任务视觉语言模型(VLM)。该模型在 OmniDocBench v1.5 上达到了 94.5% 的 SOTA 准确率,并针对真实世界的物理畸变(如弯曲、倾斜、光照不均)进行了深度优化。
TL;DR
百度 PaddlePaddle 团队近日发布了 PaddleOCR-VL-1.5。尽管其参数量稳定在极其精简的 0.9B,但它在处理真实世界“野外”环境下的文档(如手机拍照的账单、弯曲的书页、倾斜的合同)时,表现出了惊人的稳健性。它在 OmniDocBench v1.5 榜单上以 94.5% 的高分登顶,甚至在各种物理畸变环境下超越了参数量高达 235B 的通用多模态巨兽。
背景定位:从“实验室解析”走向“真实世界”
目前的 OCR 和文档解析模型在干净的 PDF 上表现出色,但一旦遇到手机随手一拍的文档,解析结果往往惨不忍睹。页面弯曲导致文字行在 2D 空间折叠,强光反射导致局部黑块,这些都是产业界落地中的“最后一公里”痛点。PaddleOCR-VL-1.5 的核心使命,就是解决这些 物理畸变 (Physical Distortions) 带来的鲁棒性挑战。
技术核心:PP-DocLayoutV3 引擎
以往的布局分析方法通常预测的是轴对齐的矩形框(Bounding Box),这在面对旋转或弯曲的文档时会包含大量背景噪声。
1. 统一的实例分割与阅读顺序架构
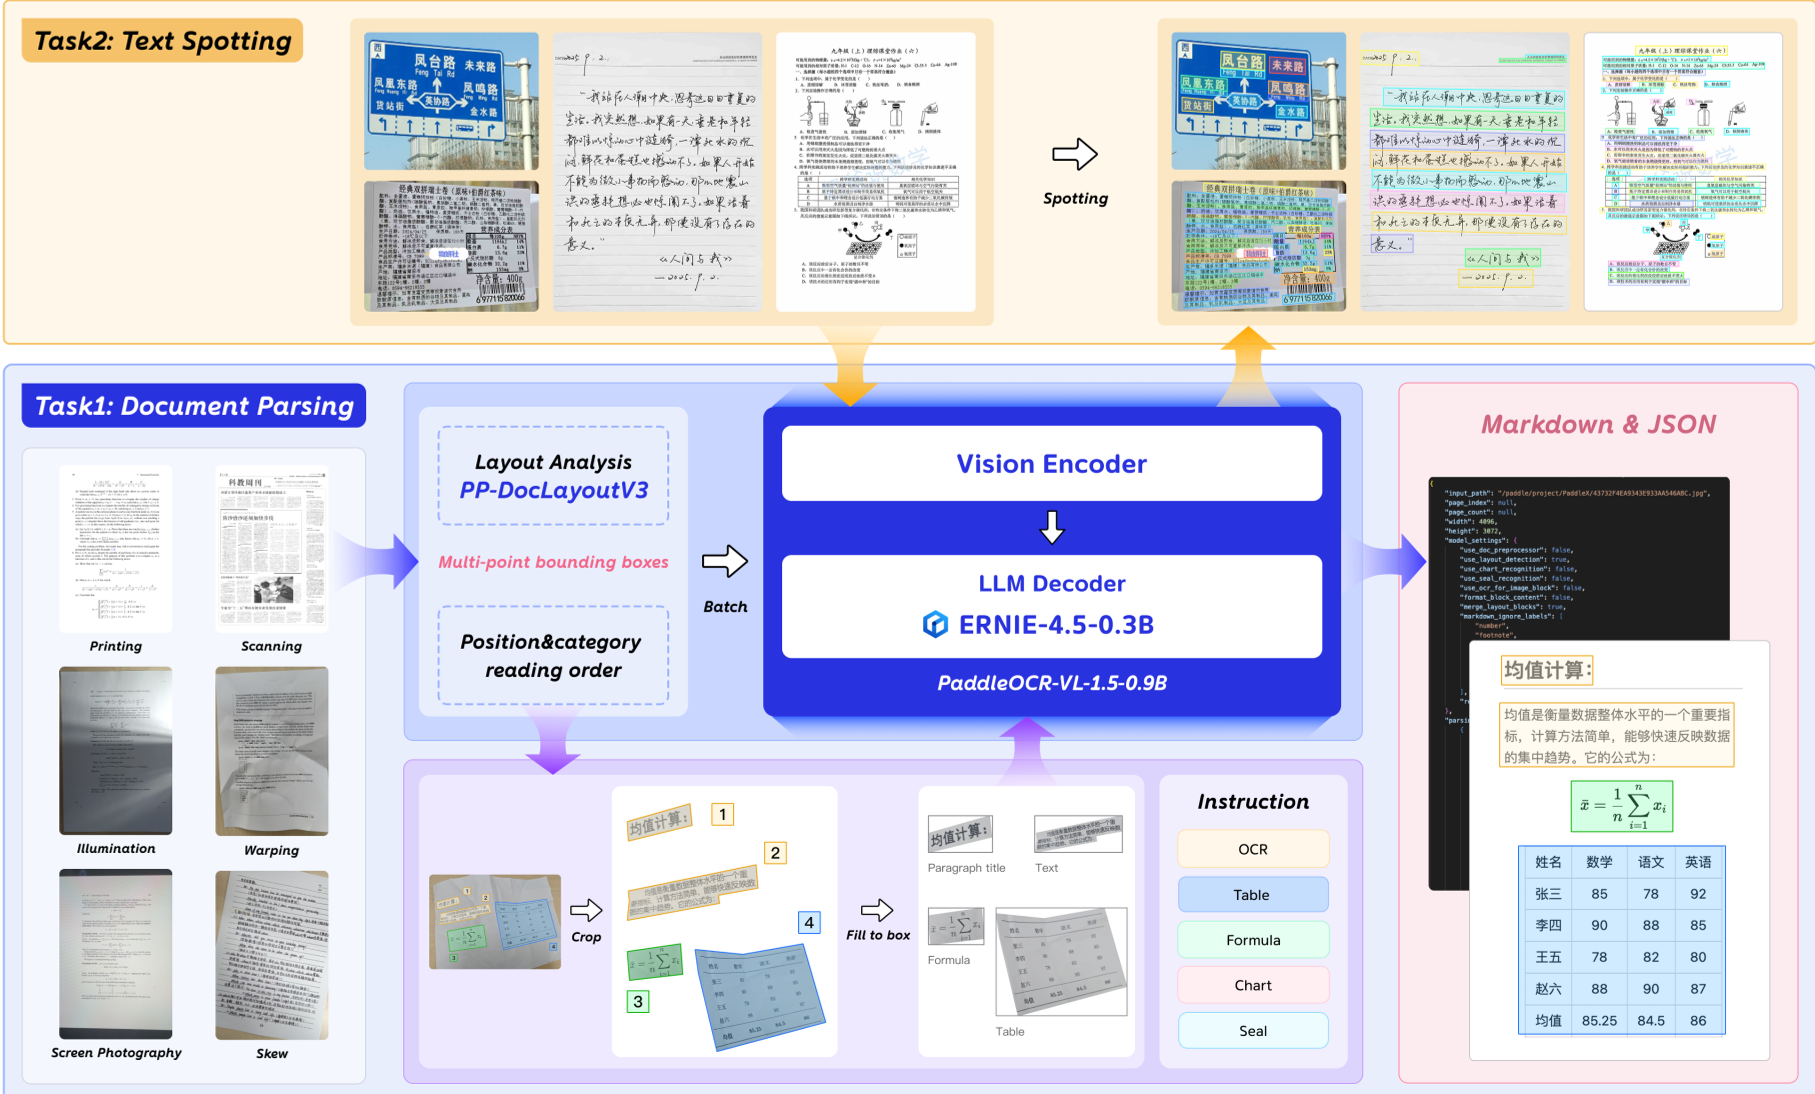
PP-DocLayoutV3 从矩形框检测演进为 Mask-based 实例分割。它能预测多点定位的遮罩(Mask),精准锁定不规则形状的文本块。更具创新性的是,它将 阅读顺序 (Reading Order) 预测直接集成到了 Transformer 解码器层中。
2. 全局指针机制 (Global Pointer Mechanism)
模型通过一个特殊的公式计算两两 Query 之间的排位得分: 这种方法保证了关系矩阵的反对称性,从而通过投票机制精准确定文档块的逻辑解析顺序,极大地减少了多栏或不规则排版中的乱码问题。
实验战绩:全方位的鲁棒性跨越
为了证明实力,作者提出了 Real5-OmniDocBench 基准,专门测评扫描、弯曲、屏幕拍摄、照明不均和倾斜五大极限场景。
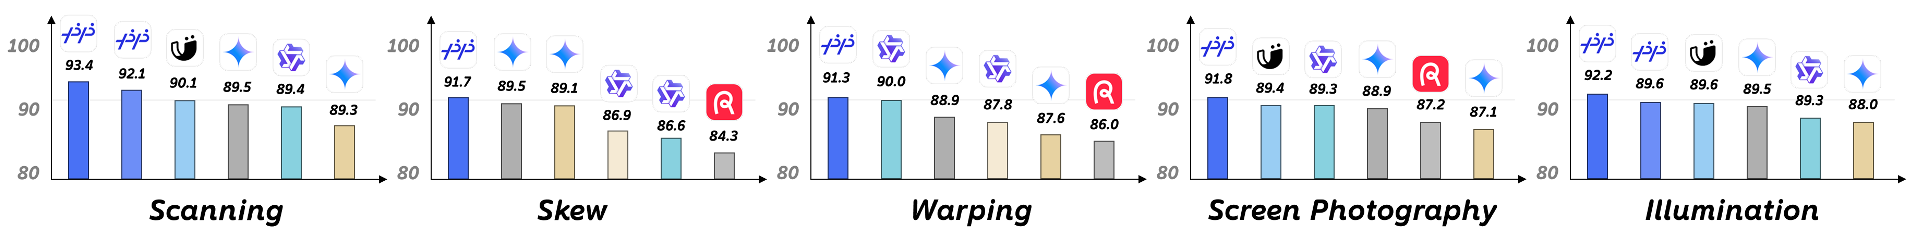
- 极端倾斜场景:准确率从前代的 77.47% 直接拉升到 91.66%。
- 效率对比:在 A100 上使用 FastDeploy 后端,吞吐量达到 2016.6 tokens/s。相比于动辄秒级响应的大模型,这对于需要处理百万级报表的 RAG 系统来说是质的飞跃。
- 新能力扩展:新增了对印章 (Seal Recognition) 的精准提取和端到端的 Text Spotting(Grounded OCR),支持 111 种语言。
深度洞察:数据还是效率?
PaddleOCR-VL-1.5 成功的秘密不仅在于架构,更在于其 不确定性感知聚类采样 (UACS) 训练策略。作者并没有盲目堆砌数据,而是使用模型对数据进行“体检”,专门挑出那些模型拿不准的“硬骨头”(Hard Cases)进行加权训练。这种 Uncertainty-Aware 的方法让只有 0.9B 规模的模型也能学到极其深刻的特征表征。
总结与局限
PaddleOCR-VL-1.5 用实力证明了 “小模型也能有强鲁棒性”。它不仅是目前 RAG 系统中提取结构化知识的最佳前端,也为端侧 OCR 设备提供了可行的技术路径。然而,模型目前在极其复杂的艺术文字和海量密集重叠印章识别上仍有提升空间。
由于其开源属性和全栈优化(FastDeploy, vLLM 支持),这无疑将成为 2026 年文档智能领域最受开发者关注的工具之一。