
Panda:突破混沌预测极限,动力系统基础模型的零样本进化
Panda: A pretrained forecast model for chaotic dynamics
本文提出了 Panda (Patched Attention for Nonlinear DynAmics),这是一个专门针对混沌动力系统预训练的全局预测模型。通过在 2万个由演化算法生成的合成混沌 ODE 系统上进行预训练,Panda 实现了对未知动力系统(包括实际实验数据和高维 PDE)的零样本(Zero-shot)预测,在保持短期精度的同时有效捕获了长期的统计特性。
TL;DR
混沌,不仅是物理界的难题,更是深度学习的“滑铁卢”。由德克萨斯大学奥斯汀分校研究团队提出的 Panda (Patched Attention for Nonlinear DynAmics) 是一款专门为非线性动力系统设计的预训练模型。它不再仅仅依赖于海量杂乱的时间序列,而是通过“人工进化”出的 20,000 个混沌微分方程进行预训练。结果显示,Panda 在零样本(Zero-shot)情况下,预测能力不仅横扫现有时间序列模型,甚至展示出了从低维 ODE 跨越到高维 PDE 的惊人“涌现”能力。
1. 痛点:为什么混沌是 AI 的禁区?
在科学机器学习(SciML)领域,混沌系统(如天气、流体、生物电流)的预测一直极其困难。其核心挑战在于:
- 指数级误差增长:动力学中著名的“蝴蝶效应”意味着模型任何细微的偏差都会随时间迅速扩大。
- 归纳偏置的缺失:传统的通用时间序列模型(如 Chronos, TimesFM)通常采用单变量建模,忽略了动力系统变量之间深刻的内部耦合(Channel Coupling)。
- 数据荒漠:高质量、带标注的真实混沌动力学数据极难获取且维度极高。
2. 方法论:用演化算法“制造”物理直觉
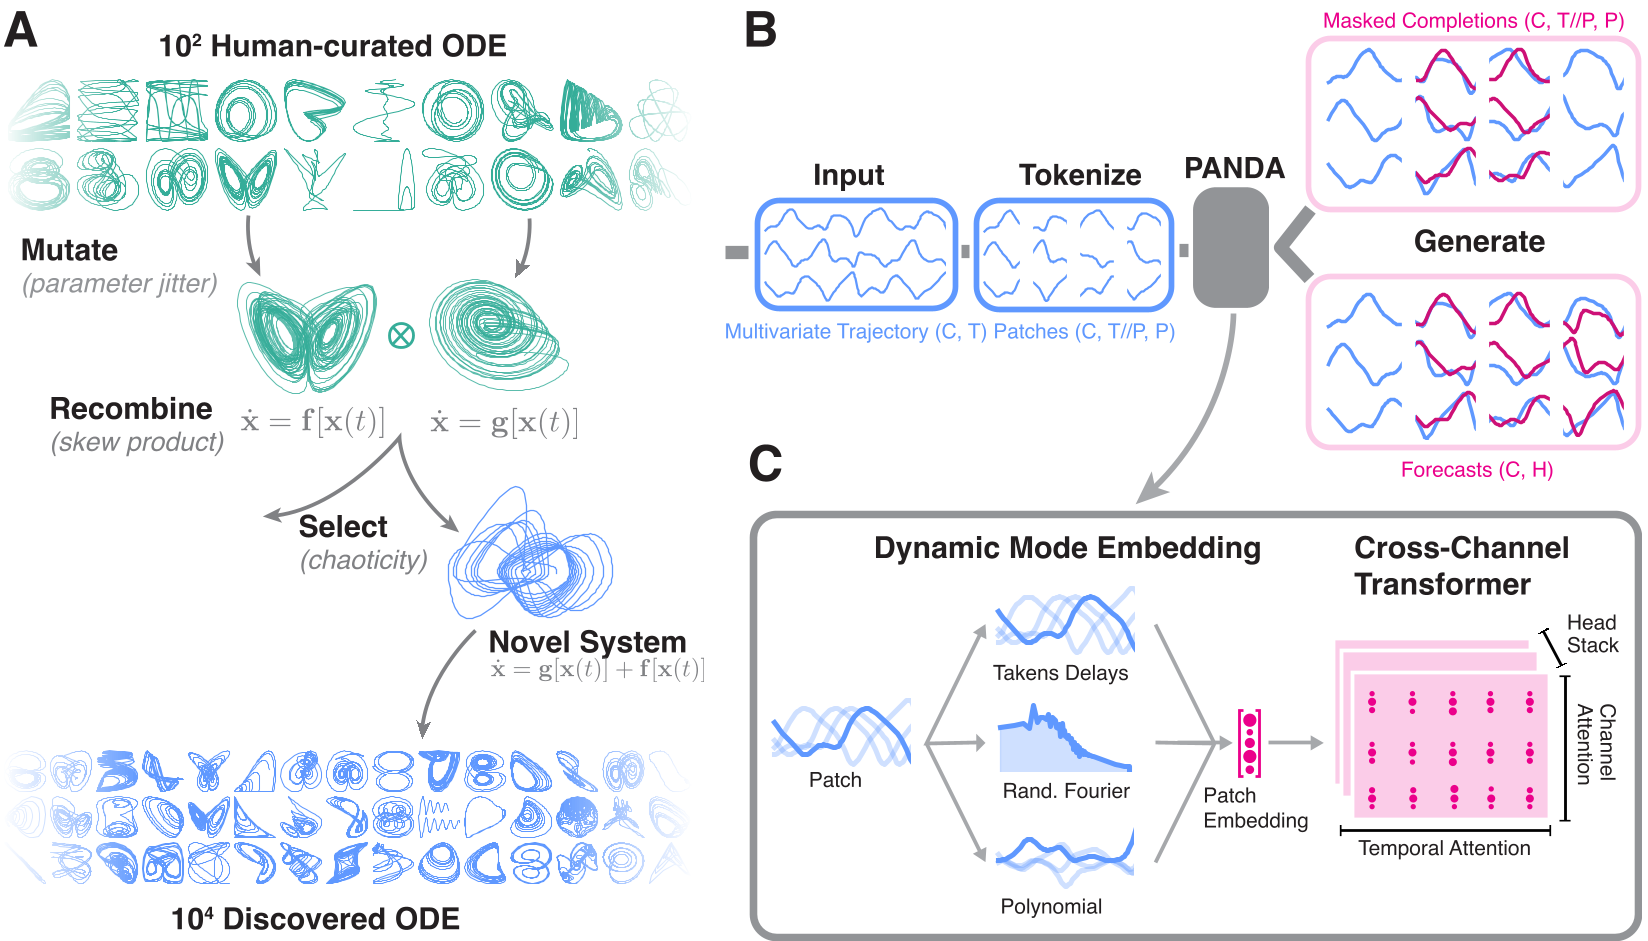
2.1 演化合成数据集
为了解决数据问题,作者没有去翻故纸堆,而是开发了一个进化框架:
- 种子池:从 129 个著名混沌系统(如 Lorenz, 双摆)开始。
- 变异与重组:通过加性斜积(Skew-product)耦合随机配对系统。
- 严苛筛选:只有通过“混沌 0-1 测试”、Recurrence 测试和 Lyapunov 指数验证的候选系统才能进入训练集。
2.2 Panda 架构解析
Panda 的设计深刻参考了动力系统理论(Dynamical Systems Theory):
- Patching (分块):基于 Takens 嵌入定理。该定理指出,低维测量的时间延迟副本可以保留原吸引子的拓扑特征。Panda 将序列分块作为 Token,本质上是在捕捉系统的局部流形几何。
- Dynamics Embedding:不仅使用线性投影,还加入了多项式和傅里叶特征。这被视为对 Koopman 算子 的近似,旨在将复杂的非线性动力学“提升”到线性特征空间进行处理。
- Channel Attention (跨通道注意力):这是 Panda 的灵魂。它显式地在不同变量间交换信息,捕捉非线性耦合效应。
3. 实验战绩:从 ODE 到 PDE 的降维打击
3.1 零样本泛化
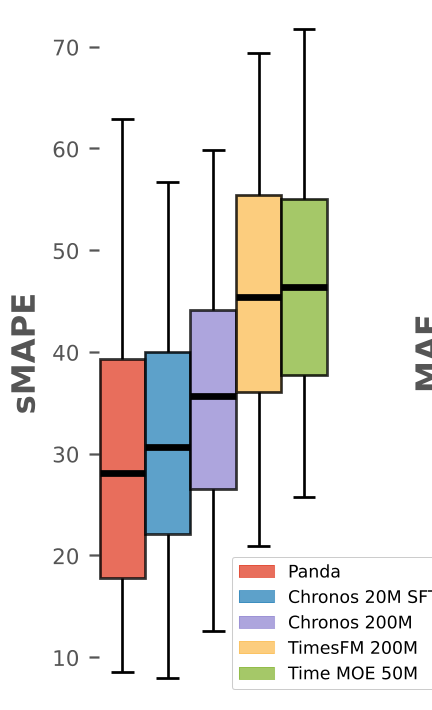
在面对完全陌生的混沌系统时,Panda 表现出了极强的韧性。实验显示,它的短期预测精度(sMAPE)显著优于同等规模甚至更大规模的 TSFM(Time Series Foundation Models)。
3.2 惊人的“跨界”能力
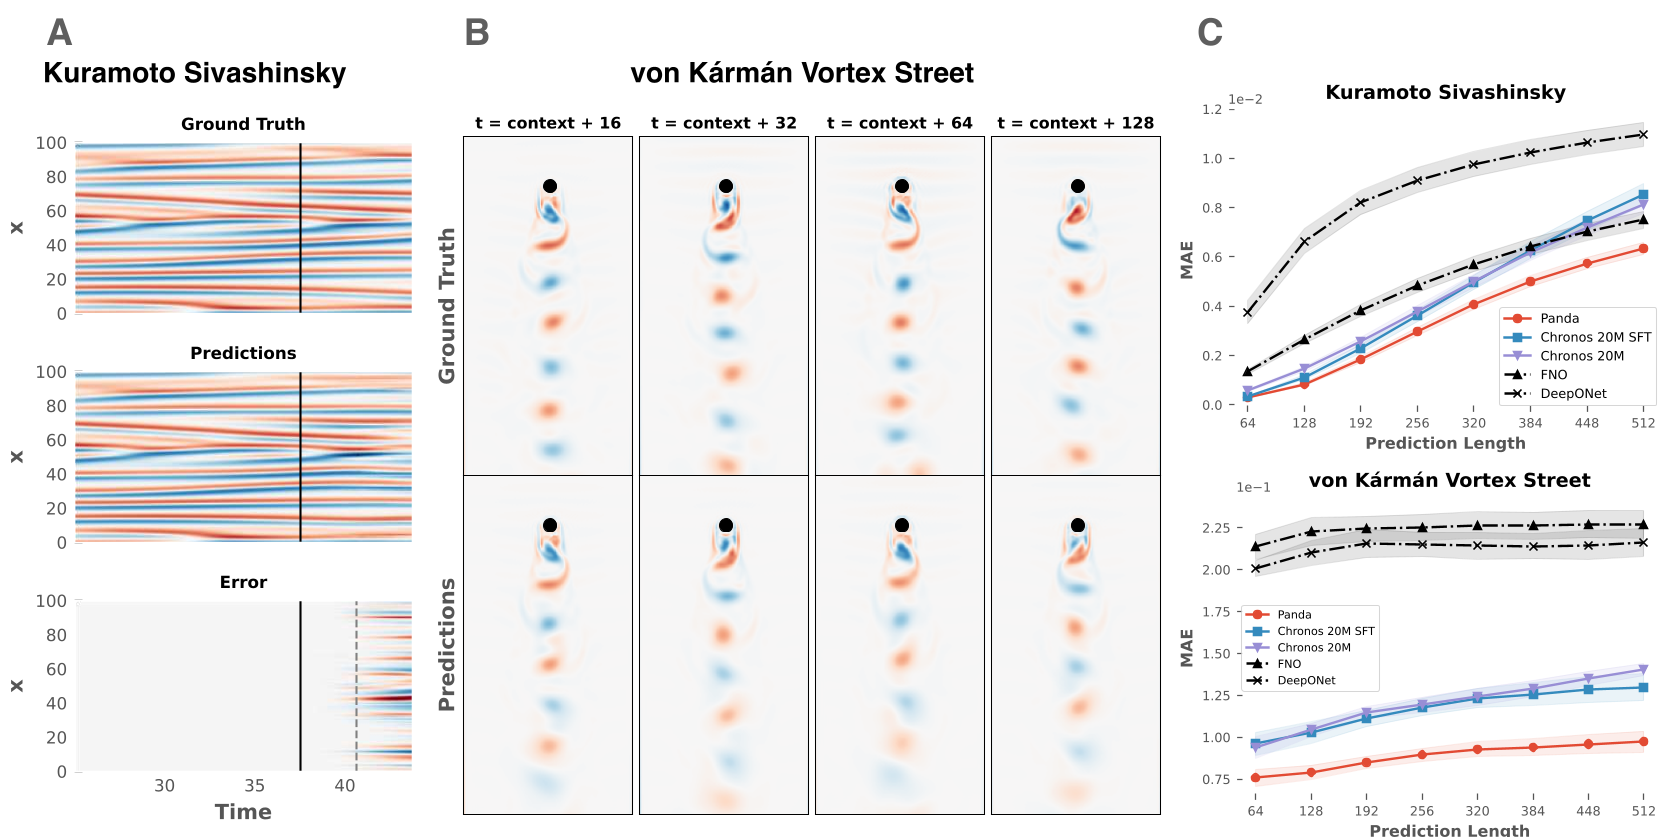
最令人感到震撼的是其**涌现(Emergence)**能力。尽管训练数据全部是低维的常微分方程(ODE),但 Panda 竟能直接预测复杂的偏微分方程(PDE)如 Kuramoto-Sivashinsky (KS) 过程。模型自发地掌握了火焰锋面合并、涡流脱落等复杂的非线性物理现象。
4. 深度洞察:为什么通道注意力如此关键?
在消融实验中,Panda 揭示了一个重要的物理启发:非线性谐振。 通过探查 Panda 的内部注意力图,研究者发现模型在处理混合频率输入时,其注意力头会展现出类似于物理系统中的“谐振模式”。这种结构在传统的单变量模型中完全不存在,说明 Panda 确实在学习动力学的“骨架”,而不仅仅是在拟合曲线。
5. 局限与未来
尽管 Panda 在预测混沌方面取得了长足进步,但它仍面临“回归均值”的挑战——在极长期的预测中,模型倾向于平滑化。此外,如何将这一架构扩展到处理工业级的超高维强湍流数据,仍是未来的研究重点。
总结
Panda 展示了科学 AI 的一种新路径:通过赋予模型深刻的数学归纳偏置,我们可以用合成数据培育出对真实世界具有深刻理解力的“物理大脑”。 这种跨领域的泛化能力,让我们离真正通用的“物理科学基础模型”又近了一步。