
Parallel-SFT:打破代码强化学习的编程语言壁垒
Parallel-SFT: Improving Zero-Shot Cross-Programming-Language Transfer for Code RL
本文提出了 Parallel-SFT 方法,旨在解决代码强化学习(Code RL)中零样本跨编程语言(Zero-Shot Cross-Programming-Language)迁移能力差的问题。通过在 SFT 阶段引入功能等价的“并行程序”数据,该方法在 Llama-3.1-8B 上显著提升了模型从高资源语言(如 Python)到低资源语言(如 Go, Ruby)的迁移性能,部分指标甚至超越了直接在目标语言上训练的 Oracle 模型。
TL;DR
Meta 与 MIT 的研究者发现,大模型在特定编程语言(PL)上通过强化学习(RL)获得的提升,很难“零样本”迁移到其他编程语言。为此,他们提出了 Parallel-SFT:在微调阶段通过合成的“并行程序”(同一功能的多种语言实现)来对齐模型的隐空间。实验证明,这不仅治好了 RL 的“转专业”难题,甚至让跨语言迁移的效果超过了直接在目标语言上训练。
背景定位:为什么代码 RL 难以“举一反三”?
在自然语言领域,我们在英文上微调模型,它的中文处理能力通常也会提升,这得益于预训练中大量的平行语料(翻译)。但编程语言是“孤独”的:
- 领域隔离:Python 常用于 AI,C++ 用于系统编程,Ruby 用于 Web,它们在训练数据中很难出现在同一个上下文中。
- 缺乏逻辑对齐:模型往往只学到了某种语言的 Syntax(语法),而没有触及跨语言通用的 Execution Logic(执行逻辑)。
结果就是:如果你在 Python 上用 RL 优化模型解决竞赛题,它在 Go 语言上的表现可能不仅没进步,反而因为“过度拟合 Python”而退步(Negative Transfer)。
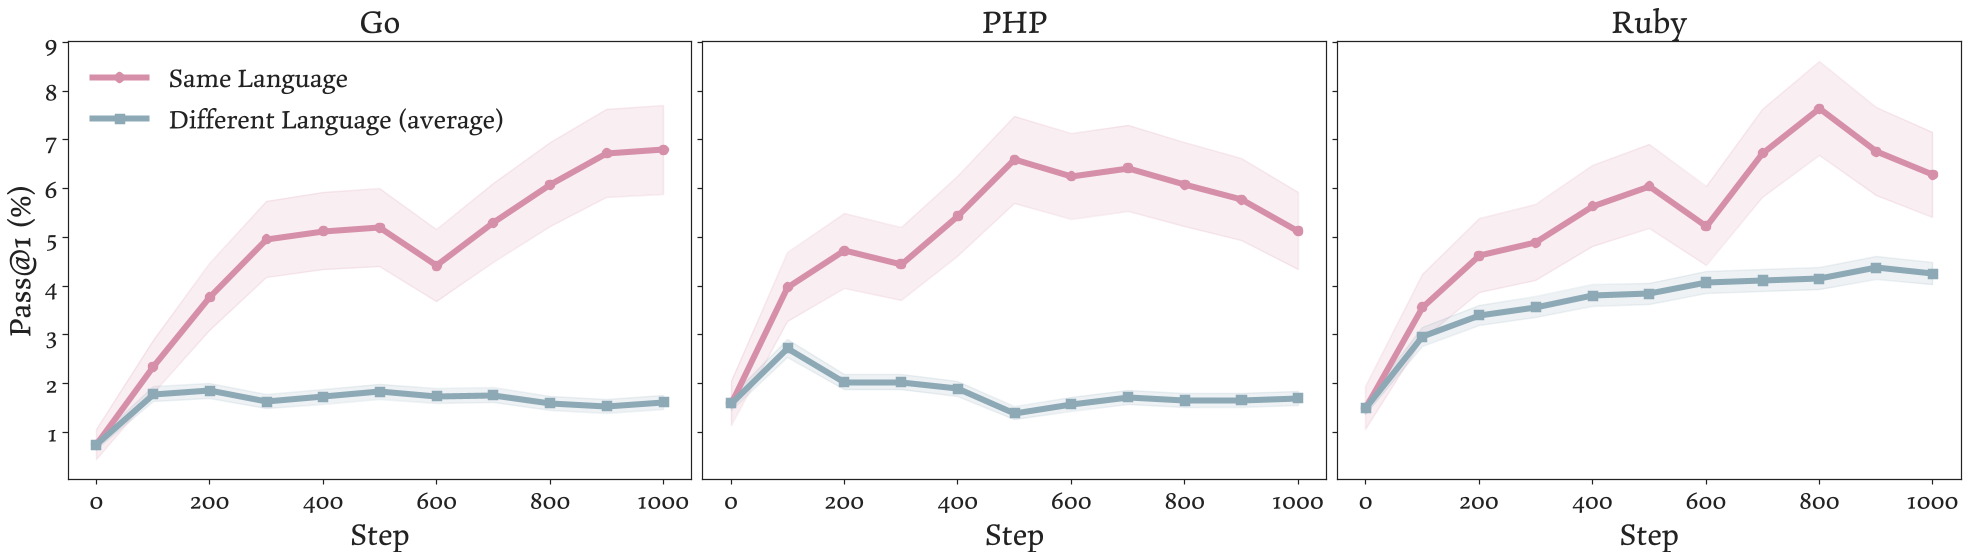 图:虽然在目标语言(如 Go)上直接 RL 效果很好,但从其他语言迁移过来的效果微乎其微甚至有害。
核心动机:寻找代码界的“罗塞塔石碑”
作者认为,要让 RL 能够迁移,模型必须在 SFT 阶段就具备 Language-General Representations(语言通用表示)。 受自然语言翻译的启发,作者提出:如果我们给模型看同一个问题的 8 种语言版本(如 Python, Java, C++, Go...),模型就会意识到:“噢!虽然这些代码长得不一样,但它们的灵魂(功能)是一样的。”
Methodology:Parallel-SFT 的三步走
- 数据合成:利用顶尖模型(Llama-4-Maverick 400B)将高质量的 Python 解题代码翻译成多种目标语言。
- 自动化验证:这步至关重要——所有生成的并行代码必须通过原始任务的测试用例(Test Cases),确保“执行等价”。
- 混合微调:将这些并行代码块交织在一起进行 SFT。模型不再只是学习
print("hello"),而是学习“输出字符串”这一概念在多种语言下的映射细节。
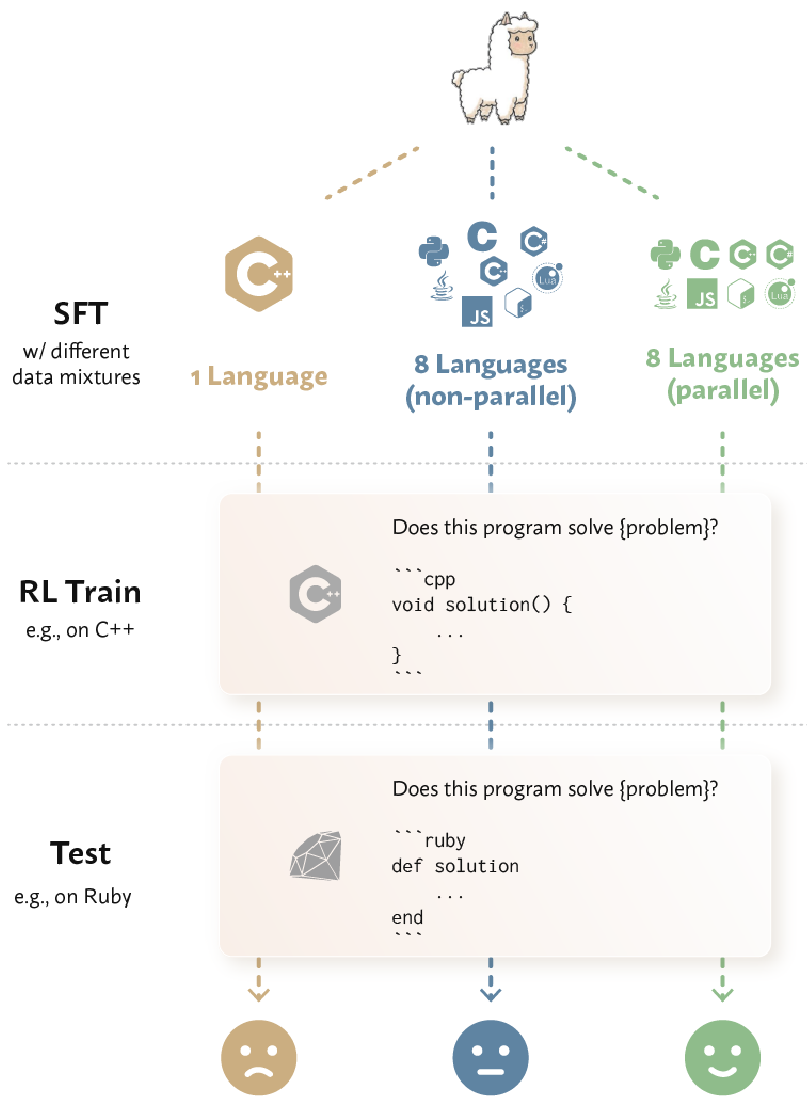 图:相比于单语言 SFT 或简单的多语言混合,Parallel-SFT 通过功能等价的代码对齐了表示空间。
实验结果:逆天的“跨级”挑战
研究团队在 CodeForces(竞赛编程) 和 代码验证 两个任务上进行了测试。
- 超越 Oracle:最令人惊讶的结果是,当从 Python 迁移到其他已知语言时,Parallel-SFT 后的模型在目标语言上的表现竟然超过了直接用目标语言训练的“先知”模型。这说明:高质量源语言的逻辑 + 并行对齐 > 低质量/由于数据稀疏导致的低效目标语言直接训练。
- 零样本突破:即使对于 SFT 阶段从未见过的编程语言(如 Go, PHP),Parallel-SFT 也展现出了极强的迁移韧性。
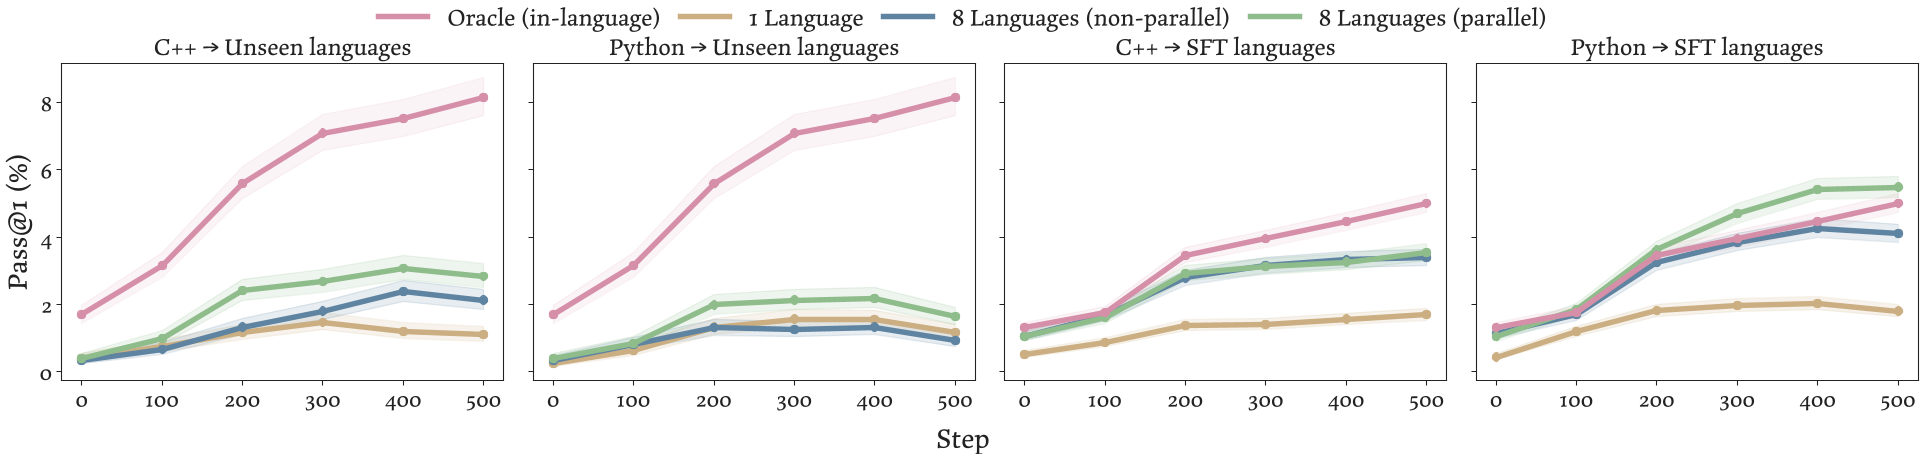 图:Parallel-SFT(红色线条)在所有迁移场景中均保持领先。
深度洞察:模型内部发生了什么?
作者对模型中间层进行了表征分析。他们发现,Parallel-SFT 显著增强了模型的 "Semantic Hub"(语义中心)。
- 相似度倒 U 型分布:在模型的中间层(Middle Layers),平行程序的表示相似度达到最高。这印证了学术界的一个猜想:底层负责处理语法,顶层负责预测 Token,而中间层才是真正进行“跨语言抽象思考”的地方。
- 功能驱动:Parallel-SFT 强迫模型将语法差异“抹平”,将注意力聚焦在解决问题的算法逻辑上。
总结与启示
Parallel-SFT 的成功告诉我们:“对齐”不应仅仅发生在人类偏好(RLHF)上,也应该发生在不同语言、不同模态的内在逻辑上。 对于开发者和研究者来说,这意味着:
- 不要过度迷信增加低资源语言的数据量,“高质量翻译对” 可能比单纯的“单语语料”更有效。
- 即使是 8B 的小模型,只要 SFT 阶段打好了“跨语言通用表示”的核心基础,它在 RL 阶段的爆发力也会远超预期。
未来,这一范式有望扩展到更多领域,比如让模型在学习数学证明时实现跨符号系统的无缝迁移。