
隐空间推理的 Scaling Law:为连续向量插上并行搜索的翅膀
Parallel Test-Time Scaling for Latent Reasoning Models
本文提出了针对隐空间推理(Latent Reasoning)模型的并行测试时扩展(Parallel Test-Time Scaling, TTS)框架。通过引入基于不确定性理论的 MC-Dropout 和加性高斯噪声(AGN)采样策略,并配合步进式对比学习训练的隐奖励模型(LatentRM),实现了在连续向量空间中高效、可扩展的推理路径生成与筛选。
TL;DR
传统的 LLM 推理通过生成多条“文本思维链”并投票来提升精度,但这在不产生文本、只在隐空间(Latent Space)推理的模型中一直无法实现。本文提出了一种全新的框架,通过 MC-Dropout 和 加性高斯噪声 (AGN) 在连续向量流中注入随机性,并构建 Latent Reward Model (LatentRM) 进行路径筛选,成功让隐空间推理模型也具备了“测试时算力扩展”的能力,实现了效率与精度的双重提升。
背景:当推理不再“说话”
在大模型领域,显性思维链(Explicit CoT)虽然效果好,但由于其逐 Token 生成的特性,计算开销巨大。近期,隐空间推理(Latent Reasoning / Continuous CoT) 成为前沿方向:模型不再输出自然语言,而是在隐藏层向量中完成思考。这种方法更接近人类直觉中的“闪念”,更高效,但也带来两个难题:
- 怎么采样? 文本生成有 Logits 概率,隐向量只是个定值,没法直接进行 Top-k 采样。
- 怎么选优? 没法通过文本概率算分,也没法用现成的过程奖赏模型(PRM)去评估一串向量的好坏。
核心方法:随机采样与路径估值
1. 连续空间的两种随机性
作者从不确定性估计算法获得启发,提出了两种注入扰动的方法:
- MC-Dropout (捕获认知不确定性):在推理阶段保持 Dropout 开启。这相当于每次推理都在采样模型权重的一个“随机子集”,适合挖掘需要复杂逻辑的难题。
- Additive Gaussian Noise (AGN, 捕获偶然不确定性):直接在隐向量上叠加等向高斯噪声。这类似于在原始思维周围进行“球形搜索”,在简单问题上表现得更稳健。
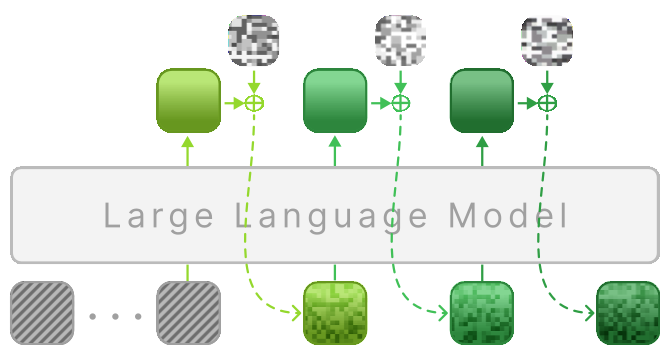 图 1:从 Token 采样到隐空间采样的跨越
2. LatentRM:隐向量的“裁判”
为了在一堆毫无意义的向量路径中选出正确的那条,作者设计了 LatentRM。
- 对比学习 (Contrastive Objective):不同于传统 PRM 只给对错打分,LatentRM 通过对比同一时间步下 N 个候选 Thought 的优劣,学习哪些向量更有可能导向正确答案。
- 累积评分:最终路径的质量由每一步评分的对数和决定,这为 Best-of-N 和 Beam Search 提供了决策依据。
实验发现:几何视角下的推理景观
通过 t-SNE 可视化(图 5),作者揭示了两种采样策略的本质差异:
- Dropout 产生的是具有方向性的漂移(Directional Drift),能够探索到离确定性路径很远的新区域,因此在处理 Hard Case 时更具潜力。
- AGN 则产生各向同性的径向色散(Isotropic Radial Dispersion),像烟花一样在中心点周围扩散,更适合在已知区域内进行微调多样化。
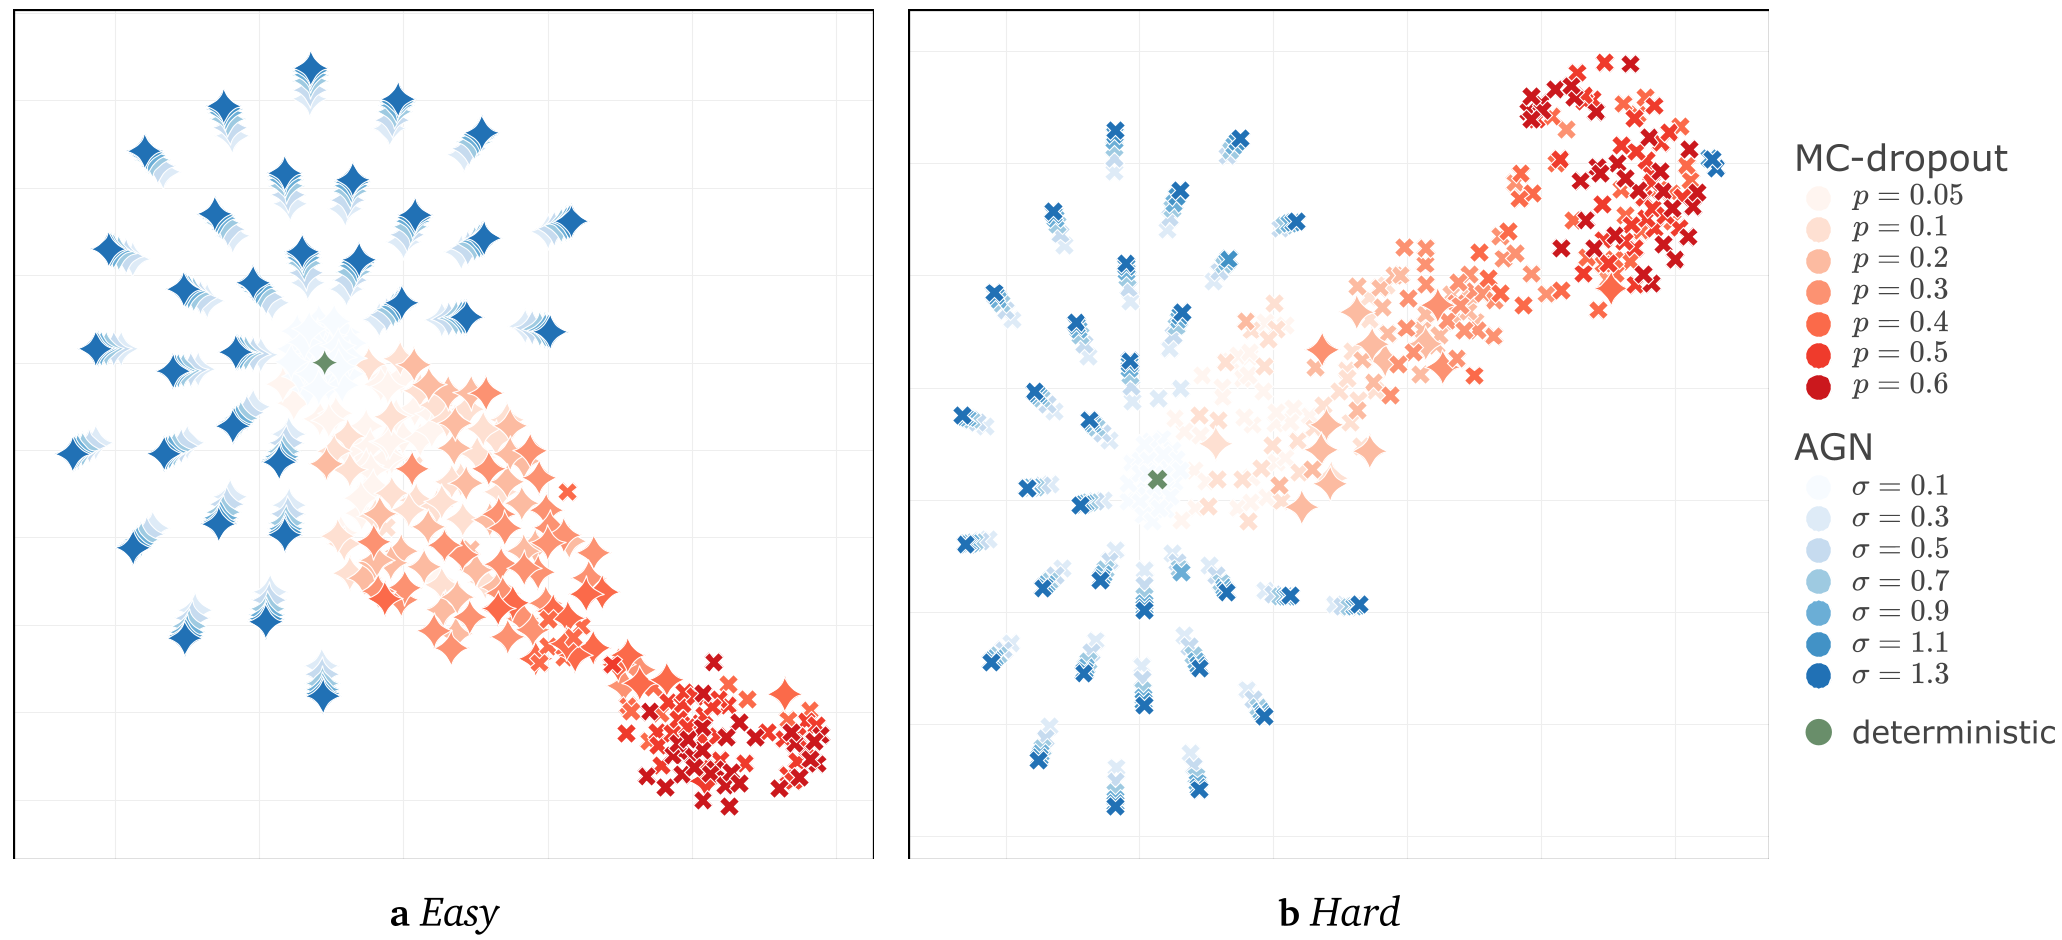 图 2:不同随机策略下的隐空间“推理景观”
性能表现:算力即能力
在 GSM-Test 和 GSM-Hard 等基准测试中,随着采样数量 N 的增加,模型表现出明显的性能扩展:
- 单调增长:无论是 GPT-2 还是 Llama-3.2-1B 骨干网络,通过增加测试时算力(TTS),准确率均稳步提升。
- LatentRM 的优越性:使用 LatentRM 引导的 Best-of-N 显著优于朴素的 Majority Voting,证明了该奖赏模型确实读懂了隐向量。
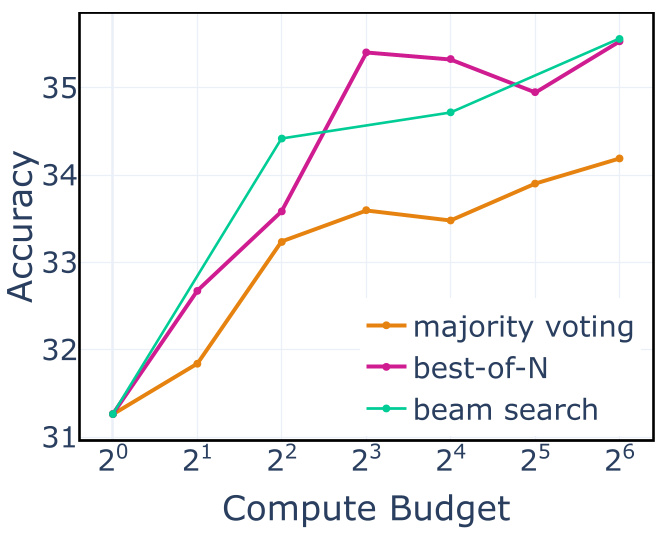 图 3:不同聚合策略下的性能扩展曲线
总结与思考
本文突破了“并行扩展必须基于文本采样”的固有思维,证明了在连续空间内同样存在可利用的 Scaling 维度。尽管目前的隐推理模型在绝对精度上尚不及超大规模的 o1 系列,但其极高的推理效率与灵活的扩展潜力,为端侧设备上的实时推理和更底层的多模态潜在生成提供了极具价值的参考。未来,将这一机制引入强化学习(RL)框架进行迭代优化,或许是通往“高效系统 2 思维”的关键路径。