
ParamMute:手术式抑制 FFN 层,让 RAG 系统告别“固执己见”
ParamMute: Suppressing Knowledge-Critical FFNs for Faithful Retrieval-Augmented Generation
本文提出了 ParamMute,一种旨在提升大语言模型(LLM)在检索增强生成(RAG)中忠实度的框架。通过识别并抑制与不忠实生成高度相关的特定中深层前馈网络(UA-FFNs),并结合知识偏好校准,有效解决了模型在外部证据与内部记忆冲突时“固执己见”的问题。
TL;DR
即使提供了正确的外部资料,LLM 仍可能根据“固有印象”胡说八道。清华大学与东北大学等机构的研究者发现,这与模型中深层的 FFN(前馈网络) 层的过度激活密切相关。他们提出的 ParamMute 框架通过抑制这些“不忠实关联层”并进行偏好校准,显著提升了模型对外部证据的忠实度,在多个基准测试中刷新了 SOTA。
1. 痛点:为什么 LLM 总是不听劝?
在检索增强生成(RAG)中,我们希望模型作为“复读机+逻辑分析仪”,严格基于给出的参考资料回答问题。但现实中,LLM 常表现得像个“犟驴”:
- 知识冲突:当检索到的资料与模型预训练时记下的内容不一致时,模型往往选择相信自己。
- 内部干扰:现有的改进方案(如 Prompt 工程)主要在“外部”下功夫,但模型体内的“参数记忆”依然在源源不断地产生干扰信号。
研究团队通过分析发现,模型的中深层 FFN 负责存储大量的参数化知识(Parametric Knowledge)。当这些层在生成时被异常高强度激活,模型就会陷入“自我意识”中,无视外部上下文。
2. 核心直觉:识别并静默“不忠实”的神经元
作者通过对比忠实回答与不忠实回答下的神经元激活模式,定位出了一组特定的 FFN 层,称之为 UA-FFNs (Unfaithfulness-Associated FFNs)。
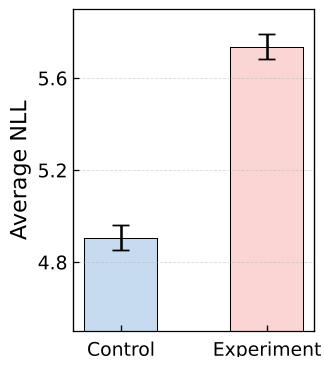 上图展示了 (a) 忠实与不忠实回答的激活gap,(b) 激活率与不忠实标签的正相关性,以及 (c) 抑制这些层后模型更难生成错误答案。
3. ParamMute:两阶段的“静音”疗法
ParamMute 的工作流程简洁而强大:
第一阶段:激活抑制 (Activation Suppression)
模型不再一视同仁地运行所有层。对于识别出的 UA-FFNs,引入一个抑制系数 : 通过将 调小(甚至为 0),我们可以直接切断这些内部记忆的动力来源,让模型“闭嘴”。
第二阶段:知识偏好校准 (Preference Optimization)
光让模型闭嘴还不够,还要教它如何依靠外部证据。ParamMute 使用了类似 DPO 的思想,通过 Knowledge Preference Optimization (KPO) 损失函数,强制模型在有上下文时,生成的概率要远高于无上下文时的概率。
(注:该图展示了从 FFN 定位到抑制再到偏好微调的完整流水线)
4. 实验战绩:全线飘红
为了验证效果,研究者构建了 CoFaithfulQA 基准,专门测试模型在知识冲突下的表现。
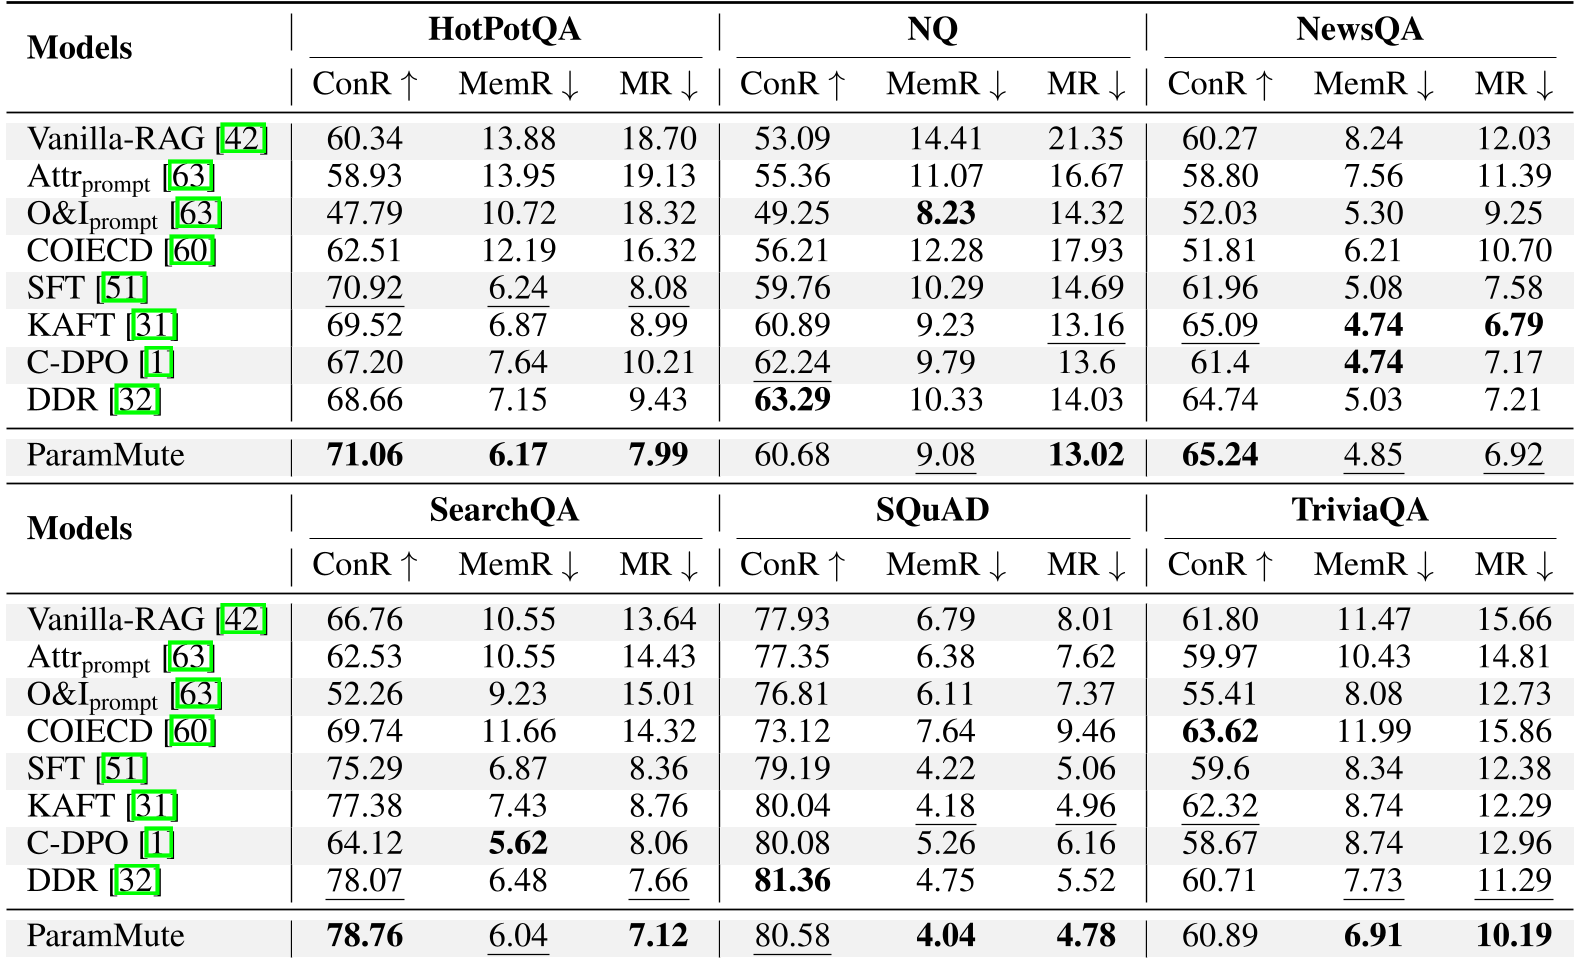
- 忠实度飙升:在 LLaMA3-8B 上,相比 Vanilla-RAG,ParamMute 在多项任务上的 ConR(上下文召回率)显著提升,而 MemR(对内部记忆的依赖)大幅下降。
- 极强的泛化性:在完全没见过的计数反事实数据集 ConFiQA 上,ParamMute 的表现甚至超过了专门针对该任务训练的基线模型,ConR 提升超过 50%。
5. 深度洞察:为什么手术有效?
通过消融实验,作者证明了抑制 FFN 比抑制注意力(MHA)或直接剪掉整层更有用。这意味着 FFN 确实是 LLM 的“知识盘”,而 UA-FFNs 则是那些容易产生干扰的“噪声源”。
有趣的是,实验还发现:模型规模越大,越容易依赖内部记忆。这意味着对于像 Llama-3-70B 这样的巨无霸,ParamMute 这种“参数去偏”的方法将变得至关重要。
6. 总结与反思
ParamMute 提供了一个迷人的视角:解决 LLM 幻觉不一定要靠更长的 Prompt 或更强的模型,有时候,给特定神经元“降降噪”反而能起到意想不到的效果。
局限性:
- 目前的抑制是层级的(Coarse-grained),未来如果能精确到单个神经元,效果可能会更恐怖。
- 对于检索本身完全失败(检索到的全是废话)的情况,盲目抑制内部知识可能会适得其反。
对于正在构建 RAG 应用的开发者来说,ParamMute 提醒我们:关注模型如何“平衡”内外部知识,比单纯堆砌向量数据库更底层、更有效。