
PaSa:像资深研究员一样调研,LLM Agent 重新定义学术论文搜索
Pasa: An llm agent for comprehensive academic paper search
本文推出了 PaSa,一种基于大语言模型的全自动学术论文搜索 Agent。该系统通过 Crawler(爬虫)和 Selector(筛选器)双代理协同工作,能够自主调用搜索工具、阅读文献并追踪引用网络,在复杂学术查询任务中显著超越了 Google Scholar 和 GPT-4o 等基线方法。
TL;DR
调研文献是科研的第一步,也是最痛苦的一步。ByteDance 与北京大学的研究团队推出了 PaSa (Paper Search Agent),一个能自主“顺藤摸瓜”的学术搜索智能体。它不仅会搜关键词,还能读懂论文、根据引用关系挖掘潜在文献。即便基于 7B 小模型,其搜索查全率(Recall)也大幅碾压了 GPT-4o 和 Google Scholar。
1. 痛点:为什么 Google Scholar 搜不准?
当你在搜索框输入“Which studies focused on non-stationary RL using value-based methods, specifically UCB-based?”时,现有的搜索引擎往往只能做到关键词匹配,难以处理这种多限制条件的联合查询。
核心动机: 人类研究员在调研时,不仅是搜索,更多是**“迭代挖掘”**:看到一篇好论文 -> 阅读其 Related Work -> 顺着引用找到更多高质量原文。PaSa 的目标就是完全模拟这一过程。
2. 核心架构:Crawler 与 Selector 的协同进化
PaSa 的精髓在于其双代理架构,这种设计实现了搜索任务中“广度”与“深度”的平衡。
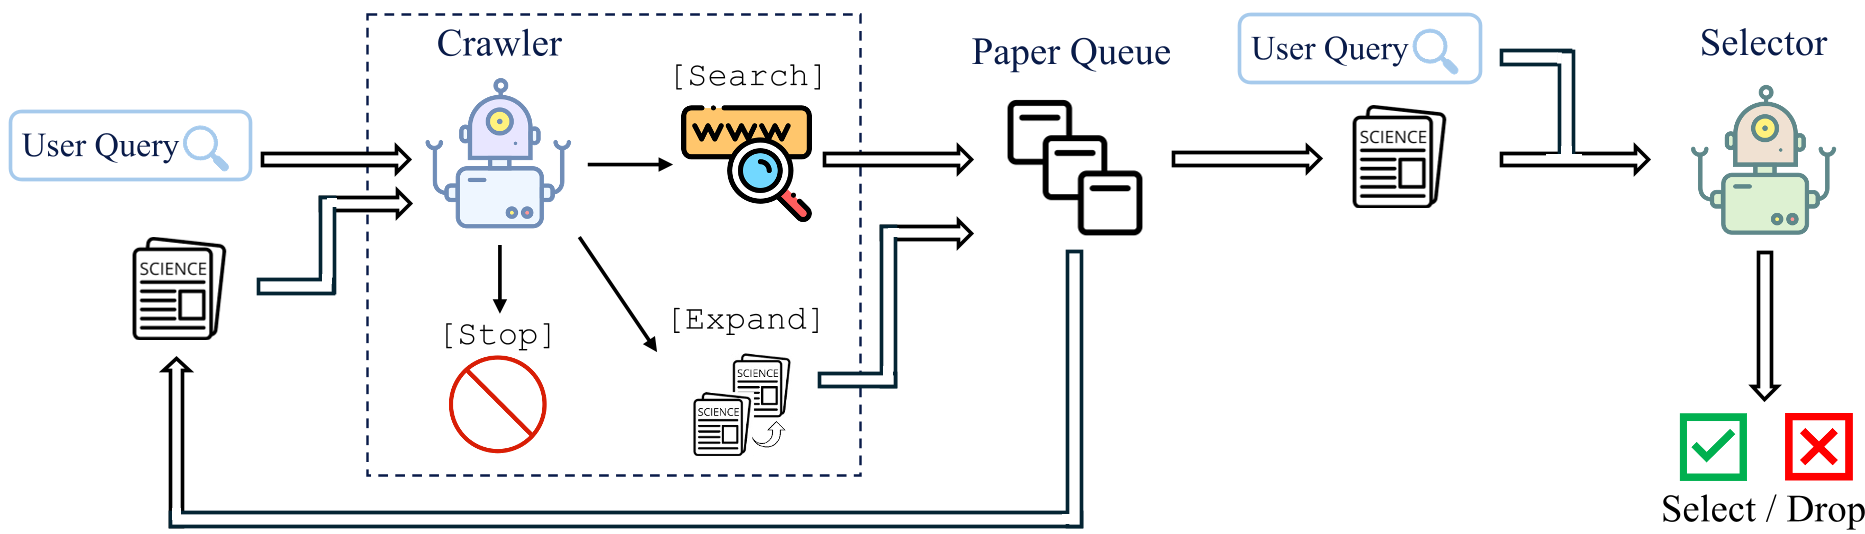
- Crawler (爬虫代理):它的任务是 Recall 极大化。它拥有三个武器:
[Search](生成多维查询词搜索)、[Expand](针对性挖掘当前论文的引用)和[Stop]。 - Selector (筛选代理):它的任务是 Precision 精确化。它阅读摘要和标题,先给出
Rationale(理由),再判定True/False。
创新的训练方案:Session-level PPO
传统的强化学习在处理这类长达数百步的搜索路径时会面临“梯度爆炸”或“奖励极其稀疏”的问题。PaSa 团队将长路径切分为多个 Session,并利用 Selector 作为辅助奖励模型,让模型在每一步“顺藤摸瓜”时都能得到即时正反馈。
3. 实验战绩:全方位超越基线
研究团队构建了两个硬核数据集:AutoScholarQuery(基于顶会论文 Related Work 合成的 3.5 万个查询)和 RealScholarQuery(由资深教授手动标注的真实科研问题)。
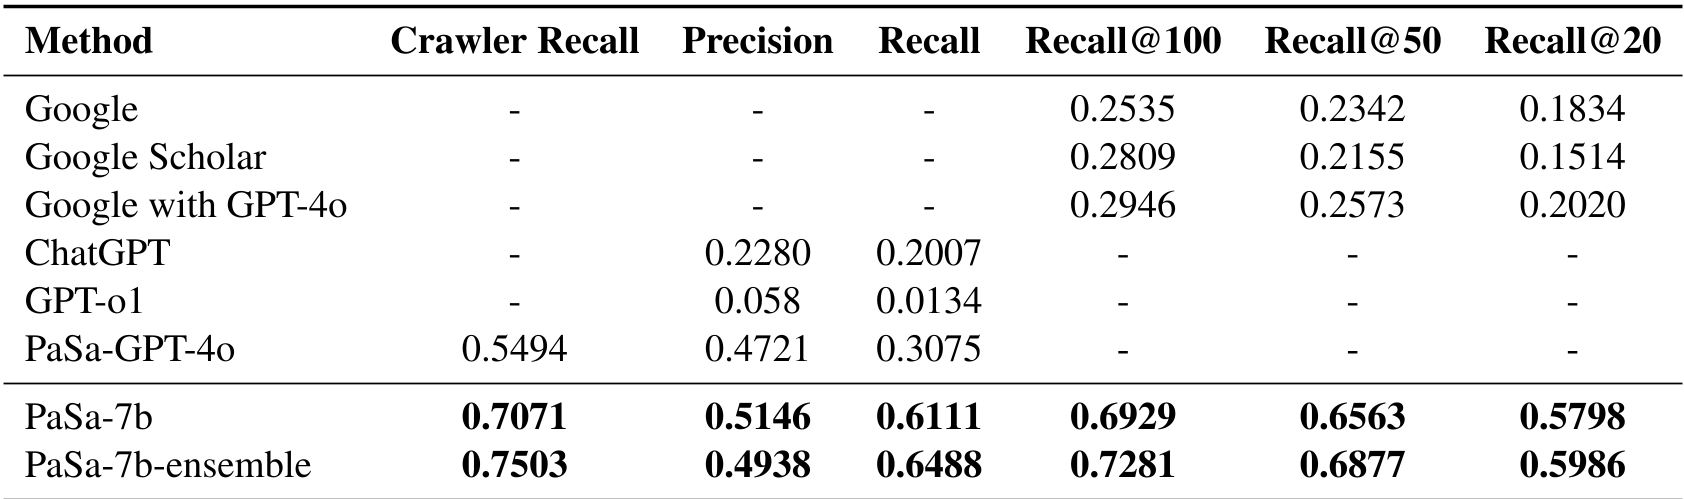
在 RealScholarQuery 的实测中,PaSa-7b 展现了惊人的统治力:
- 查全率碾压:Recall@50 达到 0.65,而 Google + GPT-4o 仅为 0.25。
- 小模型反超:即便 PaSa 只用了 7B 的 Qwen2.5 模型,其表现也优于直接用 Prompt 驱动的 GPT-4o (PaSa-GPT-4o)。这充分说明了针对性的 RL 训练比单纯的强大基座更有效。
4. 深度洞察:为什么 [Expand] 动作是关键?
在消融实验中,如果禁用 [Expand] 动作(即禁止模型挖掘引用),Recall 在真实场景下从 0.61 断崖式下跌至 0.28。
这验证了一个深刻的学术直觉:真正的核心论文往往隐藏在引用网络的深处,而非简单的搜索首页。 PaSa 通过自主决策哪些章节(Section)值得挖掘,成功复刻了科研人员“按图索骥”的直觉。
5. 总结与局限
PaSa 标志着学术辅助工具从“搜索时代”跨入“Agent 调研时代”。
- Takeaway:通过强化学习优化 Agent 的决策路径,可以使 7B 规模的模型在特定任务上获得超越千亿参数模型的性能。
- 局限性:目前 PaSa 主要针对 AI 领域进行优化,对于生物、材料等跨学科的长尾术语理解力仍待验证。
论文标题:PaSa: An LLM Agent for Comprehensive Academic Paper Search 关键词:LLM Agent, Reinforcement Learning, Paper Search, Academic RL 开源地址:https://github.com/bytedance/pasa