
从 Adam、Eve 到诺贝尔图灵挑战:AI 科学家(AI Scientists)的演进谱系与闭环架构蓝图
The Past and Future of AI Scientists
本文由机器人科学家(Robot Scientist)先驱 Ross D. King 撰写,系统梳理了从 DENDRAL、Adam、Eve 到大语言模型(LLM)驱动的自主实验室等“AI 科学家(AI Scientists)”的发展谱系。文章构建了贯穿形式化知识、符号演绎、概率推理、神经学习与自动化实验闭环的统一架构蓝图,并设立了在 2050 年前实现具备诺贝尔奖级自主发现能力(Nobel Turing Challenge)的技术演进路径。
核心速览 (Executive Summary)
- TL;DR:剑桥大学与查尔姆斯理工大学教授、机器人科学家之父 Ross D. King 带来了关于“AI 科学家(AI Scientists)”历史与未来的重磅综述。文章明确指出,单独科学任务的自动化(预测、文献检索、代码生成、单点实验优化)已被攻克,当前最核心的技术瓶颈在于全流程闭环集成(Integration)。论文提出了融合神经表征、一阶逻辑、概率信念状态、因果推断与物理实验室控制的统一神经-符号-概率架构,并制定了迈向 2050 年“诺贝尔图灵挑战(Nobel Turing Challenge)”的 6 级自主性演进路线图。
- 背景定位:这是 AI for Science 领域由开拓者撰写的纲领性愿景之作,它超越了当前将 LLM 简单封装为科研助手(Agents)的初级叙事,在哲学、数学、计算与实验四个维度确立了自主科学发现系统的学术坐标系。
痛点与动机 (Problem & Motivation)
科学研究自 17 世纪科学革命以来一直受限于人类自身的生理与认知极限:单篇论文篇幅受人类阅读量约束、科研团队规模受协同损耗限制、学科壁垒使得跨领域知识难以交融。为应对气候变化、耐药性、新材料设计等复杂挑战,科学生产力亟需发生范式跃迁。
然而,现现阶段的 AI for Science 体系存在严重的割裂与局部最优:
- 预测模型不等于科学发现:以 AlphaFold 为代表的判别/生成式深度学习模型在单点任务上达到超人水准,但它们属于人类定义好问题与输入输出的被动工具,无法自主提出解释性假设或重构概念体系。
- LLM 智能体停留在“文字游戏与代码孤岛”:近期涌现的多智能体科研系统(如 The AI Scientist、ChemCrow)虽能自主编写代码和生成论文,但容易陷入“幻觉(Hallucination)”,且其产出的洞见高度受限于既有代码库或在现有文献中“内卷”,缺乏提出根本性本体论创新(Ontological Innovation)与因果解释的能力。
- 自驱动实验室(SDLs)缺乏显式假设引导:现有的自动化实验室大多基于纯数据驱动的贝叶斯优化(Bayesian Optimization)进行参数搜索(如配方优化、产率提升),往往“知其然不知其所以然”,无法通过物理实验对竞争性科学理论进行因果判决与信念更新。
真正的科学研究是一个**“从知识到问题、从问题到假设、从假设到实验、从观测数据再到信念修正”**的闭环。任何一个环节的脱节,都会使系统退化为普通工具。
方法论详解:神经-符号-概率集成的 AI 科学家架构
为了实现真正的科学自动化,作者系统性地总结了从 2004 年全球首个能够独立形成假设并执行物理实验的机器人科学家 Adam,到专注于高通量活性学习药物筛选的 Eve 的演进历程,并绘制了未来通用 AI 科学家的模块化联邦架构。
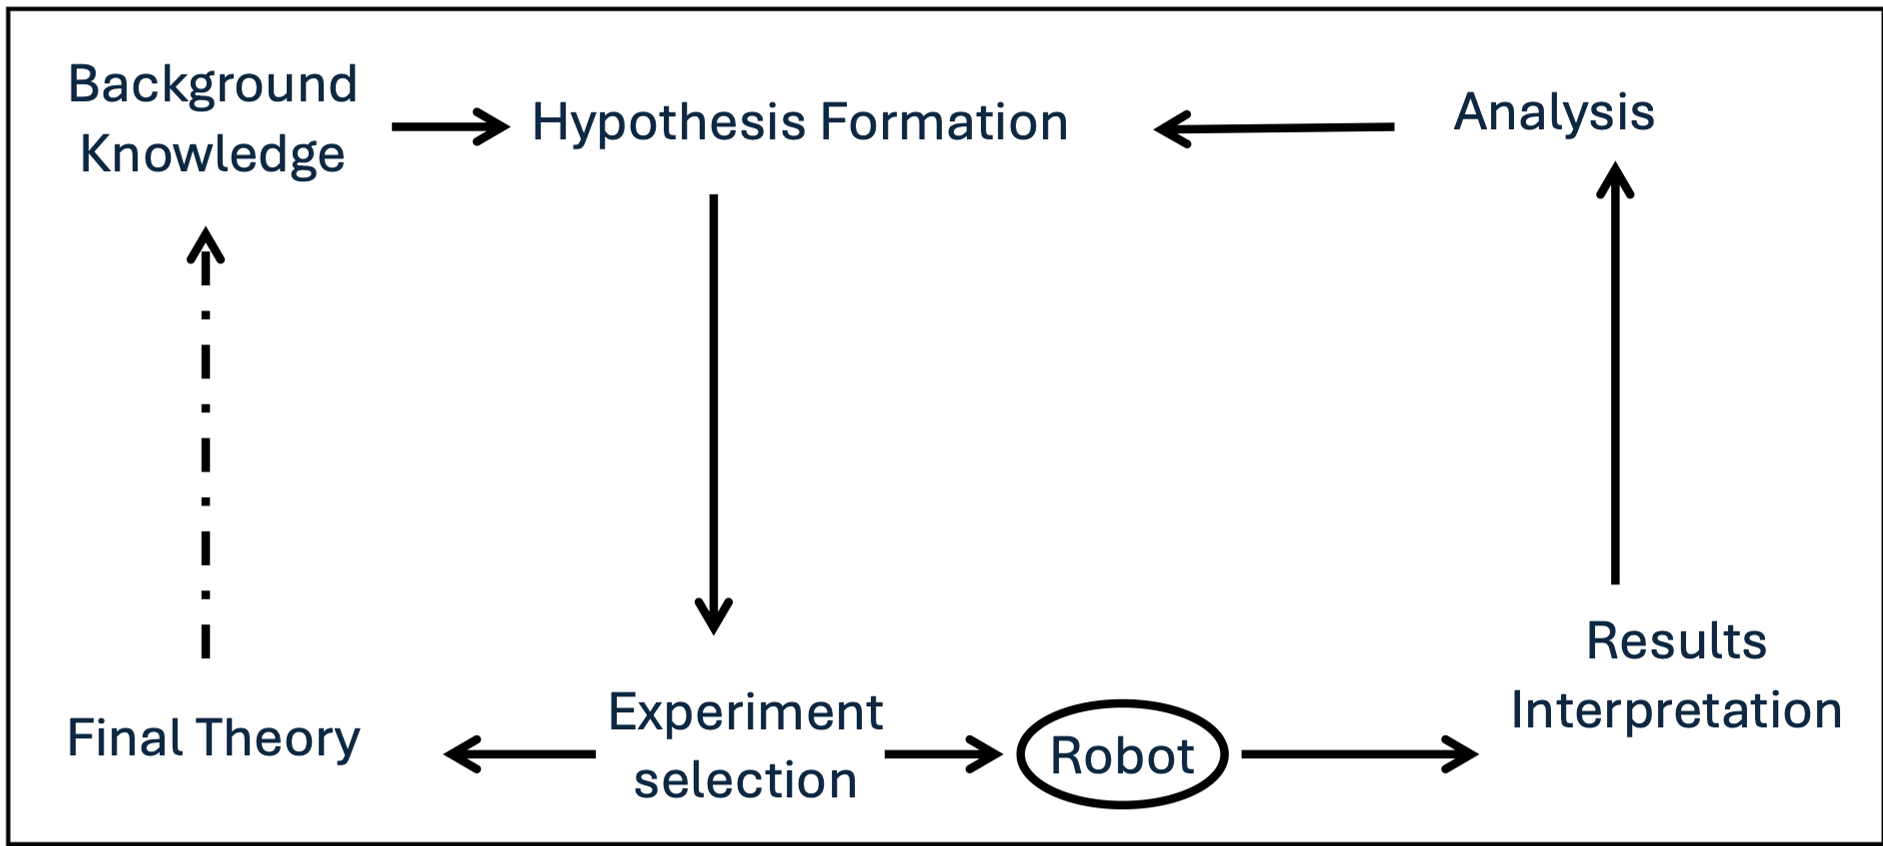
1. 核心架构设计:模块化联邦体系
未来的 AI 科学家绝非单一的超大参数端到端模型,而是一个由多智能体协作、显式知识驱动的模块化联邦(Federation of Interacting Modules)。
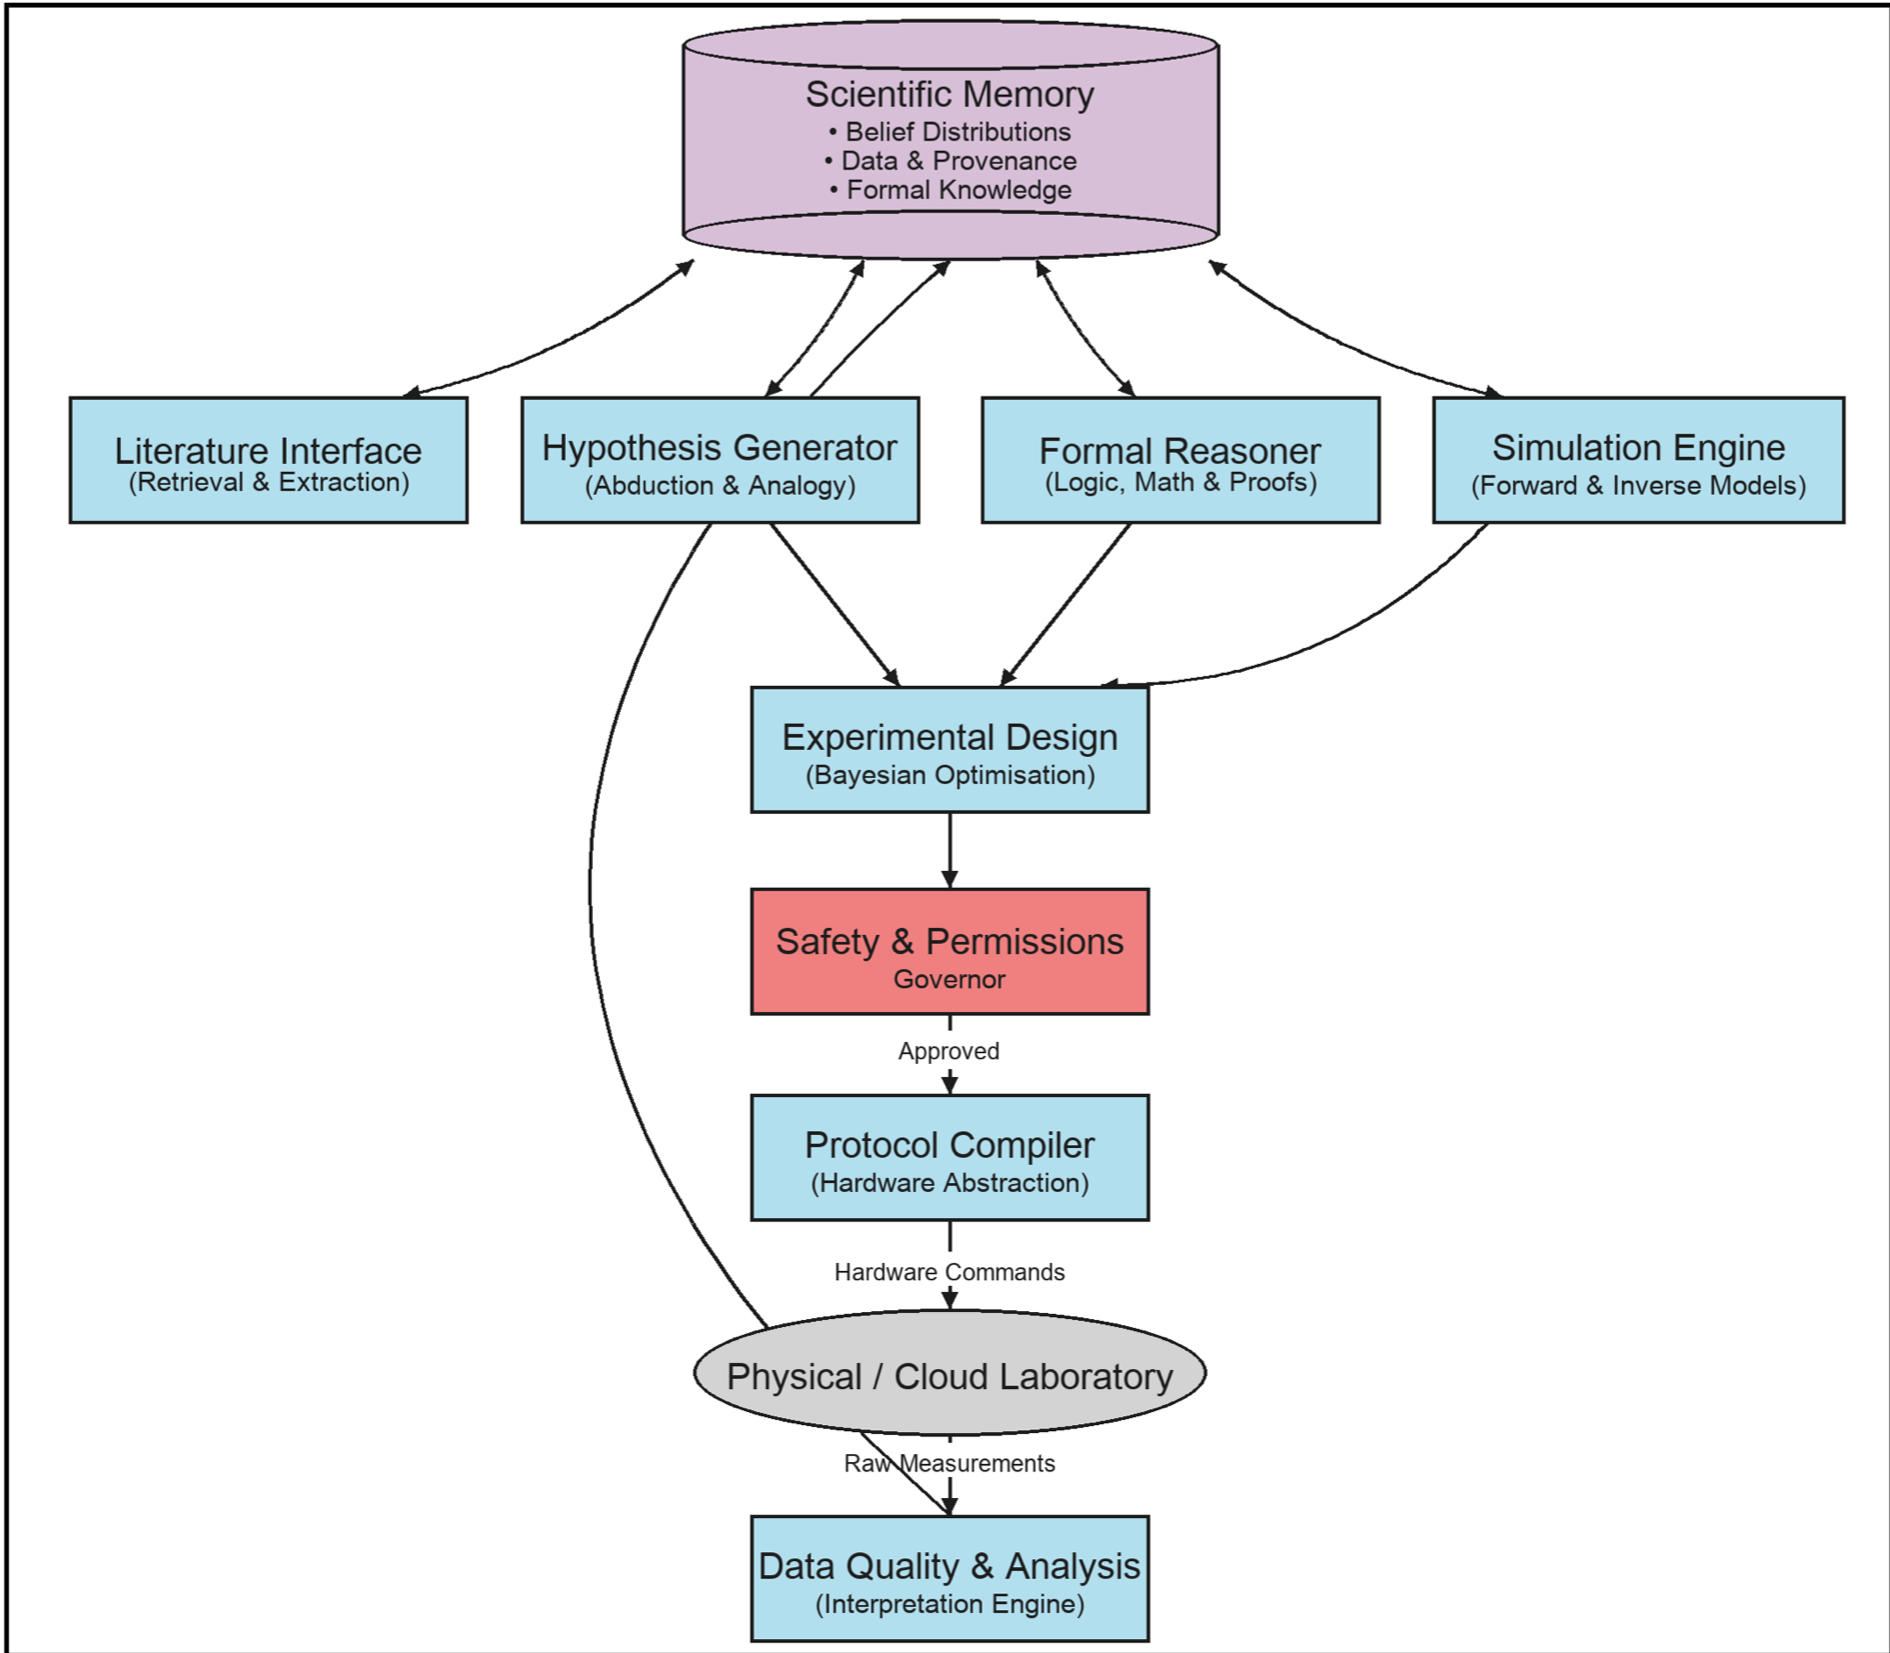
该架构包含以下关键中枢:
- 科学记忆中枢(Scientific Memory):维护显式本体知识图谱与动态概率置信状态(Probabilistic Belief State),对竞争模型保持未归一化的后验分布,严格记录全流程数据凭据(Data Provenance)。
- 神经-符号反绎引擎(Neuro-Symbolic Abduction & Predicate Invention):通过 LLM 的宽泛常识触发假设生成,由归纳逻辑编程(ILP)与形式化一阶逻辑系统检验其逻辑一致性,实现新概念谓词的创造。
- 因果干预与贝叶斯实验设计(Causal Interventions & Active Learning):结合 Pearl 的 -calculus,系统区分被动关联观测与主动因果干预,利用最小消息长度(Minimum Message Length, MML)和主动学习目标函数: 在实验成本 与区分不同假设 的期望信息增益之间实现帕累托最优决策。
- 物理协议编译器与硬件抽象层:将高层科学意图经由本体(EXPO/LabOP)逐层编译为领域执行语言(如化学合成领域的 XDL),通过 PyLabRobot 和 SiLA 2 标准驱动物理机器人执行实验。
实验体系与系统演进图谱 (Taxonomy & Benchmarking)
作者根据自主性、环境交互形式及理论更新能力,对代表性系统进行了严格的分类学审视:
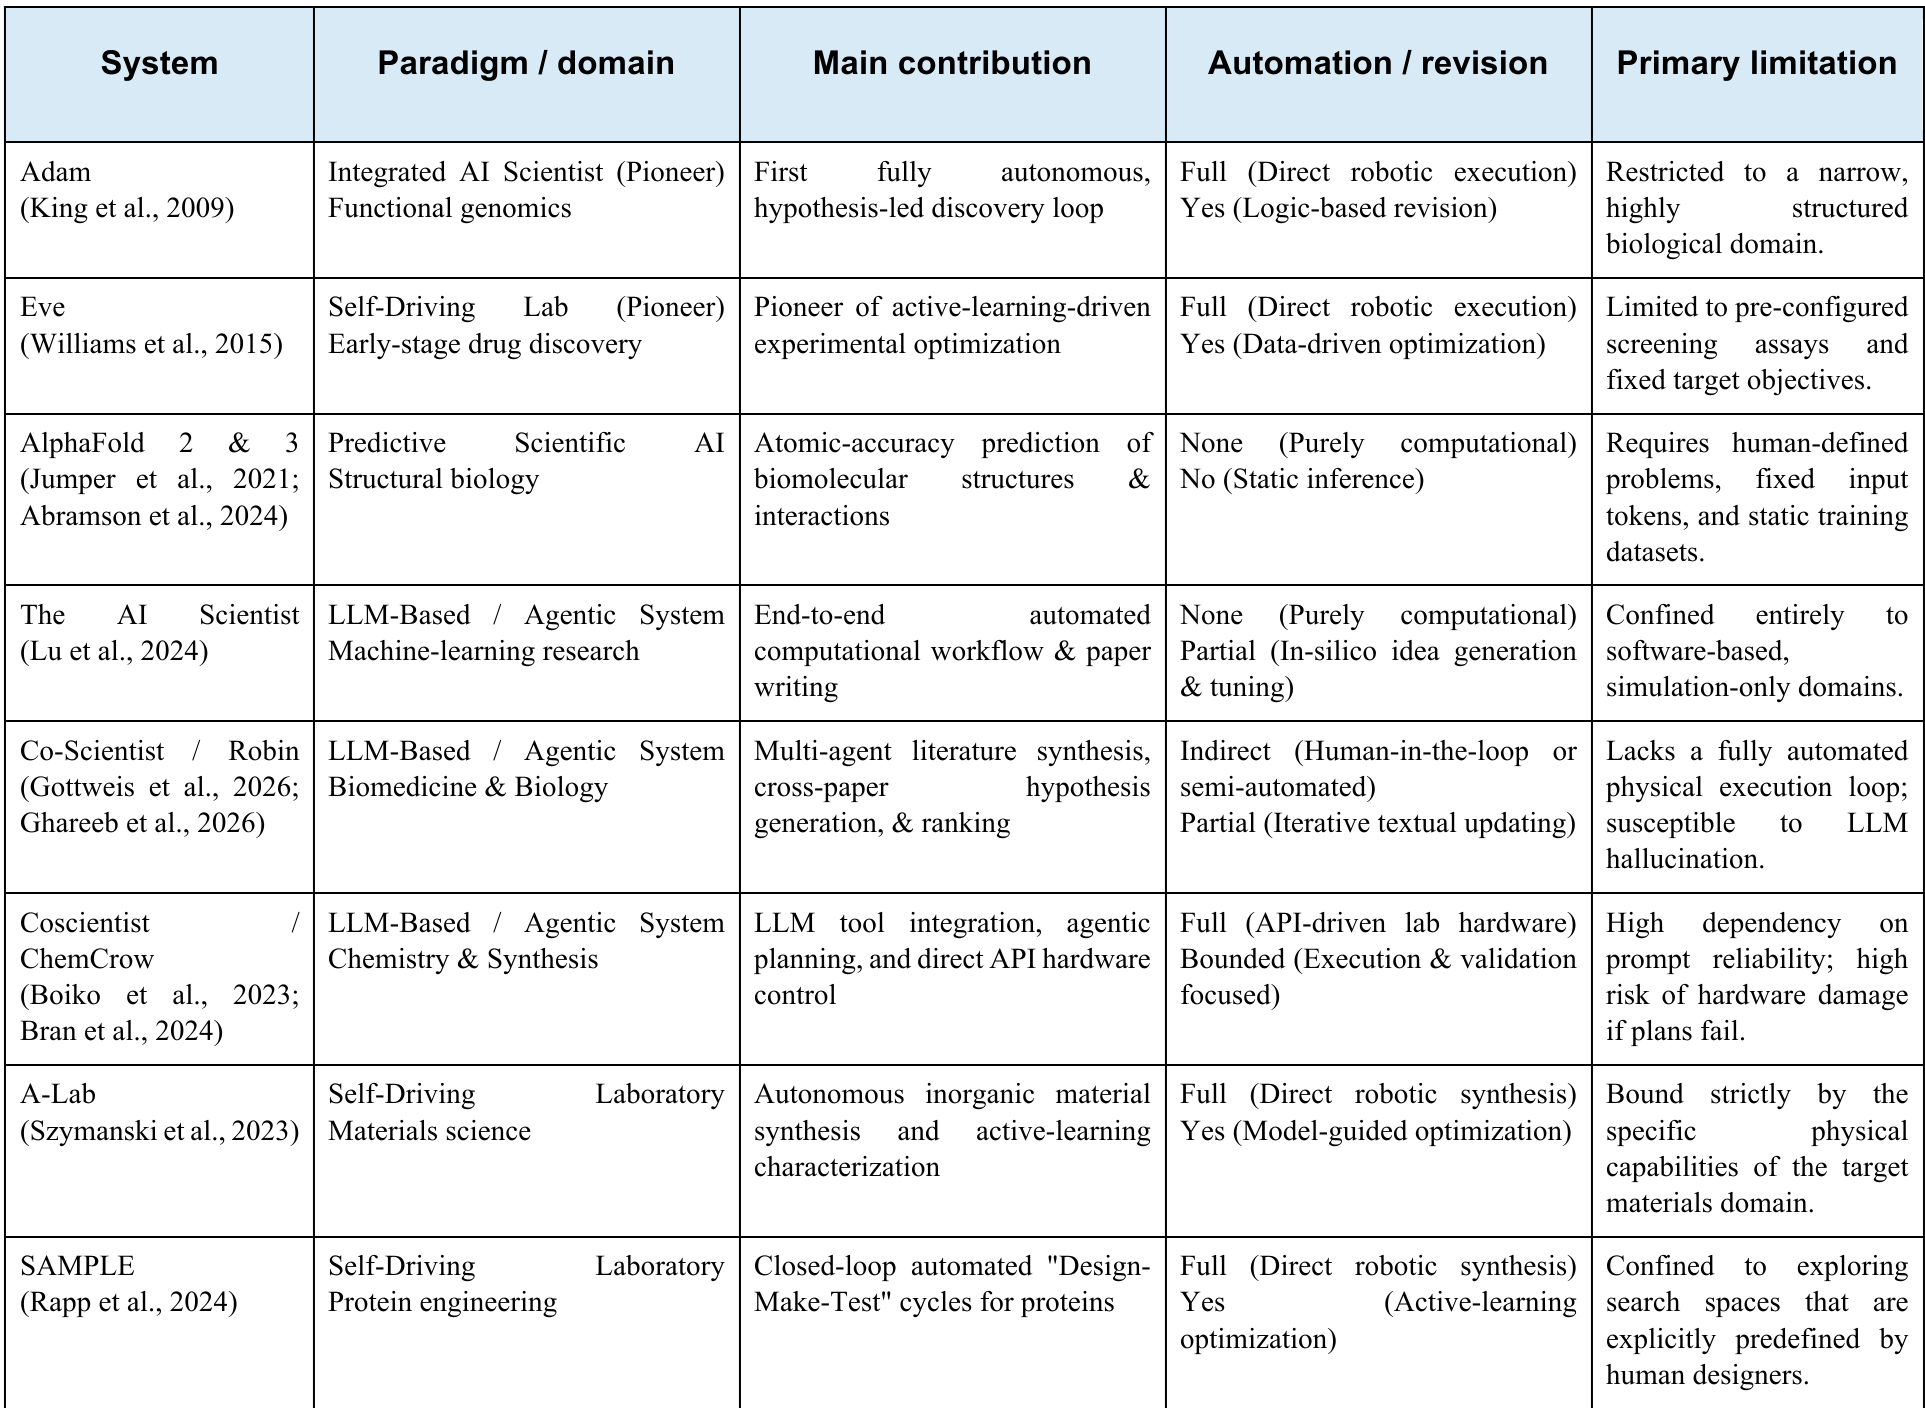
科学自主性分级 (Levels of Scientific Autonomy)
借鉴自动驾驶分级,作者提出了统一的科学自主性 6 级框架:
- Level 0(无自主性):常规计算工具(如 计算器、BLAST 检索)。
- Level 1(任务级自主):单点任务自动化(如 AlphaFold 预测结构、文献解析)。
- Level 2(工作流级自主):多步骤计算流水线集成,但每个关键节点需人类深度介入与筛选。
- Level 3(闭环受限自主):在人类预设的固定实验空间内自主完成“选实验-执行-测定-更新模型”(如 A-Lab、SAMPLE、Eve)。
- Level 4(研究项目级自主):在宽泛领域内自主拆解子课题、提出全新假设并协调跨实验室执行(如 先进的 Adam 衍生系统)。
- Level 5(开放式完全自主):能够自主捕捉科学反常(Anomalies)、发明全新实验范式与仪器、独立推动范式革命。
深度洞察与诺贝尔图灵挑战 (Critical Analysis & Future Work)
1. 核心理论见解
- 大自然的非对抗性(Nature is Honest):与金融、博弈和博弈对抗不同,物理世界的客观规律不会主动欺骗 AI。只要仪器校准完备,物理实验就是消解 LLM 幻觉的终极判决准则。
- 反驳波普尔(Popper)的纯粹证伪主义:在实际科研中,反常现象可能由仪器漂移、辅助假设错误或样本污染引起(Duhem-Quine 难题)。因此,AI 科学家必须依托贝叶斯模型比较与多层级不确定性度量,而非单次实验失败便彻底否定整个理论。
2. 核心局限性 (Limitations)
- 知识获取瓶颈向“暗数据(Dark Data)”转移:海量实验细节深锁于出版商付费墙后或非数字化的实验室纸质记录中。
- 硬件与算力物理瓶颈:边缘计算延迟、机器人微操作的灵巧度不足,以及高保真多物理场模拟带来的算力消耗,极大限制了自驱动实验室的扩展速度。
- 双重用途风险(Dual-Use Risks):当 AI 科学家被赋予自主采购原料与操控生化反应的能力时,必须构建硬隔离物理联锁(Physical Interlocks)与机器可读的伦理安全沙盒。
3. 诺贝尔图灵挑战(Nobel Turing Challenge)的评估基准
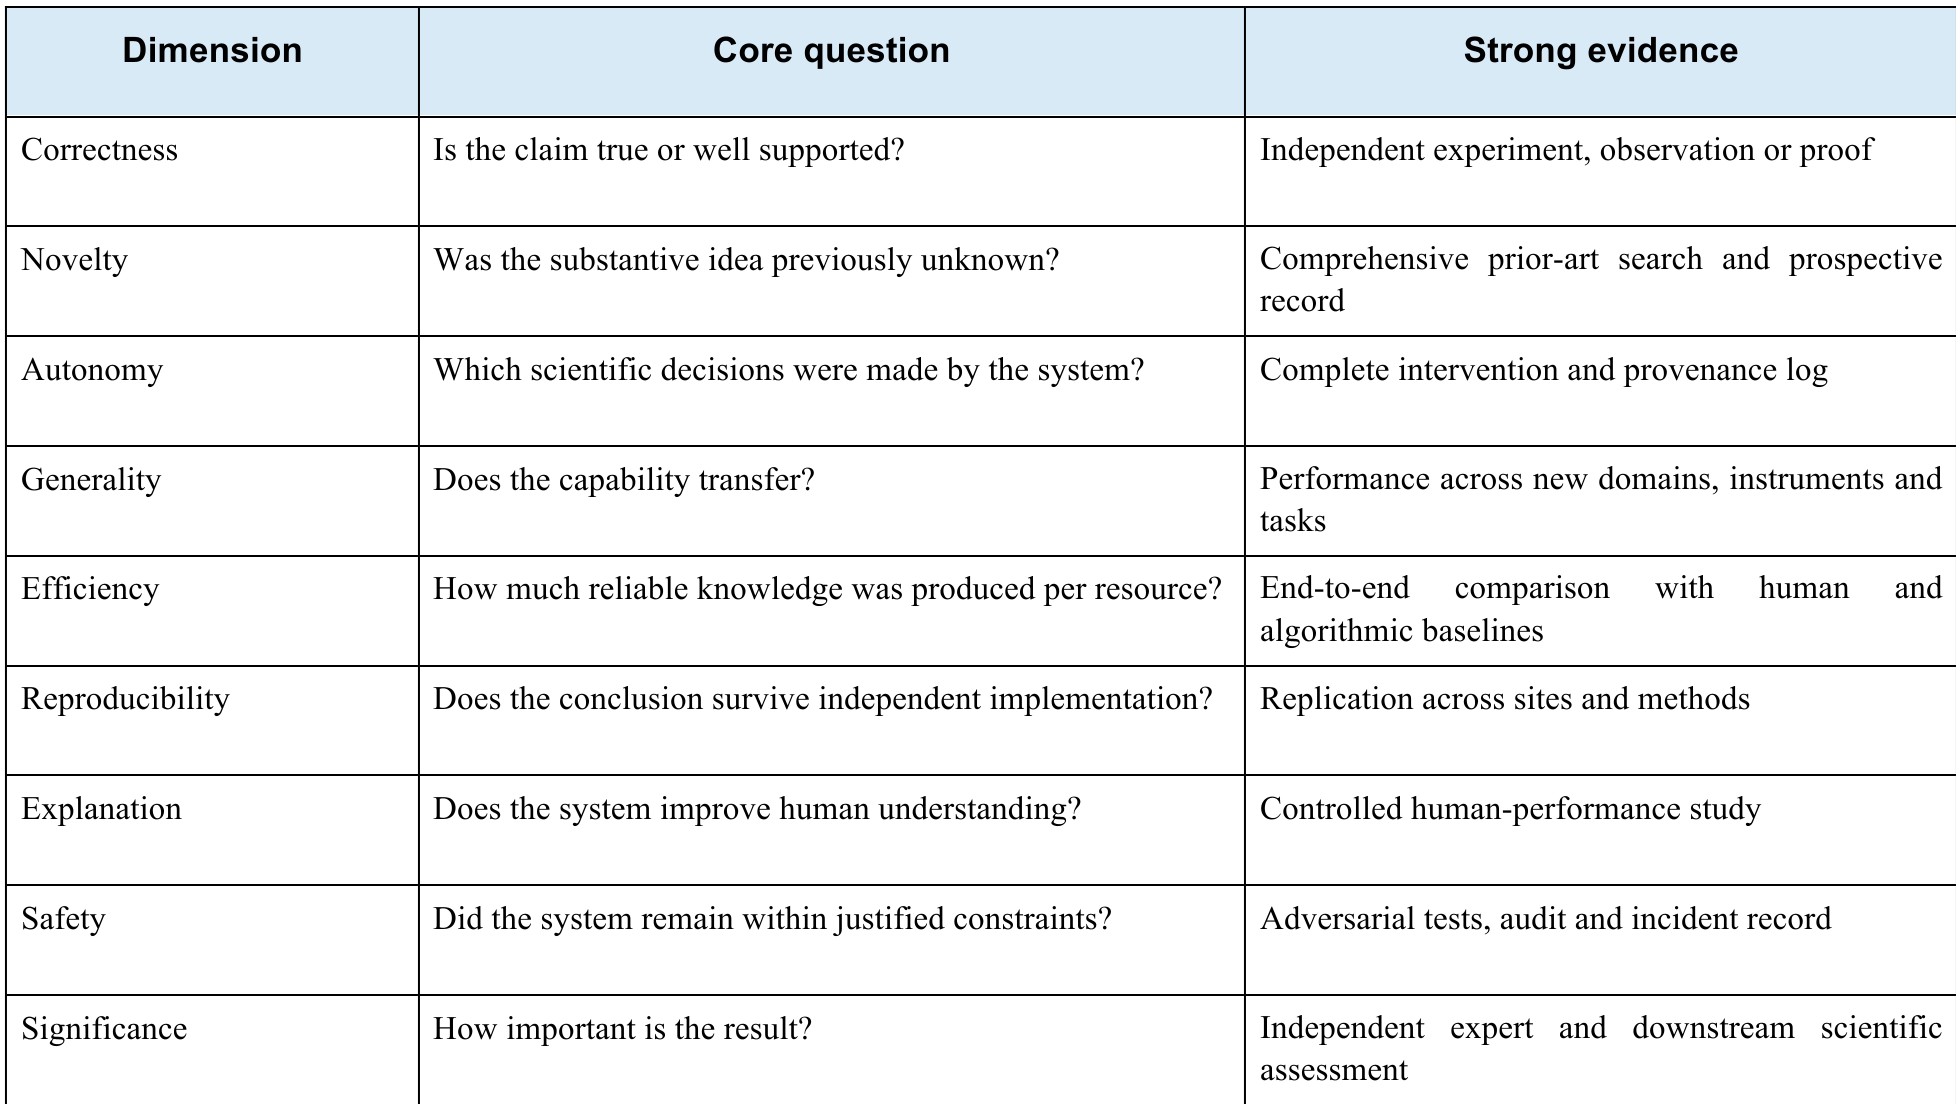
要在 2050 年前实现自动化产生诺奖级重大发现的目标,评估必须遵循**前瞻性(Prospective Discovery)**而非在训练集内的回顾性重现。正如 2026 年大模型在离散几何领域自主证伪 Erdős 平面单位距离猜想所展现的,可形式化验证的数理证明与独立实验室交叉复现将构成评价体系的黄金标准。
AI 不会取代科学家,但使用 AI 闭环体系的科学共同体必将彻底重塑人类探索未知的边疆。