
Peerispect:让审稿意见“有据可查”——学术评审的自动化事实核查新时代
Peerispect: Claim Verification in Scientific Peer Reviews
本文推出了 Peerispect,这是一个旨在实现学术同行评审(Peer Review)自动声明验证的交互式系统。该系统通过将审稿意见转化为针对论文全文的检索查询,利用语义检索(Retrieval)与自然语言推理(NLI)技术,自动验证审稿声明的真实性与准确性,并在 ICLR 数据集上达到了显著的验证效果。
TL;DR
在学术出版压力剧增的今天,审稿意见的不透明和误读已成为科研公平性的痛点。本文介绍的 Peerispect 系统,通过将审稿人的每一条评论(Claim)视为对论文原文的索引请求(Query),利用先进的检索与推理管道,实现了审稿意见的自动化事实核查。它不仅能指出审稿人是否“胡编乱造”,还能在 PDF 原文中高亮显示证据。
背景定位:科研完整性的“守门员”
学术同行评审是科学发展的基石,但审稿人也是人,难免产生 Misinterpretation(误解)或 Overstating Limitations(夸大缺陷)。Peerispect 的出现,将此前主要用于通用领域(如事实核查、谣言识别)的技术引入了高度专业化、私有化的“单文档验证”场景,是 IR(信息检索)技术在科学计量学领域的一次深耕。
痛点深挖:为何人工核实不再奏效?
随着 AI 等热点领域投稿量的爆炸式增长(如论文中提到的 AAAI 2026 投稿数增至 2.3 万篇),程序委员会(PC)几乎不可能逐一核实每一份审稿意见是否真的在原文中有据可依。现有的自动评估工具大多只关注评审的语气或建设性评价(Constructiveness),而忽略了最核心的事实准确性(Factuality)。
方法论详解:模块化的验证管道
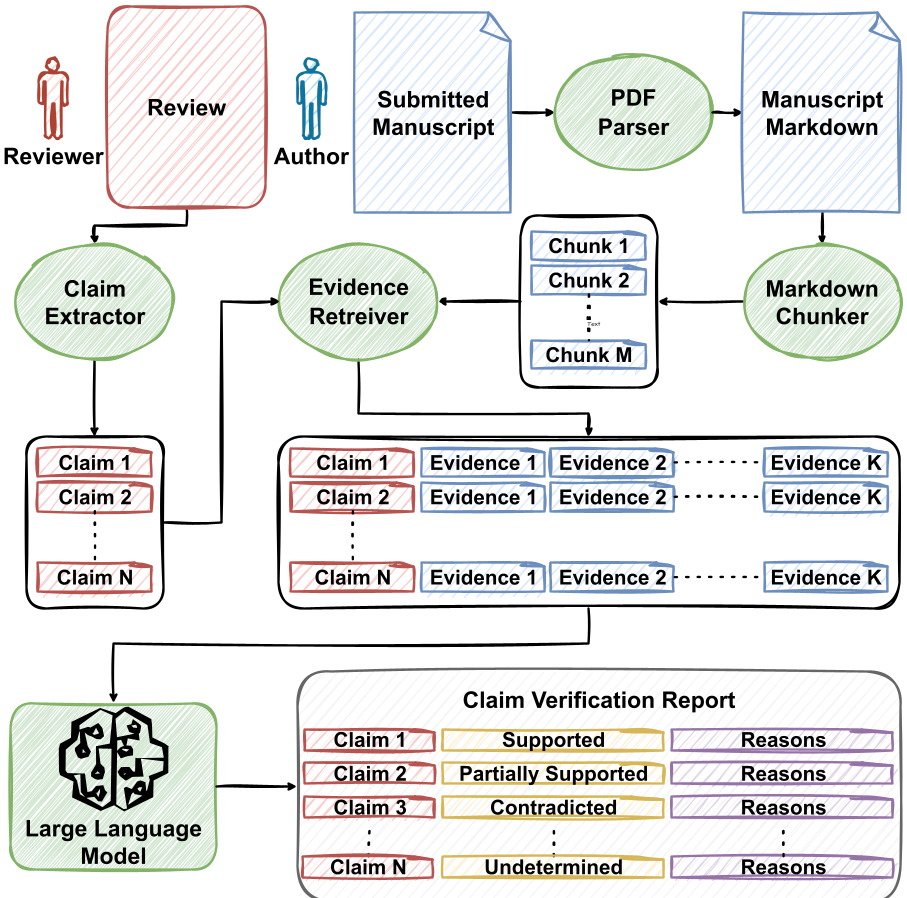
Peerispect 的核心思想是将验证任务建模为一个自含式的 Information Retrieval (IR) 流程。
- 声明提取 (Claim Extraction):系统将冗长的评论拆解为原子化的事实声明,并过滤掉主观情感词汇。
- 证据检索 (Evidence Retrieval):采用双重架构。先用 MiniLM-L6-v2 进行密集检索,再通过 Cross-Encoder 进行重排序。
- 声明验证 (Claim Verification):将提取出的声明作为 Hypothesis(假设),将检索到的论文段落作为 Premise(前提),输入 LLM 进行 NLI 推理。
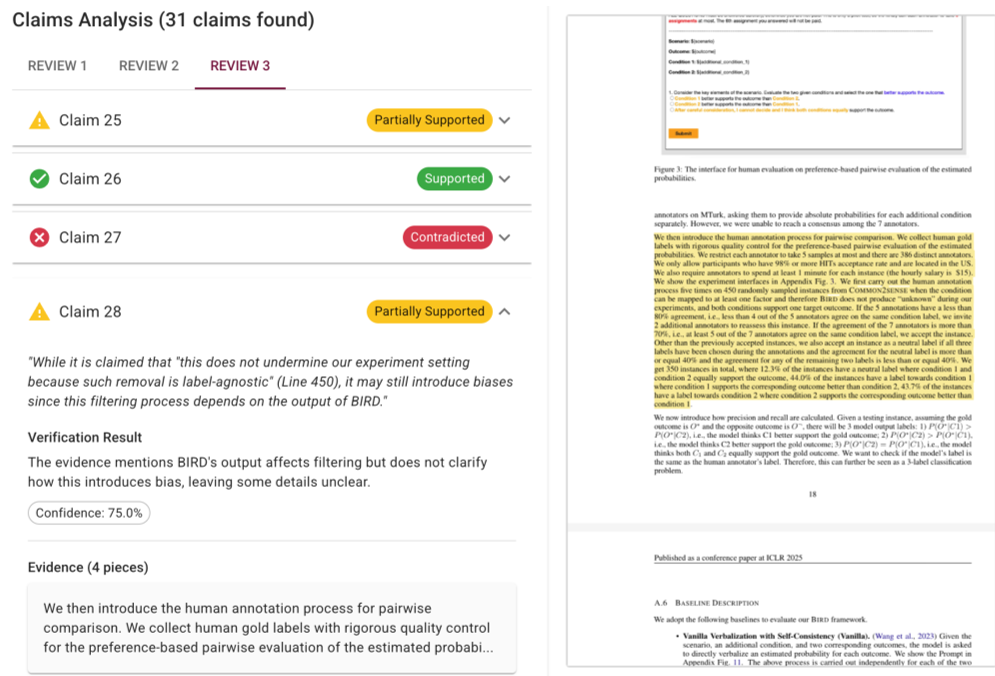
系统的前端界面允许作者和编辑直观地看到每个 Claims 的验证状态:
- Supported (支持):绿色
- Contradicted (矛盾):红色
实验与结果:从理想走向现实
为了测试系统可靠性,作者构建了两个基准:
- CMC (Controlled Manuscript Claims):从 50 篇 ICLR 论文中直接提取声明。在这种“理想状态”下,Qwen-2.5-7B 模型表现卓越,准确率高达 90.5%。
- RRC (Real-World Review Claims):使用真实的作者-审稿人互动对话进行标注。这一任务难度极高,由于评审语言的模糊性,准确率降至 28.7%。
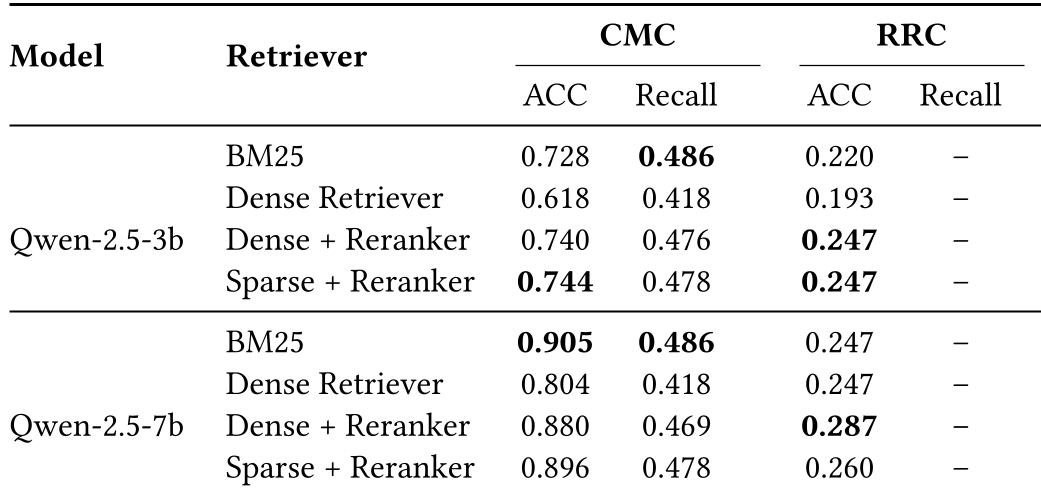
深度洞察:实验发现,Sparse Retrieval (BM25) 在原词匹配较多的 CMC 任务中非常强,但在面对审稿人习惯使用的同义词替换或抽象概括(RRC 场景)时,Dense Retriever + Reranker 的组合显示出了更强的语义捕捉能力。
深度洞察与总结
Takeaway: Peerispect 不仅仅是一个 Demo,它为学术界的“诚信管理”提供了新思路。它并不取代人类决策,而是通过证据对齐(Evidence Alignment),让作者在面对不公评审时能拿着“证据高亮”去进行有力的 Rebuttal。
局限性与未来展望: 目前 RRC 场景下的准确率仍有巨大提升空间,这主要是因为评审意见中包含大量的隐喻和跨段落推理。未来的研究方向可能在于如何利用更强的长文本模型(如具有 128K 上下文窗口的模型)来捕获整篇论文的全局逻辑,而非仅仅依赖片段检索。
Peerispect 的开源和模块化设计,预示着未来每一位审稿人的面前,可能都会有一个实时的“事实纠错器”。