
[研报] LLM 事实核查的利与弊:GPT-4 真的能取代人类“辟谣”吗?
The Perils & Promises of Fact-checking with Large Language Models
本文评估了 GPT-3.5 和 GPT-4 在自动化事实核查(Fact-checking)任务中的表现。研究提出了一种基于 ReAct 框架的 LLM Agent,通过集成 Google 搜索进行证据检索和推理,并对比了模型在多语言环境及不同上下文条件下的判断准确率。
TL;DR
本文深度评估了 GPT-3.5 与 GPT-4 在自动化事实核查中的实战表现。研究发现:背景上下文(Context)是 LLM 核查能力的“倍增器”。通过 ReAct 框架赋予模型联网搜索能力后,GPT-4 对明确真伪的声明判断准确率可突破 89%。但有趣的是,LLM 存在严重的“英语大脑”现象:用英语核查非英语声明,效果竟然比原生语言更好。
1. 痛点:为什么事实核查对 AI 来说很难?
事实核查不仅仅是简单的“对”或“错”。在专业机构(如 PolitiFact)的判定中,存在 Mostly-False 或 Half-True 等细微差别。
- Prior Work 的局限:早期方法多为黑盒模型,不仅无法给出理由,且极度依赖静态训练集。
- 数据泄露疑云:LLM 表现好,是因为它真的懂逻辑,还是因为它在训练阶段见过这篇辟谣稿?
- 长尾语言困境:全球范围内的虚假信息多以本地语言传播,而模型对非英语数据的处理能力通常较弱。
2. 核心机制:ReAct 赋能的联网 Agent
为了克服上述困难,作者并没有直接让 LLM 闭卷考试,而是给它发了一个“联网浏览器”。
2.1 模型架构
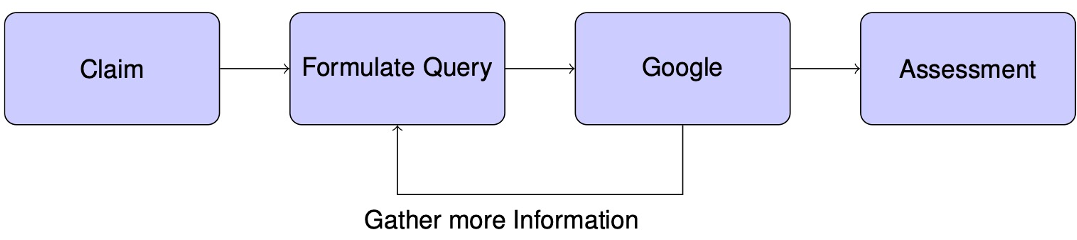
系统采用了 ReAct (Reasoning & Acting) 框架。Agent 的工作流程如下:
- 观察 (Observation):接收待核查声明。
- 思考 (Thought):分析声明中需要核实的关键点,决定搜索关键词。
- 行动 (Action):调用 Google Search API 抓取搜索结果预览。
- 迭代:如果信息不足,Agent 会更换关键词再次搜索(上限 3 次迭代)。
- 输出:给出判定级别、推理过程,并引用来源域名。
 上图展示了一个具体案例:Agent 通过检索华盛顿邮报的选举结果数据,成功识破了关于 Bernie Sanders 选票数的虚假传言。
3. 实验发现:数据背后的真相
3.1 上下文是关键
在无上下文(No-context)的情况下,模型容易受到内部训练偏见的干扰。一旦开启“联网模式”,GPT-3.5 和 GPT-4 的校准度显著提升,尤其是识别“真”声明的能力得到了质的飞跃。
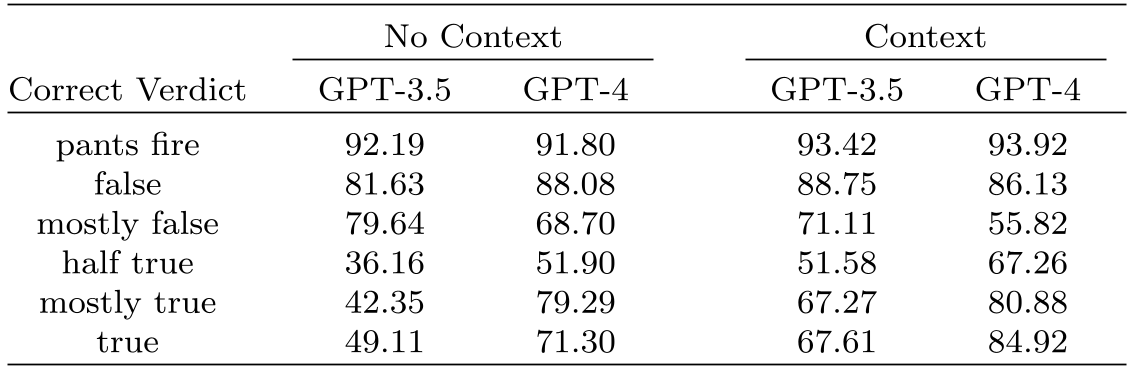 实验数据显示:在 False 和 Pants-fire 类别上,模型表现极佳;但在 Half-true 这种模糊地带,AI 依然面临挑战。
3.2 语言壁垒:翻译的奇效
在针对 14 种语言的多语言实验中,作者发现了一个深刻的 Insight:将非英语声明通过 Google Translate 翻译成英语后再输入模型(即使检索到的依然是本地信息预览),其 F1 分数竟然高于直接使用原生语言(如中文、泰卢固语)。 这说明 LLM 的高级推理逻辑主要建立在英语语料之上。
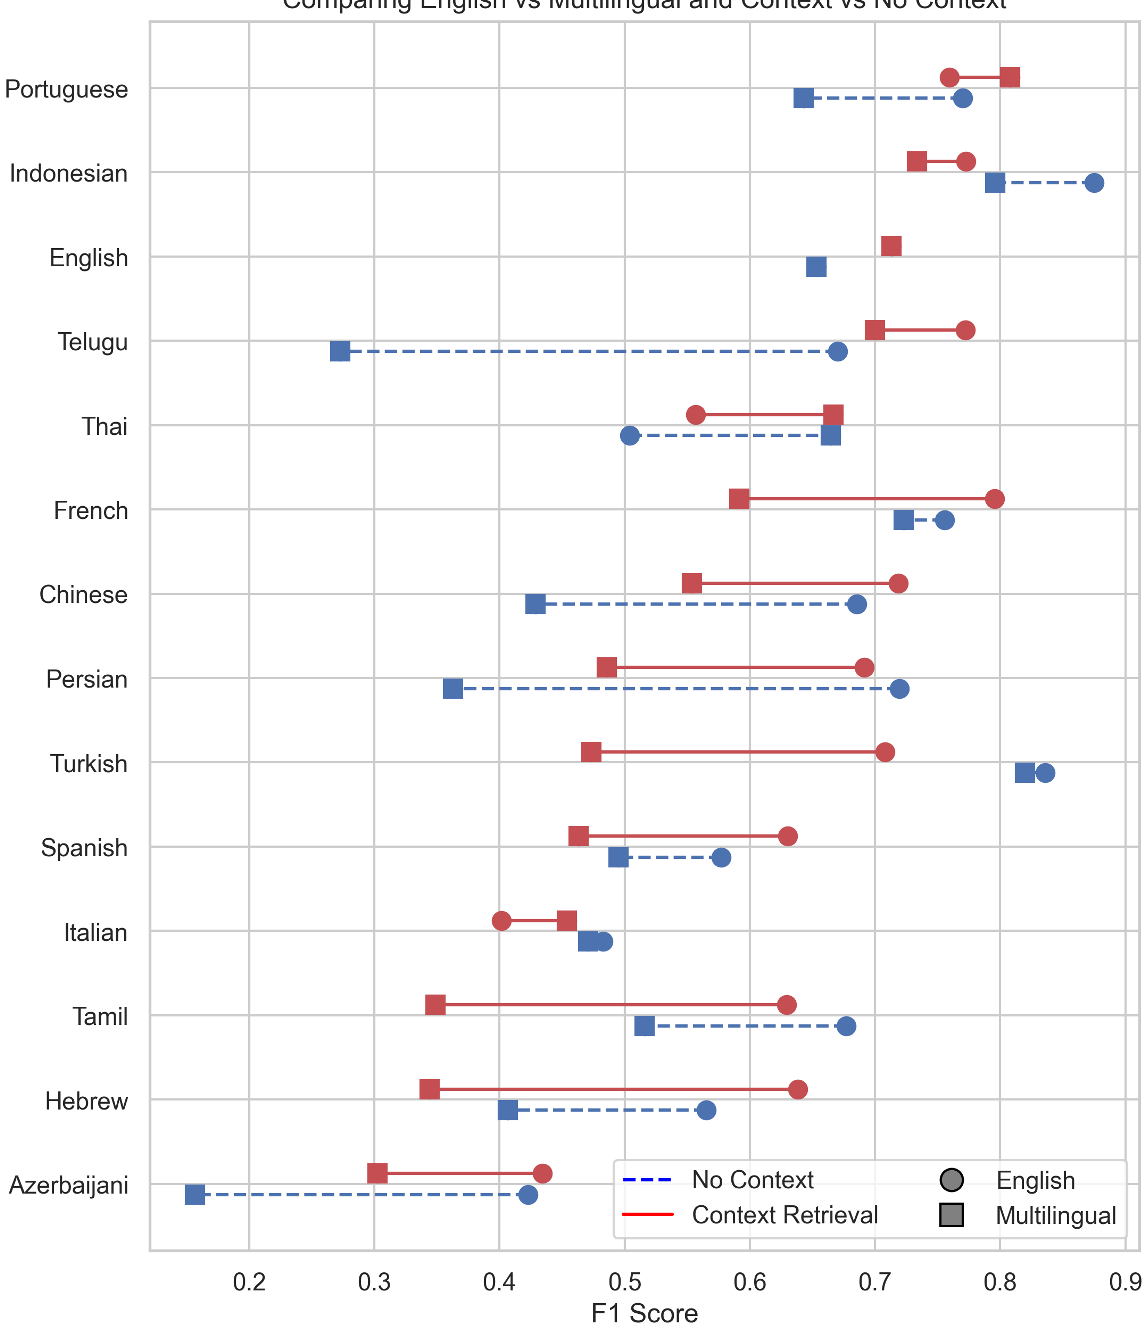 图中红色实线显示,在绝大多数语种下,英语翻译模式(圆点)的性能优于多语言原生模式(方块)。
4. 深度洞察:数据泄露与未来展望
即使由于 Knowledge Cutoff 导致的“断网”期之后,AI 的表现也没有下滑。 通过对比训练截止日期前后的声明,作者发现模型在处理 2021 年之后的新信息时依然稳健。这证明了通过外部检索补充实时知识(RAG)的思路是完全可行的。
局限性
- 歧义处理:模型很难区分“稍微夸大事实”和“彻底撒谎”。
- 幻觉风险:如果检索到的搜索预览本身包含错误信息,Agent 可能会被误导。
总结 (Takeaway)
这项工作证明了:LLM Agent 不应该被视为真理的仲裁者,而应该作为人类核查员的“增强外骨骼”。它能极大地缩短信息搜集的时间,但在处理具有复杂政治背景和微妙语义的声明时,人类的审慎依然不可或缺。未来的研究方向在于如何提高模型的跨语言一致性,以及如何让解释过程更加透明。