
PersonaVLM:让 AI 拥有“长记性”与“懂你性格”的深度进化
PersonaVLM: Long-Term Personalized Multimodal LLMs
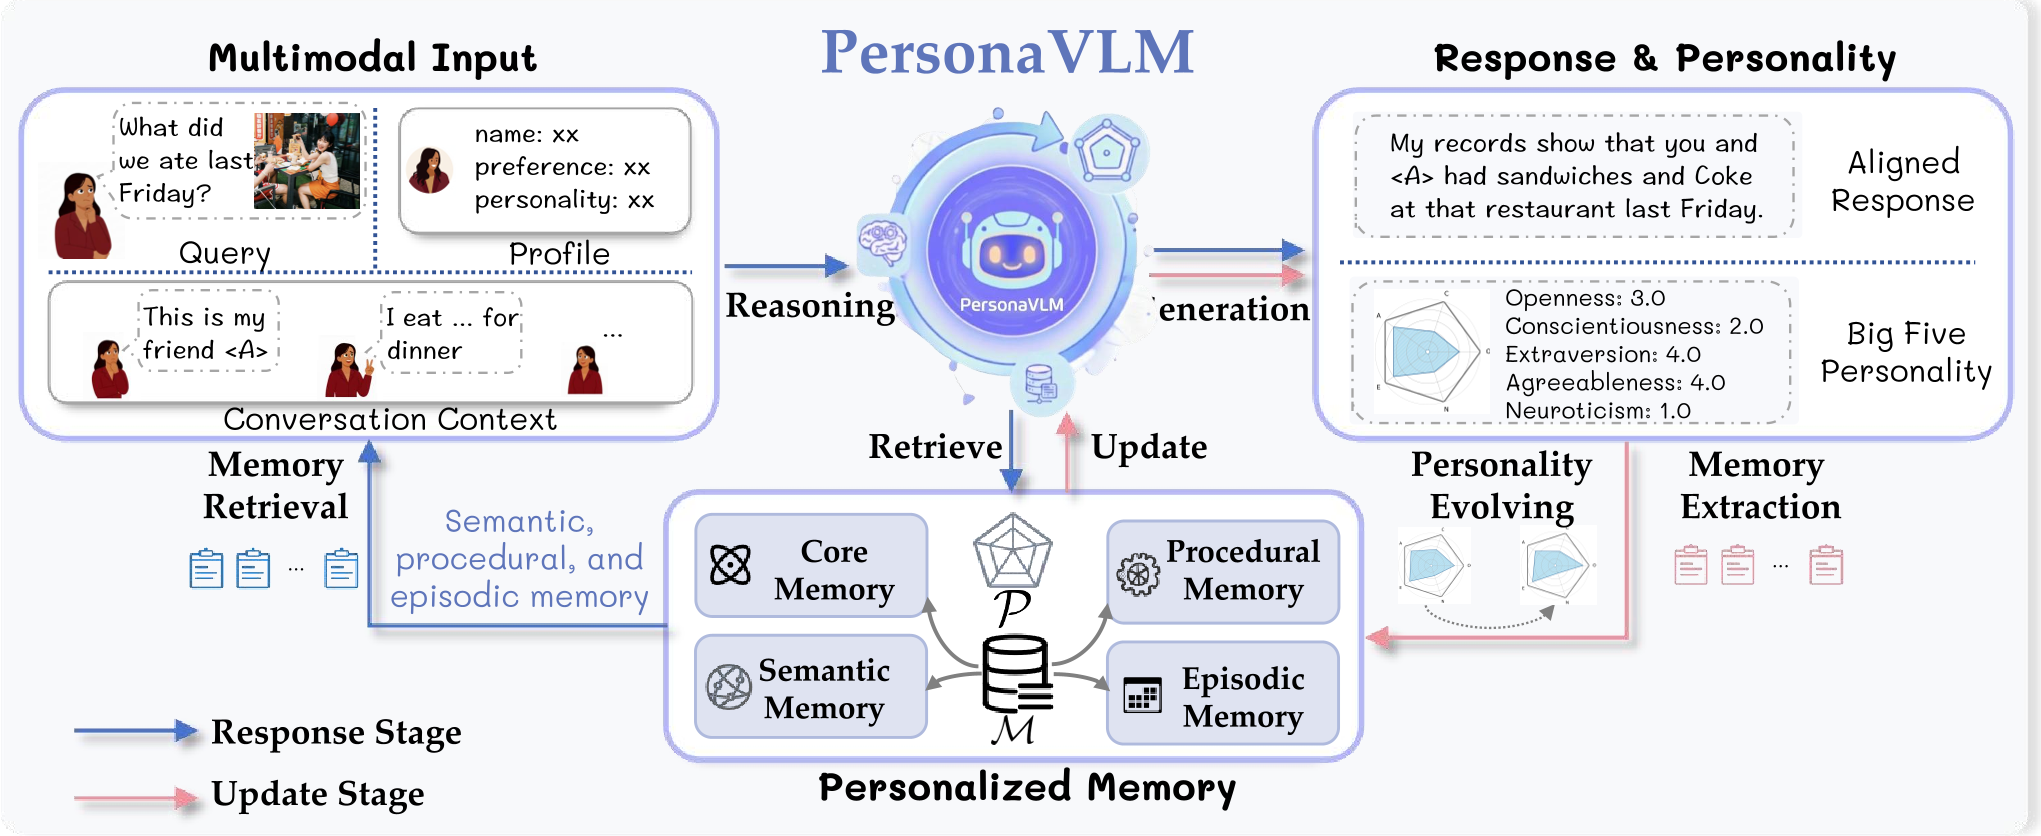
PersonaVLM 是由南京大学与字节跳动联合提出的长短期个性化多模态大模型框架。该框架通过整合主动记忆(Remembering)、多步推理(Reasoning)和人格对齐响应(Response Alignment)三大核心能力,在 Persona-MME 基准上相比基线提升了 22.4%,并超越了 GPT-4o。
TL;DR
未来的 AI 助理不应只是一个知识百科,更应该是深度契合用户个性的灵魂伴侣。南京大学与字节跳动团队推出的 PersonaVLM 赋予了 MLLM 三大杀手锏:能够主动更新的长短期记忆、支持多步推理的检索能力、以及随交互不断进化的“人格匹配系统”。在复杂的长文本与多模态考核中,它不仅大幅刷新了开源模型的上限,在对齐真实人格方面甚至超越了 GPT-4o。
痛点深挖:为什么你的 AI 总是“记不住”你的改变?
目前的各类多模态模型(如 LLaVA, InternVL)大多面临两个致命短板:
- 静态偏好瓶颈:如果你上周说喜欢雪碧,今天因为焦虑想改喝可乐,普通模型往往会死板地检索旧信息,导致推荐失败。
- 性格对齐错位:用户的性格往往隐藏在成百上千轮的碎碎念中。现有的 DPO 或微调方法只能实现“千人一面”的客气风格,无法适应一个用户从外向到内向的情绪波峰转换。
方法论核心:三位一体的个性化架构
PersonaVLM 的核心逻辑在于将模型从一个“黑盒”变成了一个带有管理后台的“智能体”。
1. 四类联邦记忆库 (Multi-type Memory)
它将记忆拆解为:
- Core (核心):用户的基本身份(如姓名、职业)。
- Semantic (语义):跨时间的客观事实(如“我不吃香菜”)。
- Episodic (情节):带时间戳的历史事件。
- Procedural (程序):用户的习惯与长远目标。
2. 人格演变机制 (Personality Evolving Mechanism, PEM)
这是本文最惊艳的设计。作者利用 Big Five (大五人格) 理论,将用户性格量化为五个维度的得分。
- 模型并非静态给用户打标签,而是通过 EMA (指数移动平均) 算法,根据每一轮对话动态更新分值。
- 这种设计能让模型在早期快速“学习”用户,在后期则保持人格认知的稳定性。
实验与结果:全方位吊打基线
为了验证这种动态个性化是否真有效,作者构建了目前最完备的基准测试 Persona-MME,涵盖了记忆、意图、偏好、行为等 14 个细分维度。
关键数据战绩:
- 准确率飙升:在 128k 超长上下文下,相比原生 Qwen2.5-VL,整体性能提升了 22.4%。
- 对抗 GPT-4o:在开放式生成任务中,人类/高级别模型评判 PersonaVLM 的胜率高达 79%。
- 推理的价值:通过引入 RL(强化学习)训练出的多步推理行为,模型能更聪明地判断何时该搜记忆库,而非盲目猜测。

深度洞察:不仅是记忆,更是“感同身受”
在消融实验中,最有趣的发现是:情节记忆 (Episodic Memory) 的贡献度远超其他类型。这意味着 AI 对“咱们哪天一起干了什么”这类细节的掌握,是构建信任度的关键。
此外,PersonaVLM 解决了一个工程难题——Token 效率。借助于动态检索机制,它在保持高性能的同时,消耗的平均 Token 数仅为全量上下文输入方案的 1/20 左右,这为低延迟、私有化的边缘计算提供了可行路径。
总结与局限
PersonaVLM 为多模态助手指明了方向:个性化不是简单的检索,而是对用户心智模型的实时建模。 局限性:目前该模型尚不支持视频或音频实时流的人格追踪,且记忆库目前基于时间线排列,尚未实现跨时空的复杂知识融合(Knowledge Merging)。
随着这类框架的成熟,那个真正“懂你”的贾维斯(Jarvis)或许已在路上了。