
PipeLLM:攻克机密计算瓶颈,让大模型在 H100 隐私保护下全速运行
Pipellm: Fast and confidential large language model services with speculative pipelined encryption
本文提出了 PipeLLM,一个旨在消除 NVIDIA H100 GPU 机密计算环境下 LLM 加速损耗的运行时系统。通过引入“预测性流水线加密”(Speculative Pipelined Encryption)机制,PipeLLM 成功将加密开销从关键路径中解耦,使 LLM 推理和微调的吞吐量损耗从最高 88.2% 降低至 19.6% 以内。
核心速览
TL;DR:上海交通大学 IPADS 实验室提出的 PipeLLM 是一套高性能的 LLM 机密计算运行时系统。它针对 NVIDIA H100 GPU TEE 环境中因数据加密导致的性能崩溃(最高下降 88%)问题,通过预测性流水线加密技术,将加密耗时与 GPU 计算成功并行化,实现了几乎无损的隐私保护大模型服务。
背景定位:这是针对 NVIDIA 新款机密计算硬件(H100)在 LLM 领域应用的首批深度优化工作,解决了“安全与性能不可兼得”的工程难题,属于系统安全与高性能计算的交叉前沿成果。
痛点深挖:为什么机密计算会让 LLM “变慢”?
在云端部署 LLM 时,为了防止云厂商泄露权重或用户 Prompt,通常会启用 Confidential Computing (CC)。在 NVIDIA H100 中,所有从 CPU 内存传向 GPU 的数据都必须经过硬件加密引擎。
然而,大模型是典型的“内存吞吐怪”:
- 模型容量超限:如 OPT-66B 超过了 H100 的 80GB 显存,必须不断地把各层参数从内存中“换入换出”(Swapping)。
- 动态 KV Cache:长对话会导致显存频繁溢出,触发大量的 IO 交换。
在标准模式下,加密、传输、计算是线性串行的。由于 CPU 的加密速度远低于 PCIe 5.0 的带宽,GPU 经常在干等数据解密,导致计算资源严重浪费。
核心机制:预测性流水线加密 (Speculative Pipelined Encryption)
PipeLLM 的灵感源于 CPU 的指令流水线。既然 LLM 的层级结构和推理过程高度规律,我们能否在 GPU 开口要数据之前,就帮它把数据“提前加密”好?
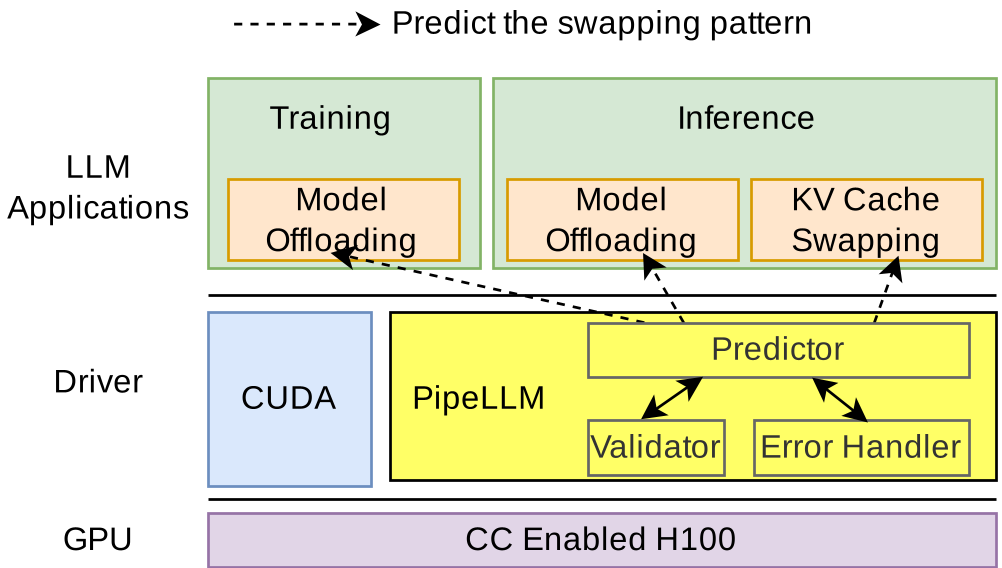
1. 模型行为预测 (The Predictor)
作者观察到三种强规律:
- 重复模式:层与层之间的换入顺序是固定的(Layer 1 -> 2 -> 3)。
- FIFO/LIFO 模式:vLLM 等框架交换 KV Cache 时遵循先进先出或后进后出。 Predictor 会监控历史 I/O 序列,提前锁定下一波要换入的数据。
2. 架构深度解析
PipeLLM 本质上在库函数层(CUDA Hook)做了一层拦截:
- 异步并行:开启多个 CPU 线程,在后台疯狂预加密。
- 验证机制 (Validator):通过修改内存页权限(Write Disable),一旦预测的数据被主程序修改,PipeLLM 会立刻感知并重新加密。
3. IV 错位的“神操作”
机密计算使用 AES-GCM 协议,要求每次加密的 IV(初始化向量) 必须递增且对齐。如果预测错了其中一块数据,后面的 IV 全乱了怎么办?
- NOP Padding:如果预测的 IV 跑快了,PipeLLM 会通过发送 1-byte 的哑数据(NOP)来消耗掉多余的 IV,强行让后续流水线对齐。
- 重排序:在同一个 Batch 内自由调整顺序,以适配现有的 IV。
实验与结果:化腐朽为神奇
作者在 NVIDIA H100-SXM 平台上针对 vLLM、PEFT 和 FlexGen 进行了严苛测试:
SOTA 性能对比
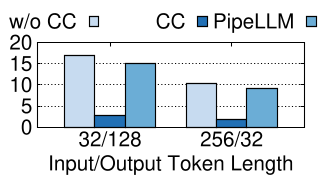
在运行 OPT-66B 模型时,原生 CC 系统的吞吐量几乎掉到了非加密系统的 1/10。开启 PipeLLM 后,吞吐量迅速反弹,性能损耗控制在极小范围内。
消融分析
即便预测成功率不是 100%(例如配置为 0 预测成功率),PipeLLM 凭借其 NOP 填充机制,性能依然远好于原生串行加密系统,这证明了流水线架构本身的鲁棒性。
深度洞察与总结
Takeaway:PipeLLM 证明了在大模型时代,系统层的“预测性预处理”是弥补安全硬件性能赤字的通用解药。它不需要用户修改一行深度学习代码,就能直接应用到 vLLM 等主流框架中。
局限性:
- ** side-channel 风险**:频繁的 NOP 填充可能会暴露模型的交换频率,存在被侧信道攻击的可能性。
- 高内存负载:后台预加密需要消耗额外的 CPU 算力和内存空间。
未来展望:随着下代英特尔 TDX-Connect 等 TEE I/O 硬件的普及,软件预测与硬件硬解的结合将使“透明、无损、安全”的 AI 云服务成为可能。
主编点评:“在安全领域,性能往往是最大的敌人。PipeLLM 将计算机体系结构中经典的 Speculation 思想成功平移回 LLM 系统的输入输出管理中,是非常直观且高效的解法。其源代码已开源,对机密计算落地具有极高的参考价值。”