
PnP-VCVE:重塑压缩视频增强,让下游任务在“马赛克”中重焕新生
Plug-and-Play Versatile Compressed Video Enhancement
本文提出了一个通用的插件式压缩视频增强框架 PnP-VCVE。该框架通过复用视频编解码器(Codec)中的元数据(如 CRF, 运动矢量, 分块图),在不显著增加计算开销的前提下,实现了对不同压缩等级视频的自适应增强,并在视觉质量及多种下游任务(VSR, 光流估计, VOS)上达到 SOTA 性能。
TL;DR
在自动驾驶或远程监控等实际应用中,视频必须经过强力压缩才能上传云端,但这往往导致画面布满伪影,让下游的 AI 识别系统“两眼抹黑”。本文提出的 PnP-VCVE 框架打破了传统增强方法效率低、不通用的僵局,通过直接复用 H.264 码流中现成的“编解码元数据”,实现了一个模型自适应所有压缩设置,既好又快地为视频超分、光流估计等任务排忧解难。
1. 痛点深挖:被忽视的编解码先验
目前业界处理压缩视频增强主要面临两个尴尬:
- “一刀切” vs “多头怪”:要么用一套模型应付所有压缩率(效果差),要么为每个 CRF 设置存一个模型(部署难)。
- 重复造轮子:深度学习模型往往费劲心思去计算光流和特征对齐,却忘记了视频码流中已经存在官方计算好的运动矢量 (Motion Vectors) 和复杂度分区 (Partition Maps)。
作者的直觉是:为什么不直接让编解码器告诉模型该怎么增强?
2. 核心机制:CAA 与 BAE 的协同艺术
2.1 压缩感知自适应 (CAA):从“静态”到“动态”
CAA 网络利用了视频编码的等级特征。它扮演“元网络”的角色,根据 CRF 值动态生成增强网络的参数。
- 序列自适应 (Seq Adaptation):为不同的全局压缩等级生成基础权重(类似于混合专家模型 MoE 的高效实现)。
- 帧级微调 (Frame Adaptation):针对 I/B/P 帧的质量波动进一步修正参数。
2.2 码流感知增强 (BAE):低成本的时空对齐
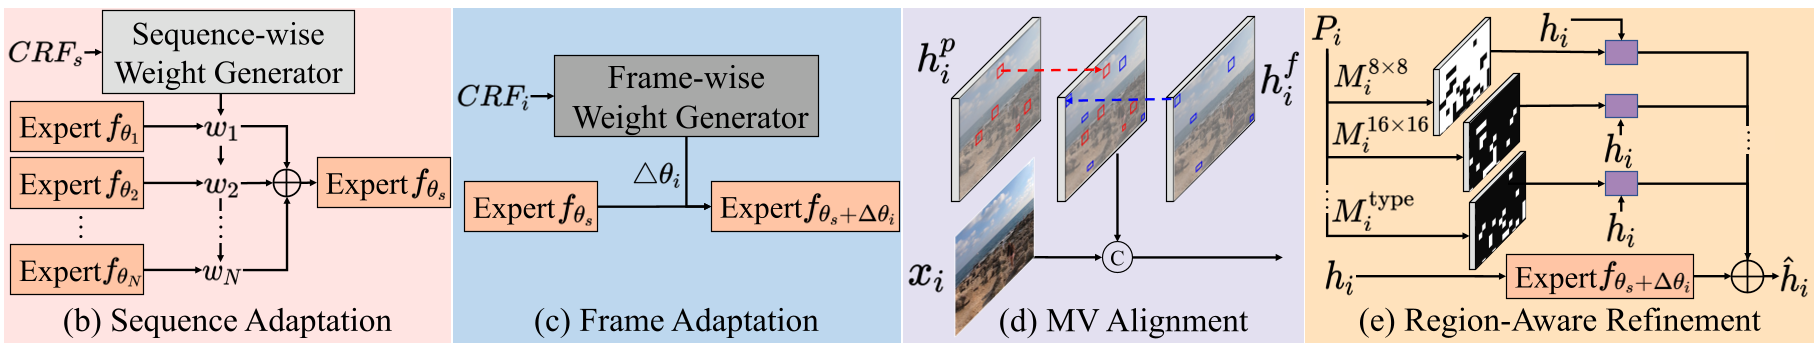
在 BAE 网络中,作者实现了两个天才的设计:
- MV Alignment:利用编解码器自带的运动矢量进行块对齐。虽然 MV 不如专门计算的光流精准,但它几乎是“免费”的,足以引导模型进行有效的时间信息聚合。
- Region-aware Refinement:参考分块图(如 16x16 或 8x8 宏块)。复杂背景(如树叶)用细小的块,简单背景(如路面)用大块。模型据此分配不同强度的 Sparse Convolution 滤波器,精准“打击”伪影。
3. 实验战绩:全能选手的表现
3.1 质量增强效果
在常规和“未见过”的压缩等级下,PnP-VCVE 均大幅领先 STDF 和 S2SVR。更重要的是,它的推理速度达到了 28 FPS,具备了准实时的工程化潜力。
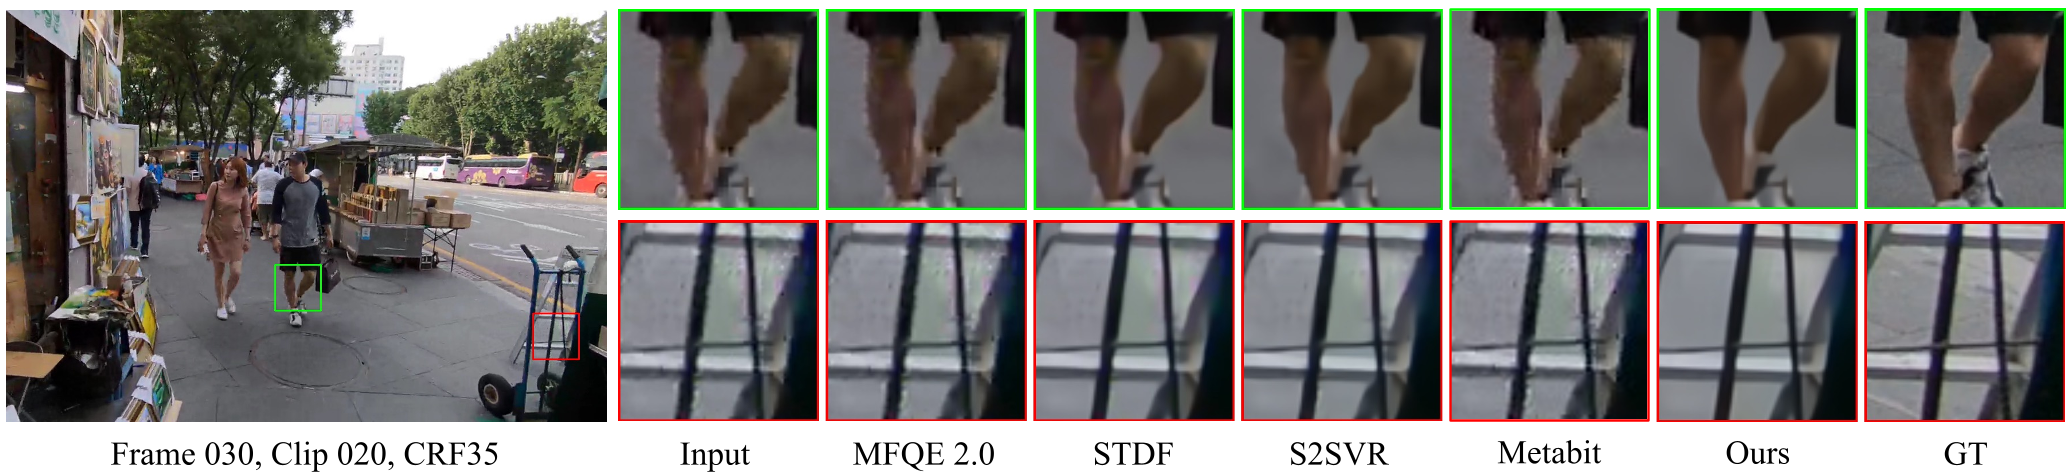 注:可以看到本文方法在处理运动物体边缘(如牛犊身形)时,有效消除了严重的块状伪影。
3.2 赋能下游:Plug-and-Play 的魔力
作者在 视频超分 (VSR)、光流估计 和 视频对象分割 (VOS) 三大任务上验证了该模块的插件属性。
- VOS 任务:在强压缩(CRF35)下,预增强能让分割精度从 79.20 提升到 81.57。
- 超分任务:避免了 VSR 模型在放大画面的同时放大了“马赛克”。
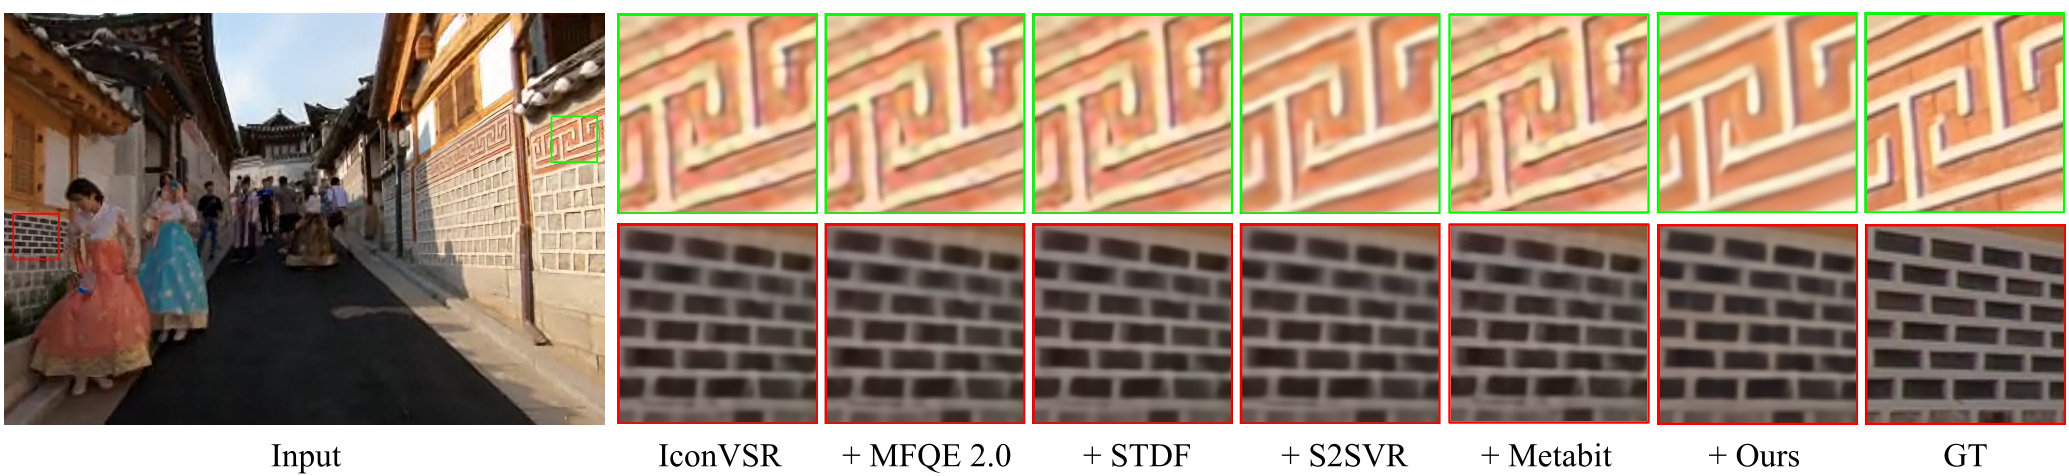 预处理后,BasicVSR++ 等超分模型的边缘恢复更加锐利,没有出现因压缩导致的伪叠。
4. 深度洞察与总结
PnP-VCVE 的成功揭示了一个趋势:AI 模型的未来不在于孤立的暴力计算,而在于对基础设施(如编解码协议)的深度感知。
优点:
- 零成本对齐:复用 MV 节省了大量光流计算开销。
- 极强通用性:不仅支持 H.264,论文通过实验证明在无法获取完整码流时,仅靠帧类型(I/P/B)也能达到极佳的自适应效果。
局限:
- 尽管复用了编解码信息,但在面对极致低比特率(画质彻底崩坏)时,该方法依然受限于输入信息的残余量,未来或需引入生成式先验(如 Diffusion Prior)来进一步修补细节。
这篇工作为工业界提供了一个极佳的示范:如何在一个计算受限的环境中,通过精巧的架构设计,优雅地解决视频传输与分析之间的矛盾。