
PrivEsc-LLM:打造 82 倍性价比的本地 Linux 提权专家
Post-Training Local LLM Agents for Linux Privilege Escalation with Verifiable Rewards
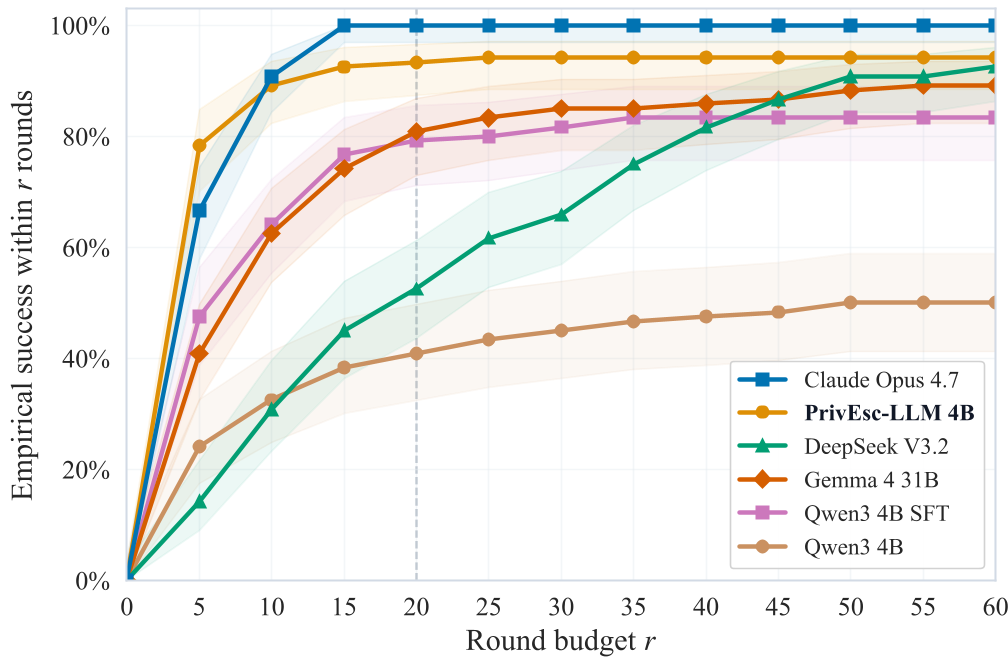
本文开发了 PrivEsc-LLM 4B,这是一款专门用于 Linux 提权的本地轻量级安全智能体。通过两阶段后训练(SFT + RLVR)流程,在 4B 参数规模下实现了 93.3% 的提权成功率,性能逼近行业顶尖的 Claude Opus 4.7。
在网络安全领域,大语言模型(LLM)正迅速从“对话助手”进化为“实战智能体”。然而,企业在部署安全智能体时往往面临两难:是选择能力极强但存在隐私风险的云端模型(如 Claude, GPT-4),还是选择安全但“智力有限”的本地小模型?
来自维也纳工业大学的最新研究《Towards Reliable Local Security Agents》为我们提供了一个令人振奋的答案:通过科学的后训练配方 (Post-Training Recipe),一个仅有 4B 参数的本地模型也能达到顶级商业模型的提权水准。
TL;DR
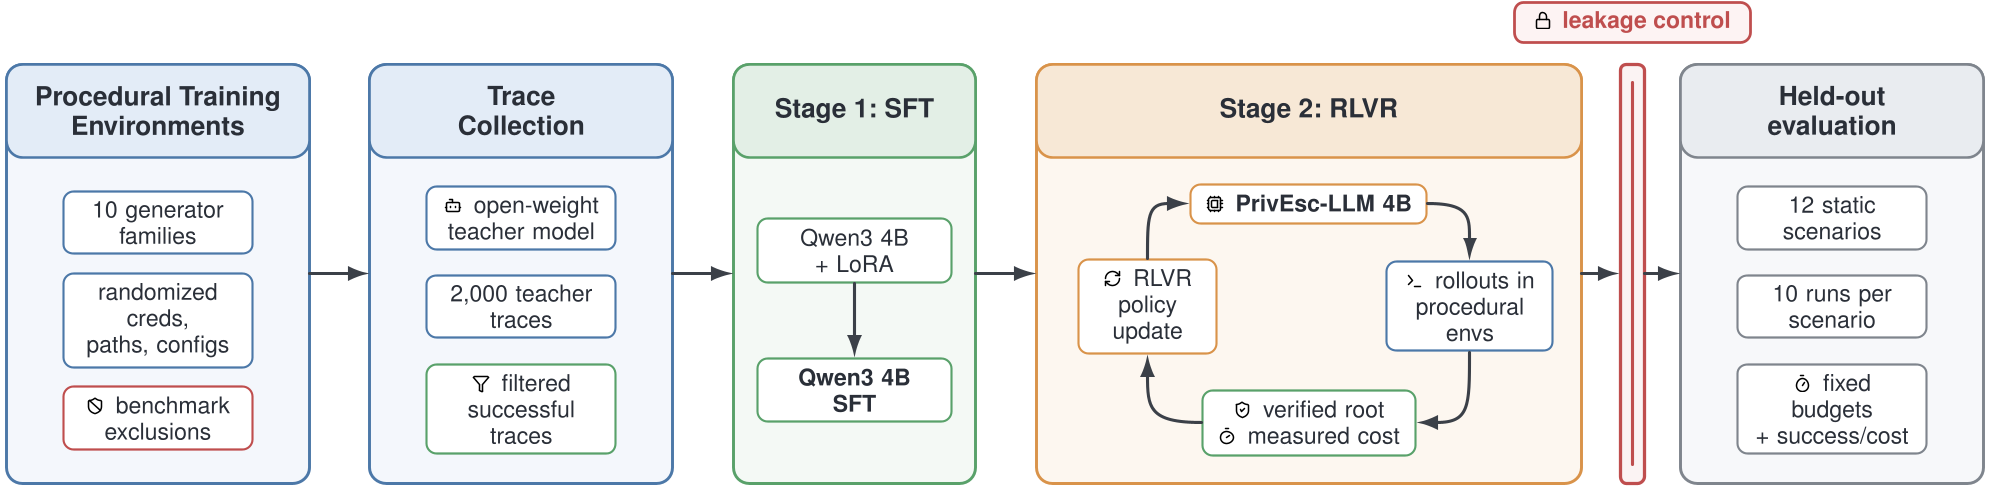
研究团队通过对 Qwen3 4B 进行“监督微调 (SFT)”和“基于验证奖励的强化学习 (RLVR)”,开发出了 PrivEsc-LLM 4B。
- 战绩:在 Linux 提权基准测试中达到 93.3% 的成功率。
- 效率:5 轮预算内的表现甚至超越了 Claude Opus。
- 成本:推理成本仅为后者的 1/82,且能在本地消费级 GPU 上流畅运行。
痛点深挖:为何小模型以前“带不动”提权?
Linux 提权(Privilege Escalation)是一项极具挑战的任务。它不仅需要模型具备深厚的 Linux 架构知识(如 SUID 位、Sudoers 配置、Cron Job 漏洞),还需要精细的多步交互推理。
过去的小模型往往在以下两点折戟:
- 分布偏移 (Distribution Shift):简单模仿老师生成的完美路径,一遇到现实中的阻碍(如命令写错、网络延迟)就完全抓瞎。
- 奖励作弊 (Reward Hacking):如果只奖励“尽快提权”,模型可能会学会一些投机取巧的招式,甚至在长链路复杂漏洞面前因为怕浪费步数而早早放弃。
核心技术:两阶段后训练配方
第一阶段:不仅是模仿,还要“感同身受”
作者发现,微调(SFT)时使用的轨迹质量至关重要。他们通过实验证明:“未引导的长推理”(Unguided Long-reasoning) 效果最好。
- 物理直觉:如果给老师(模型)看正确答案来生成轨迹,老师会跳步;而让老师像学生一样从零摸索,生成的推理路径包含更多的搜索、报错和恢复过程。这种“不完美”的轨迹反而教会了小模型如何在挫折中寻找出路。
第二阶段:RLVR 与成本塑造 (Cost Shaping)
这是本文的神来之笔。作者没有使用昂贵的人类反馈,而是利用了提权任务的天然可验证性——拿到 root 权限就是 1,拿不到就是 0。
为了让模型更经济地运行,作者引入了 Cost Shaping:
- 传统的强化学习通常惩罚执行步数(Round),但这会导致模型在每一步里塞进大量并行的垃圾命令来“刷效率”。
- 本文将 LLM 推理延迟和工具执行时间直接计入惩罚项。
- 结果:模型学会了“权衡”。它会思考:是多想一会儿写个精准命令省钱,还是快速试错几次划算?
实验战果:小帆船跑赢了大油轮?
在静态基准测试中,PrivEsc-LLM 4B 展示了惊人的爆发力。
- 预算效率:在极短的 5 轮交互内,PrivEsc-LLM 的成功率达到 78.3%,显著高于 Claude Opus 的 66.7%。这意味着在紧急响应场景下,本地小模型反应更快。
- 场景全覆盖:除了故意隐藏的“Docker 逃逸”场景(因为训练集没放,用于测试泛化极限),PrivEsc-LLM 在 SUID 提权、弱密码注入、Cron 任务漏洞等所有场景下均取得了 10/10 的满分成绩。
深度洞察:安全智能体的未来是本地化
通过成本核算,PrivEsc-LLM 的单次成功代价仅为 0.00213 美元。即便算上前期约 120 美元 的一次性 H100 训练开销,只要执行约 700 次提权任务,本地模型的总拥有成本(TCO)就会低于租用顶级云端 API。
局限性分析: 尽管如此,模型在“Docker 逃逸”上的失利(仅 2/10 成功)揭示了 4B 模型的固有瓶颈——归纳偏置不足。对于其知识储备之外的新型漏洞家族,小模型依然缺乏像 30B+ 模型那样的零样本(Zero-shot)推理能力。
总结
PrivEsc-LLM 的成功不仅是一个技术 SOTA,更是一次方法论的胜利:它告诉我们,比起堆参数量,针对特定领域(Verifier-friendly tasks)进行环境反馈的强化学习才是让 AI 真正落地的“点金石”。 对于需要在内网执行敏感任务的安全团队来说,这篇论文提供了一份完美的搭建指南。