
深度学习进军宇宙学:秒级锁定“黑暗中的幽灵”——原初黑洞
Search for primordial black holes from gravitational wave populations using deep learning
本文提出了一种基于深度学习(Neural Posterior Estimation, NPE)的新型引力波(GW)星族演化推断方法,用于探寻原初黑洞(PBH)。该方法结合了条件规范流(Conditional Normalimzing Flows)与双重嵌入网络,成功在数秒内实现了对暗物质中 PBH 比例(fPBH)等超参数的 SOTA 级别快速推断。
TL;DR
来自中国科学院大学、基础物理与数学科学学院等机构的研究团队,通过神经后验估计(NPE)技术,攻克了引力波星族推断的效率制约瓶颈。该方法通过“条件规范流”捕捉复杂的参数关联,将传统需要半小时以上的计算压缩至5秒内,为在大数据时代探测原初黑洞(PBH)铺平了道路。
背景定位:这是首次将 NPE 方法应用于原初黑洞搜索的引力波星族分析。它标志着引力波研究从“慢速、复杂似然推断”向“实时、端到端模拟推断”的范式转移。
痛点深挖:贝叶斯算法的“长征”
在引力波天文学中,我们捕获的并不是黑洞的“照片”,而是一段颤动的时空波纹。科学家需要利用分层贝叶斯分析(Hierarchical Bayesian Analysis, HBA),从成百上千个单独事件中总结出统计规律,进而回答最重要的课题:这些黑洞中,有多少是宇宙大爆炸初期形成的“原初黑洞”?
然而,HBA 面临两大难题:
- 解析模型局限:必须假设一个数学公式(如幂律),这往往难以覆盖真实的物理复杂性。
- 计算量爆炸:随着探测信号增多,MCMC 采样器需要无穷无尽的迭代,在面对未来 LISA、天琴(TianQin)等探测器的数据流时,这种方法将彻底崩溃。
核心方法:模拟推断与神经规范流
研究者引入了 Simulation-Based Inference (SBI) 框架。不同于传统方法不断地“试错”参数来匹配数据,该方法直接通过训练好的模型“直觉式”地给出答案。
1. 架构解析
模型由三部分精妙组合而成:
- Embedding Network 1:将单个引力波事件的海量后验样本(质量、距离等)压缩成特征向量。
- Embedding Network 2:汇总 64 个事件的特征,提取“星族级别”的信息。
- Normalizing Flow (NF):核心部分。基于
Neural Spline Flows,它将一个简单的正态分布,“塑形”成复杂的、多变量耦合的星族参数后验分布分布。
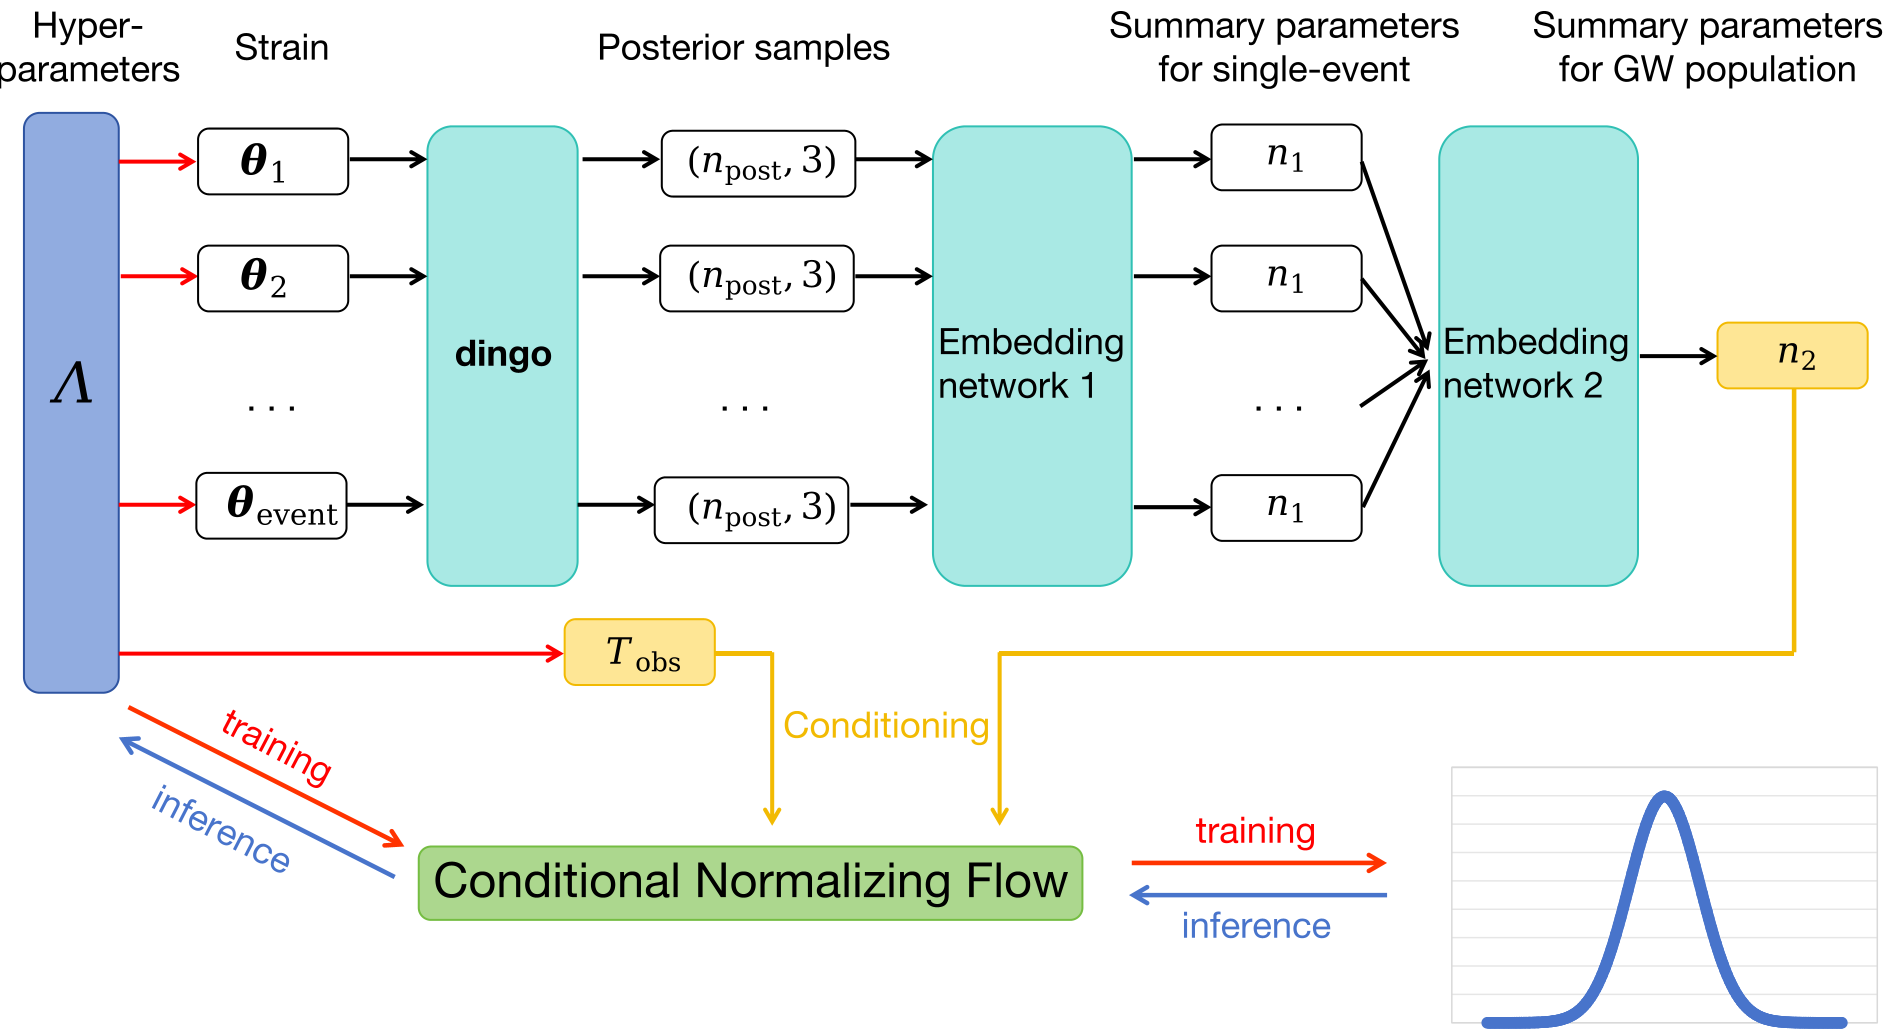 图 1:深度学习模型示意图,展示了两个嵌入网络与规范流的级联关系。
2. 为什么 NPE 更强?
- Amortization (平摊开销):模型训练虽耗时,但一旦训练完成,推断几乎瞬时完成。
- Likelihood-Free:不需要写出复杂的概率似然公式,只需提供一个能生成模拟引力波数据的“前向模拟器”。
实验战绩:速度与精度的双重降维打击
研究团队对比了 PBH 模型(主要是质量分布和合并率)和天体物理黑洞(ABH)模型。
- 准确对比:在 fPBH(原初黑洞占暗物质比例)的估计上,DL 方法给出的结果比传统 HBA 更窄(更精准)。这是因为模型完美学习了“观测时间 Tobs”与“探测事件数量”之间的物理关联。
- 效率飞跃:传统方法需并行多个计算节点计算十分钟以上,而 DL 方法在单张显卡上 5 秒杀。
- 泛化性验证:通过 P-P Plot 验证,所有参数均完美落在对角线上,证明了推断完全没有偏差。
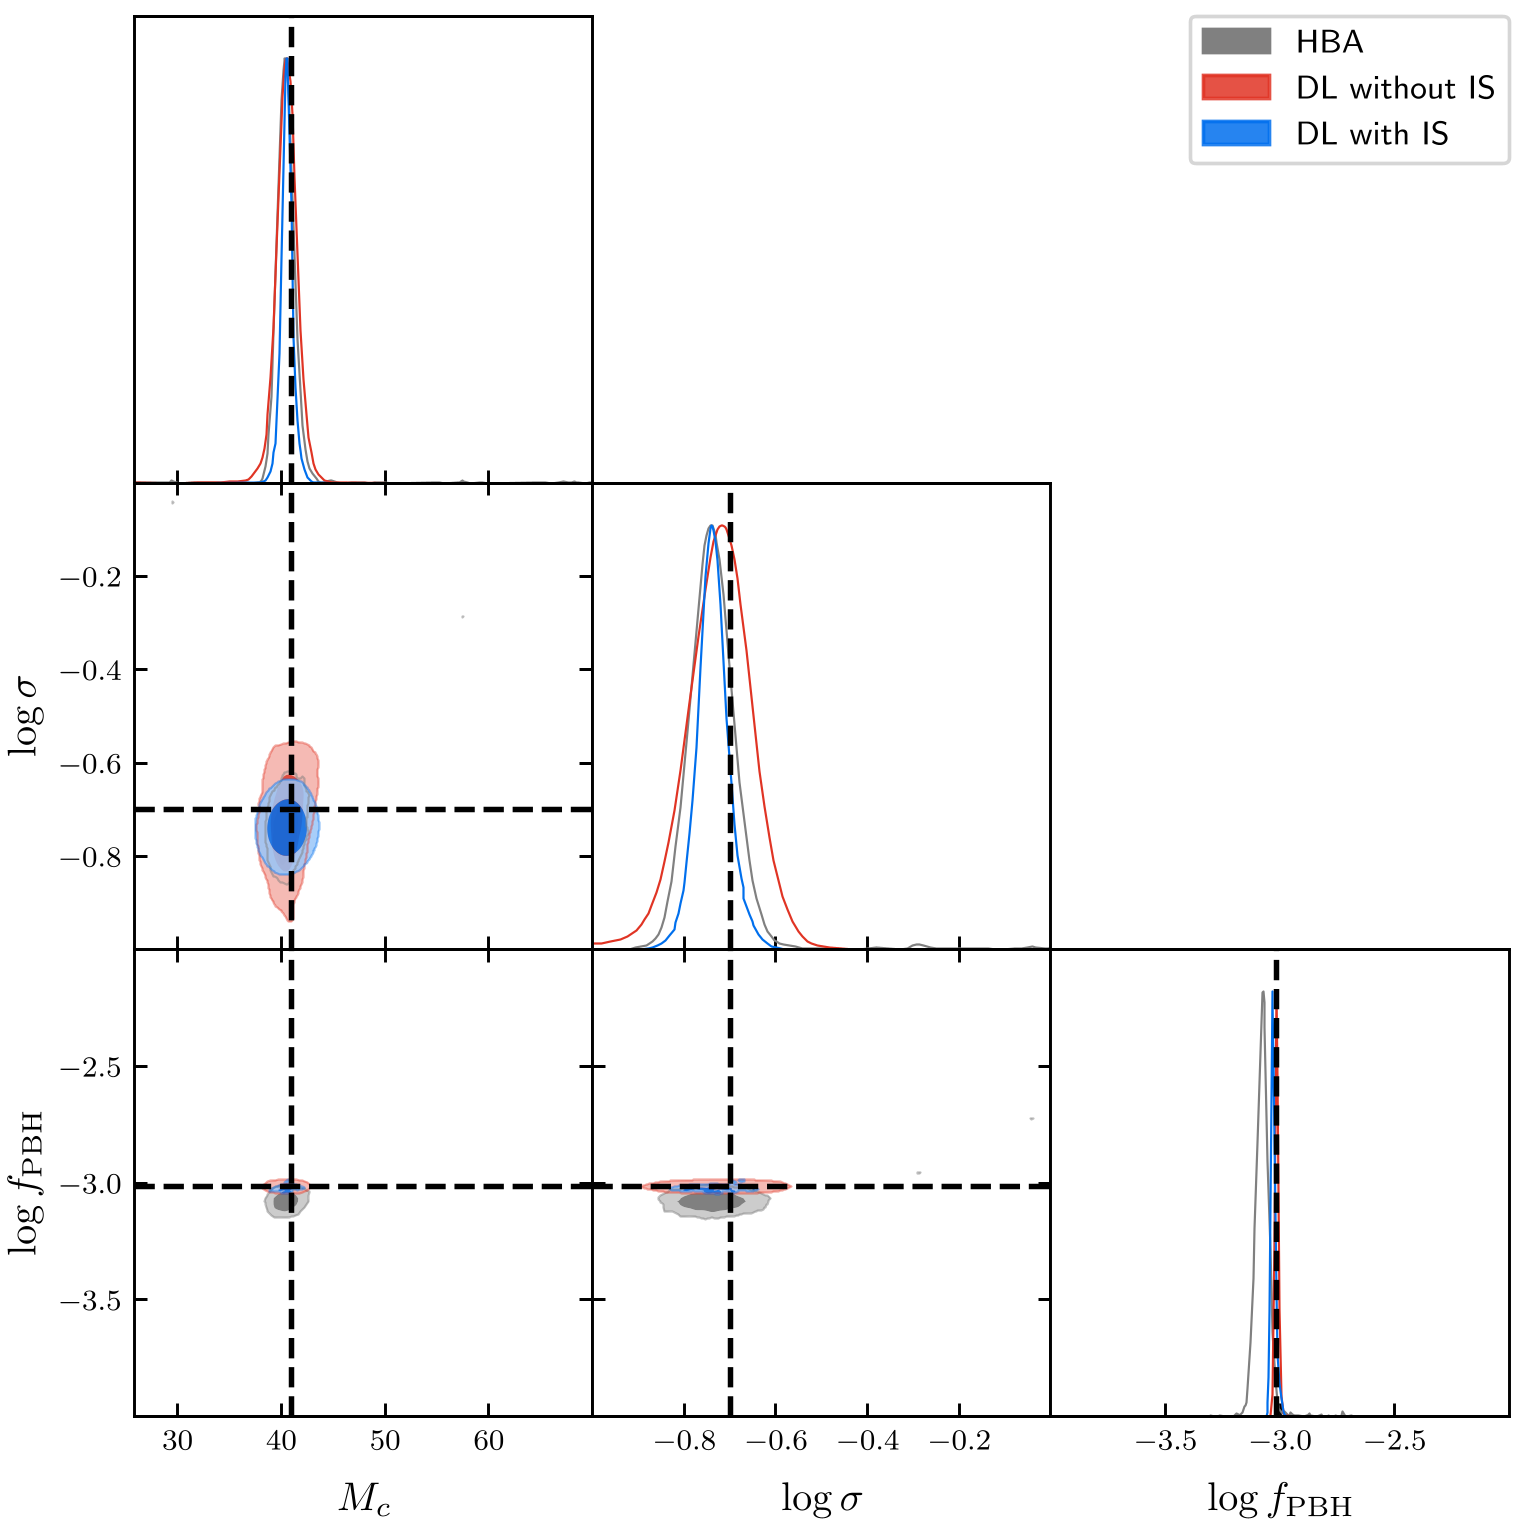 图 2:深度学习推断(红色)与传统 HBA(灰色)的对比。可以看出两者高度契合,但在 fPBH 参数上 DL 表现更稳。
深度洞察:开启“实时宇宙学”
星族分析的范式变革: 该研究最深刻的意义在于,它证明了我们可以绕过由于探测器灵敏度带来的“选择偏置(Selection Bias)”计算。通过在训练集中直接引入信噪比(SNR)阈值,模型在推断时已自动“补偿”了观测缺失。
局限性与展望: 虽然模型在闭环模拟上表现近乎完美,但它仍面临“模型错配(Model Mis-specification)”的挑战——如果真实宇宙中的黑洞分布完全不在训练集范围内,深度模型可能会给出错误的自信。作者指出,未来的研究将引入**重要性采样(Importance Sampling)**作为验证步,并将集成更复杂的黑洞吸积和自旋模型。
总结 (Takeaway): 本文不仅是计算工具的升级,更是对未来引力波大数据探测(如 LISA, Taiji)的提前布局。原初黑洞的秘密,或许就深藏在这些被神经元快速捕捉的时空震荡之中。