
PRISM:突破长程智能体瓶颈,以 1/13 的成本实现帕累托最优检索
PRISM: Pareto-Efficient Retrieval over Intent-Aware Structured Memory for Long-Horizon Agents
本文提出了 PRISM,一种针对长程语言智能体的免训练检索框架。该方法通过在图结构记忆上联合进行基于意图的路径检索与证据压缩,实现在 LoCoMo 基准测试中以极低的上下文成本(约 2K tokens)达成 SOTA 准确率。
TL;DR
在长程对话任务中,LLM 智能体往往面临“记不住”或“记太全太贵”的两难境地。本文介绍的 PRISM 框架通过图结构化记忆(Graph Memory)与智能证据压缩(Evidence Compression)的耦合,在保持极高准确率的同时,将上下文成本压缩到了极致。它在不进行任何微调的前提下,成功填补了学术界在“高准确率-低成本”坐标系中的空白。
1. 痛点:被忽视的“效率-准确率”边界
目前的长文本智能体主要分为两派:
- 长上下文支持派:直接增加 Context Window 长度。代价是推理成本暴增,且模型容易陷入“Lost in the Middle”的困境。
- 重摄取派:在存入记忆时就进行繁重的摘要和事实提取。这导致写入成本极高,且一旦 schema 改变,所有记忆都得重刷。
作者通过 Figure 1(a) 指出,当前的系统要么在右下角(高成本、中等准确率),要么在左下角(低成本、低准确率)。而高准确率/低成本这个帕累托最优(Pareto-Efficient)的左上角区域,此前几乎是空白。
2. 核心机制:检索侧的“四重奏”
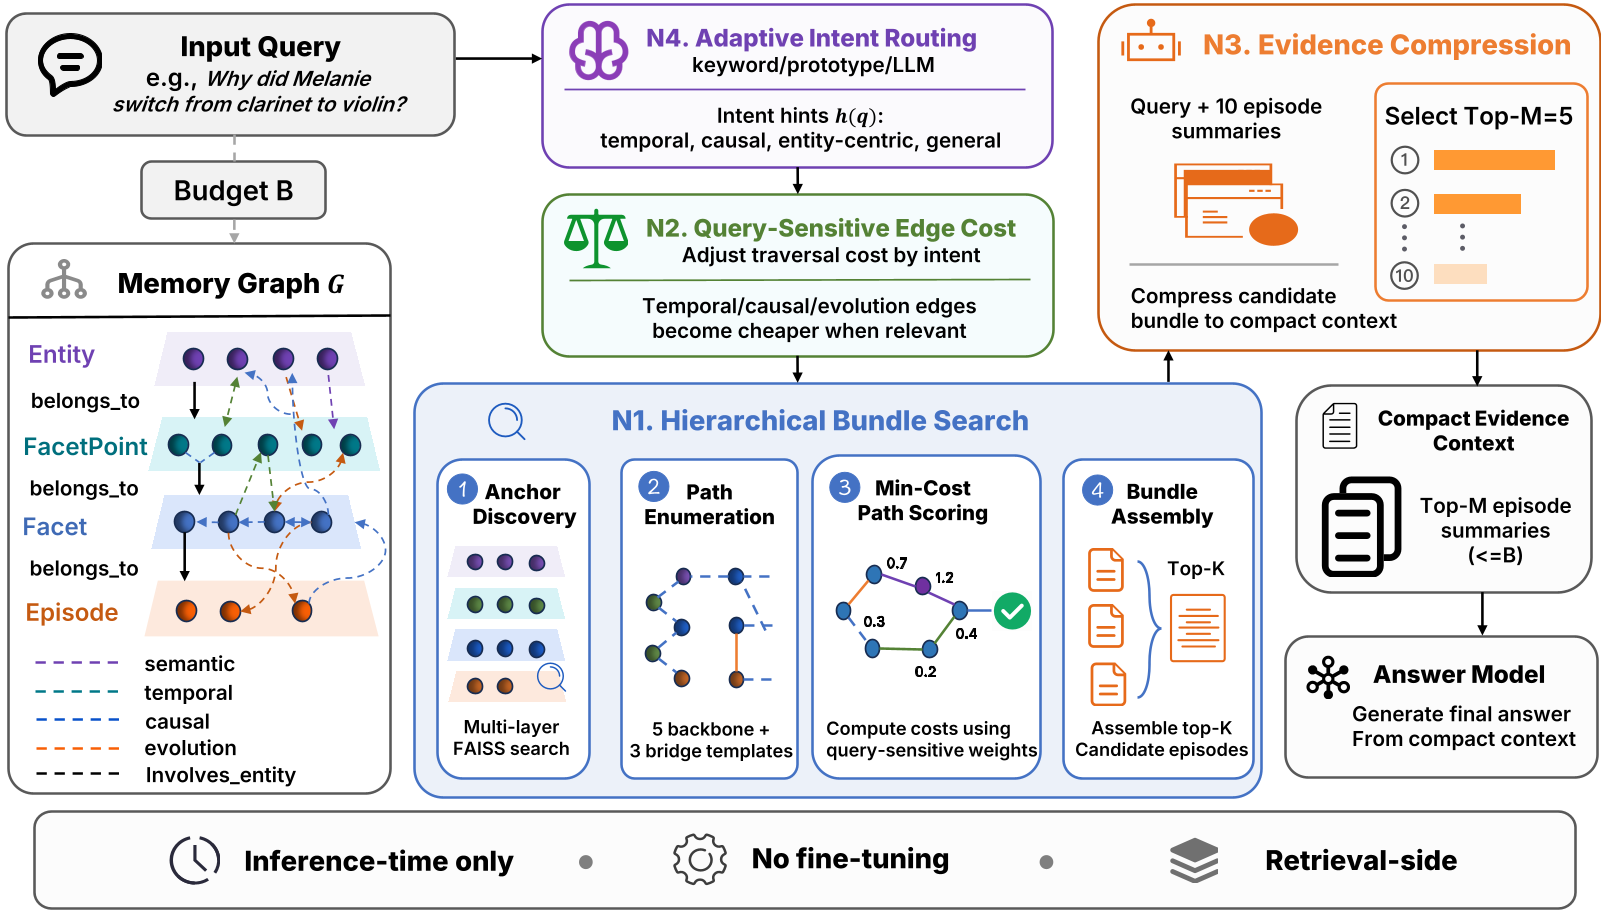
PRISM 并不修改模型,而是在检索端通过四个模块协同工作:
2.1 层次化捆绑搜索 (N1) 与 边缘计费 (N2)
PRISM 将记忆构建为包含 Entity (实体), FacetPoint (事实点), Facet (切面) 和 Episode (片段) 的四层图结构。检索时不再仅仅计算向量相似度,而是通过“路径模板”寻找证据。
- 物理直觉:如果问题是“Melanie 为什么改学小提琴?”,传统检索可能找不到直接匹配。但 PRISM 会通过“因果边”或“演化边”寻找从“改学”到“音乐会激发灵感”的路径。
2.2 证据压缩 (N3):点睛之笔
这是 PRISM 占据效率高地的关键。它首先粗筛出 Top-K 个候选片段,然后调用一个轻量级 LLM 对这些片段进行内容级重排(Rerank)和压缩,只输出 Top-M 个最相关的摘要给主模型。
- 架构优势:这解决了“结构相关但语义无关”的噪声问题,同时也大幅降低了主模型的 Token 负担。
2.3 自适应意图路由 (N4)
为了进一步省钱,PRISM 设计了一个三级路由:
- 一级:正则匹配关键词(如 when/why)。
- 二级:向量原型匹配(Prototype Match)。
- 三级:实在判别不了才调用 LLM 分类。 结果显示,超过 42.3% 的查询根本不需要 LLM 参与意图识别,极大地降低了系统开销。
3. 实验结果:以小博大的胜利
在 LoCoMo(超长对话 QA)基准测试上,PRISM 的表现令人惊艳:
- 准确率胜出:相比同协议下的 Mem0g 和 MAGMA,准确率提升了约 14%。
- 成本骤减:平均每条查询仅使用 2,023 tokens,而相比之下,全上下文模式需要 26,031 tokens。
- 效率之王:PRISM 的“每 1K token 贡献准确率”是基线模型的 2-20 倍。

4. 深度洞察
- 最后 1GB 的价值:PRISM 的消融实验(Ablation Study)显示,N3(证据压缩)是降低 Token 消耗的核心驱动力。如果没有 N3,上下文长度会翻倍,而准确率提升微乎其微。
- 图结构的潜力:虽然在 LoCoMo 这种相对简单的基准上,复杂的路径检索(N1/N2)增益不明显(约 3%),但在需要多步推理(Multi-hop)的桥接任务中,这种基于逻辑路径的检索将是不可替代的。
5. 局限性与展望
尽管 PRISM 在对话场景表现出色,但其目前主要针对文本记忆。未来如何将该框架扩展到动作轨迹(Action Trajectories)和工具调用轨迹(Tool Calls)中,将是构建真正意义上“终身学习智能体”的下一个前沿。
结论
PRISM 告诉我们:更好的检索不一定要更重的模型,而在于更聪明的结构化表达与检索侧的精细化治理。 它为低功耗、高相应速度的 AI 助手提供了一条极具参考价值的技术路线。