
AloePri:突破 LLM 隐私推理的“不可能三角”
Towards Privacy-Preserving LLM Inference via Covariant Obfuscation (Technical Report)
本文提出了 AloePri,一种面向工业级场景的 LLM 隐私保护推理方法。其核心是“协变混淆”(Covariant Obfuscation)机制,通过联合变换输入数据与模型参数,在 Deepseek-V3.1-Terminus(671B)等超大规模模型上实现了接近零的精度损失(0.0%~3.5%)和与明文推理相当的效率。
在 LLM 时代,隐私保护与高性能推理往往被视为鱼与熊掌不可兼得。云端厂商(LMaaS)需要高性能、低成本,而企业用户则对数据泄露极度敏感。现有的 TEE 或纯加密方案要么依赖特定硬件,要么由于巨大的计算开销导致推理速度从“毫秒级”退化到“分钟级”。
来自字节跳动和南京大学的研究团队推出的 AloePri,通过一种巧妙的**协变混淆(Covariant Obfuscation)**机制,首次在数百 B 参数量级的模型(如 Deepseek-V3)上实现了零感知性能损失且具备实战级的隐私保障。
1. 核心直觉:从“数据打码”到“密文对齐”
传统的隐私保护思路往往是在输入端“打码”(如添加高斯噪声),但这种做法会破坏 Token 的语义,导致模型“不认识”输入,精度大幅下降。
AloePri 的 Insight 在于: 既然数据变了,我们为什么不同步改变模型? 通过协变变换,作者将模型参数与混淆后的 Token 空间进行了数学上的对齐。简单来说,虽然云端服务器处理的是看似杂乱无章的混淆 Token,但在这些混淆后的权重作用下,模型内部的计算逻辑在数学上依然与明文逻辑等价。
2. 协变混淆的架构解析
AloePri 的工作流程分为离线与在线两个部分:
- 离线阶段(客户端):生成一个秘密的排列矩阵 和一组可逆变换矩阵。
- 权重变换:对 Embedding 层、Attention 头部及 FFN 模块进行联合变换。比如,Embedding 矩阵变换为 。
- 在线阶段:客户端只需利用 对 Prompt 进行快速映射,服务端即可像运行普通模型一样执行推理。
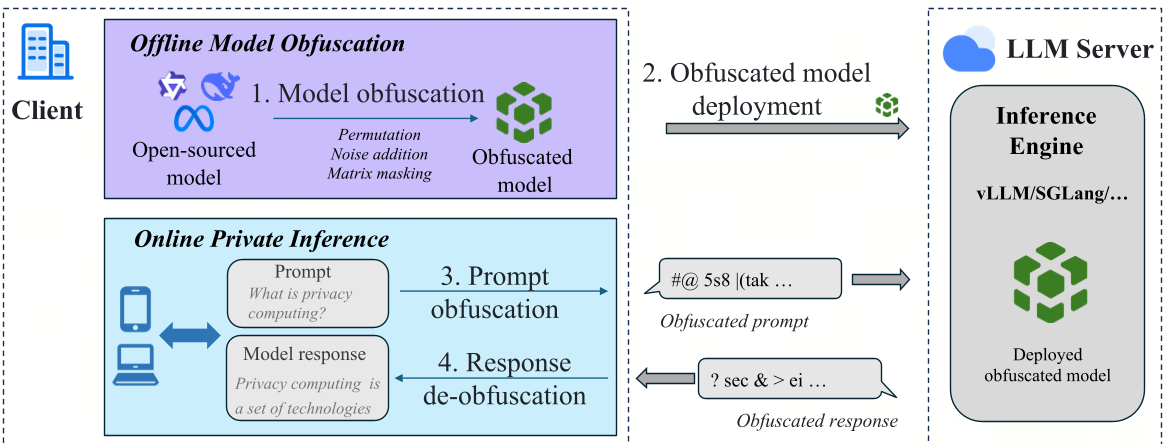
为了保证多个复杂层叠加后的准确性,论文提出了三个组合定理(顺序、并行、求和),为这种变换提供了严密的数学基础,证明了误差在层间传递是受控的。
3. 应对强力攻击:多维度的安全栅栏
仅仅随机打乱 Token 顺序是不够的,攻击者可能通过词频分析或模型内部状态反转(Inversion Attack)来还原原始语义。AloePri 设计了多重防御:
- Intra-head 变换:在 Attention 机制内引入旋转矩阵(RoPE)的块随机排列,打破跨头相关性。
- 噪声注入:在首尾层应用 Metric Differential Privacy (mDP) 理论,为防御词表匹配攻击(VMA)提供可量化的保证。
4. 实验结果:无痛迁移至 671B 大模型
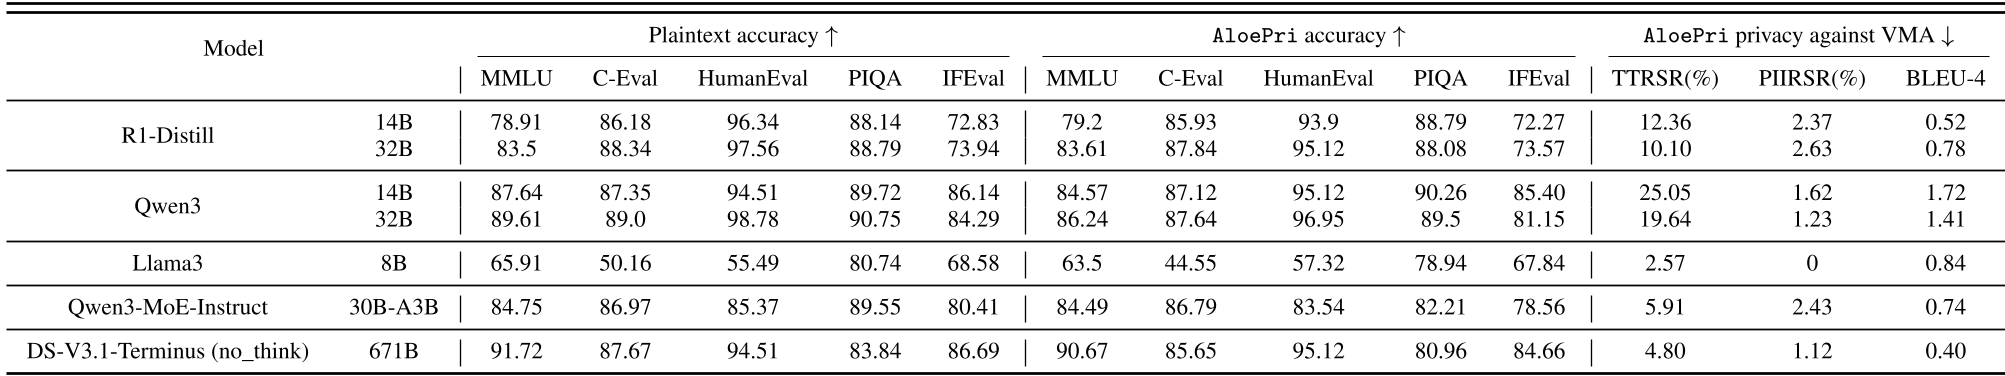
在 Deepseek-V3.1-Terminus (671B) 等模型上的实验极具说服力:
- 精度损失:在 MMLU、HumanEval 等主流榜单上,精度下降控制在 0%~3.5% 之内,远好于之前的工作。
- 效率指标:TTFT (首字延迟) 和 TPOT (每字延迟) 与明文推理几乎完全一致。
- 防御效果:面对目前已知最强的词表匹配攻击,其 Token 恢复率(TTRSR)低于 5%,而旧方法如 SGT 的恢复率甚至接近 100%。
5. 总结与前瞻
AloePri 的意义在于它通过“软件协同变换”绕过了隐私计算对底层硬件的依赖。它不要求云厂商配置昂贵的 H100 TEE 或牺牲吞吐量。
局限性分析:虽然它保护了输入输出交互,但客户端在离线状态下需要一次性下载并变换庞大的模型权重,这对于超大规模模型(如 671B)需要约 8 小时的处理时间。未来的研究方向可能会集中在如何通过 FHE(全同态加密)让客户端在不获取完整权重的条件下完成混淆。
总而言之,AloePri 为 LMaaS 场景下的端到端隐私保护提供了一个极其务实且高性能的范式,是隐私工程领域从“理论探讨”迈向“大规模部署”的重要里程碑。