
ProceduralGraph:把过程知识显式图化,让 LLM agent 边执行边改写自己的动作转移
Procedural Graphs: Self-Evolving Execution Structures for LLM Agents
本文提出 ProceduralGraph(PG),一种把过程性知识显式编码为(procedure, relation, procedure)三元组的有向属性图,用于引导 LLM agent 的动作选择。框架分在线生成式引导与离线自进化两阶段,其中 LLM refiner 通过对比失败与成功轨迹提出图编辑,并用验证门控决定是否接受。在六个基准、四个 LLM 上,PG 在 24 个模型-基准设置中的 21 个取得第一或并列第一,且自进化能从最小骨架构建出媲美甚至超过手工图的结构,并修复有缺陷的专家先验。
核心速览
TL;DR:本文提出 ProceduralGraph(PG),一个用(procedure, relation, procedure)三元组显式表达"下一步该做什么、按什么顺序、在什么条件下"的有向属性图。在线推理时,框架定位 agent 的当前活动节点,由一个 guidance LLM 把周围子图翻译成情境引导并附加到 solver 提示里,软性偏置而非硬性规定下一步动作;离线时,LLM refiner 对比失败与成功轨迹提出拓扑与属性编辑,只有不降低留出验证分数的候选才被接受,被拒候选记入拒绝记忆以防止重复提议。在六个基准、四个 LLM 上,PG 在 24 个设置中 21 个排第一或并列第一;从最小骨架自进化出的图可媲美手工图,并能把初始有害的专家先验从 58.93% 拉回 92.86%。
背景定位:这是一篇方法改进型工作,而非纯刷榜。它的坐标系位置很清晰——在 CoALA 认知架构里,工作记忆、情景记忆、语义记忆都已有较成熟的检索范式,唯独 procedural memory(程序性记忆)"received the least explicit treatment",通常隐没在权重或散落的提示模板里(见 Appendix A.1)。PG 试图填的就是这块空白:提供一个既可逐步检索、又能从执行反馈直接编辑的过程知识载体。与最相关的 AutoGuide 相比,它的差别不在"条件指引"本身,而在于把这些指引放进一张带类型的连接图里,从而支持结构检索与图编辑(Appendix A.4 明确指出)。
问题与动机
要理解 PG 的价值,得先看清现有结构化先验各自的失效机制。文本记忆与自反思方法(Reflexion、MemoryBank、ExpeL)把经验存成自由文本,检索回来的是"发生过什么",而"solver 必须自己重建它如何适用于当前步骤、又如何约束后续步骤"——这一步重建本身又交给了自由生成,于是结构在注入时已经丢失。状态条件指引(AutoGuide)给得更具体,形如"在情境 X 下动作 Y 合适",但它检索的是孤立规则,没有把前后步骤的连接边暴露出来。显式工作流与状态机(FlowBench、AFlow)把步骤讲清楚了,代价是执行被硬约束且通常要人工设计;离线工作流搜索虽减少人工,却仍是"先定结构后执行"。
作者的直觉是:一个 agent 需要的过程知识应当同时满足四个属性——结构化到足以把它引离非法行为、灵活到不抹杀推理自由、对当前进度敏感、并能从经验改进。这个直觉不是纯工程拍脑袋,而是被两类证据提示的:一类是文档化的失败模式(planning hallucination、长轨迹 drift、反馈歧义下的重复循环,见 §1 与 Appendix A.2);另一类是知识图谱这一已被验证的三元组组织范式——既然 (entity, relation, entity) 能回答 what-is,那么对称的 (procedure, relation, procedure) 是否能回答 what-to-do?PG 正是对这个对称性的实现(Figure 1 的对照)。
核心章节:从静态图到自进化闭环
出发点:把过程知识写成可编辑的三元组图
PG 的形式化定义如下:
其中 是抽象节点集,每个节点代表一个工具函数、一项技能、一个内部推理步骤或一个任务状态; 是转移关系的词表; 是三元组边的集合,一条边 表示"在关系 下,节点 在节点 之后是合法的"; 把每条边映射到一组命名属性,实现中固定用三个文本字段——condition(何时适用)、guidance(怎么继续)、pitfalls(要避免什么)。这个式子承担的角色是把过去散落在提示里的"下一步合法性"提升为图的一等对象:关系类型不是任意字符串,而是封闭词表,论文 §4 与 Appendix B.4 报告所有基准共用一套四类关系,即 LEADS_TO、TRIGGERS、PROVIDES_INPUT_FOR、CONVERGES_TO,且多数边填满三个属性、其中 guidance 填充最稳定。边界在于:它只声明"转移合法",并不强制执行——真正让 agent 不越界的是下一节的软引导,而非图本身;若把 退化为单一泛化关系,PG 就塌缩成一条纯转移表,丢掉"为什么可以走"的语义,也失去按关系类型检索的能力。
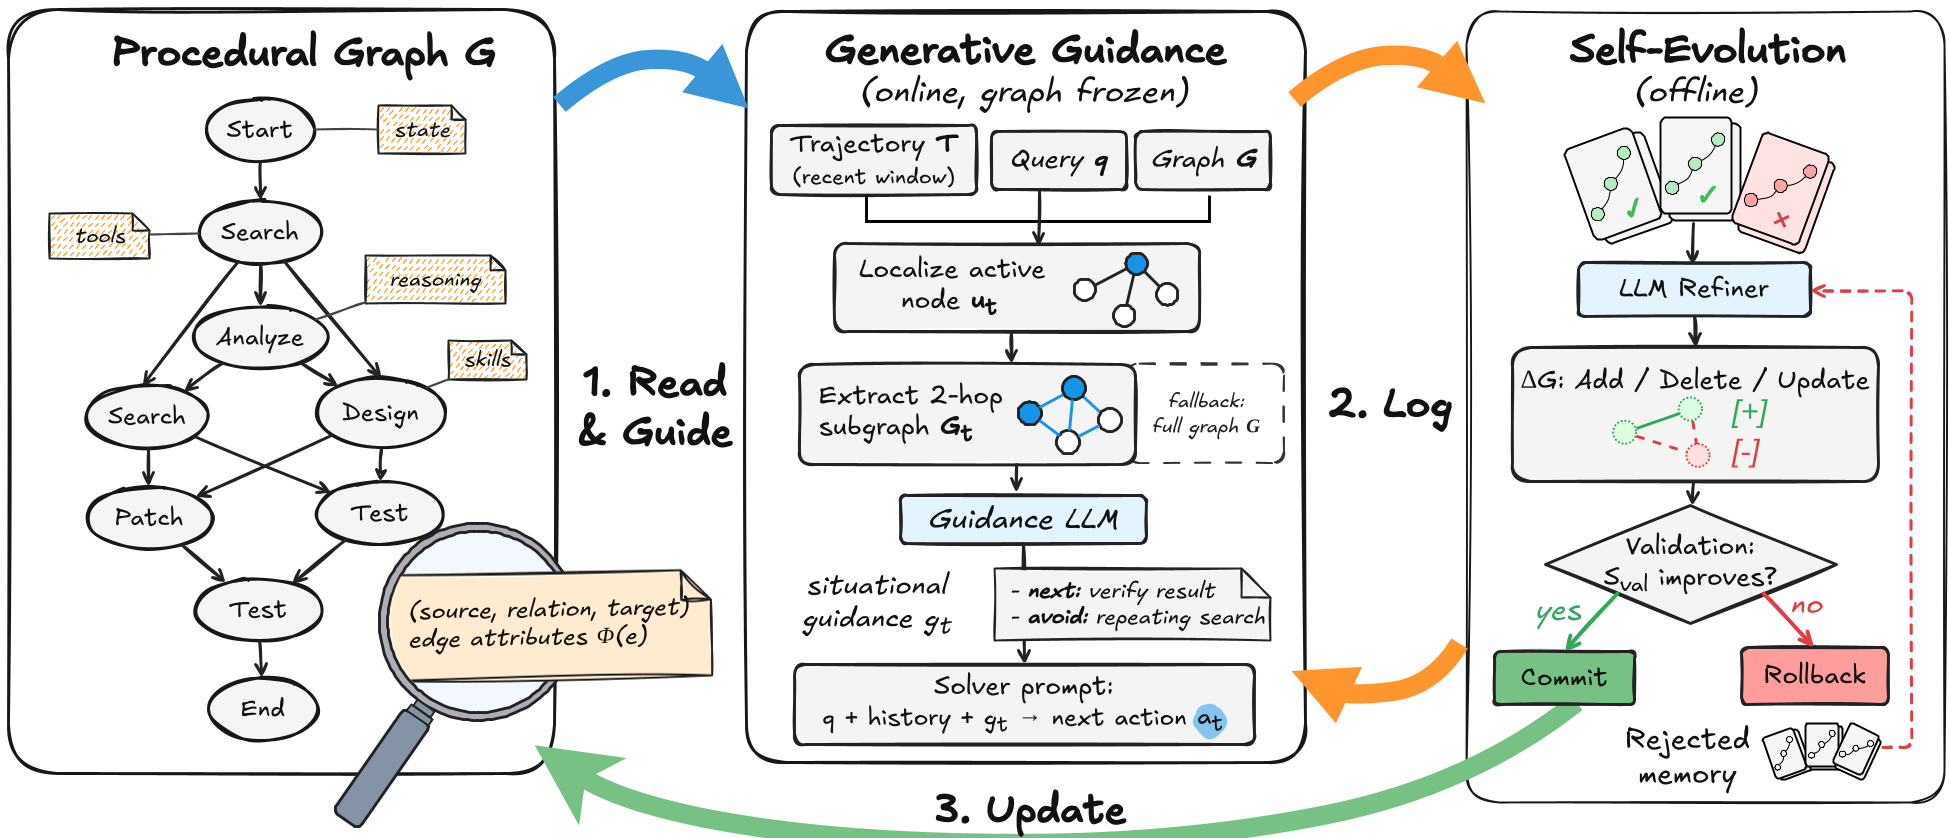
框架总览如上图所示:左半是静态的三元组定义,右半是动态的编辑回路,中间是在线检索与生成的衔接点。值得强调的是,图把知识放在模型权重之外,因此可以在不重训的前提下被检视、检索和改写——这正是它与微调类工具学习(Toolformer、Gorilla)的根本分野。
本文的改动:生成式引导 = 定位 + 提取 + 生成
独立检索转移属性(例如 top- 相似度搜索)的问题在于会切断步骤间的连接。论文 §3.2 举了个例子:只取到 submit 的指引而漏掉其前置的 check_answer,就可能跳过让提交"成立"的校验步骤。Generative PG Guidance 用三步操作解决它。第一步定位活动节点:
其中 是 agent 上一步执行的最近过程(一次工具调用),Match 做的是与该最近过程到节点集 的精确匹配,并以 作为初始化标记,使第一步定位在 。这一步的作用是把"agent 现在走到哪"投影到图上的一个锚点,它是后续一切局部检索的前提;若匹配失败( 为空),框架回退到使用整张图 ,从而保证不会因定位错误而完全无引导。
第二步提取连通邻域。设 为从 出发、沿有向边至多展开 步得到的子图,论文实现取 :
这里的关键设计理由是"为什么是连通邻域而不是 top- 相似边"——因为只有保留结构连接,guidance LLM 才能在拓扑上下文里读出当前动作及其前置条件,并看见最多 步之后可能的方向。把 设成 0 会退化为只看当前节点(丧失前瞻),设得过大则子图膨胀、引导 token 暴涨,这恰是后文消融要验证的权衡。
第三步生成情境引导,并把最近 步轨迹窗口一并喂入:
其中 是用户查询, 是最近 步动作-观察交替历史(实现取 ), 把静态属性 翻译成情境引导 ,指明 immediate goal 与要避免的格式或逻辑错误。这一步是"软整合"的核心:它不是把图塞进 prompt 让 solver 自己读,而是先由另一个 LLM 把图与轨迹融合压缩成自然语言指令。最后 solver 的动作选择为
其中采样仍由 solver 主导,引导只是条件之一,因此"推理自由"得以保留——这与 AFlow 之类把执行焊死在工作流上的做法形成对照。若把 置空,公式退化回普通 ReAct;论文 §5.5 的 Table 3 正对比了这种退化前后的差异。
依据与代价:离线自进化的门控闭环
有了图,谁来建、谁来改?PG 把这部分交给一个不依赖人工的闭环。每轮 从保留图 出发做四步。Step 1 诊断 rollout:用当前图跑一批训练任务 ,记录轨迹与得分 ,refiner 比较高分与低分轨迹,对二元任务即"成功对失败"。Step 2 反馈驱动变异:refiner 生成结构化编辑集 ,包含 Add(补漏校验节点/边)与 Delete(移除反复引向失败的节点/边),属性修订复用同一编辑接口(删边再以新属性重加),候选图经 应用,并做配置项决定的环修复。
为什么接受与否的判据是验证集而非训练集?论文给出的形式化是留出验证上的平均任务分:
其中 是与训练、测试都不重叠的留出集(§4 与 Appendix B.1 给出规模:HotpotQA 1000、MultiChallenge 100、EnterpriseArena 20 episodes)。这个式子在论证链里充当"过拟合防火墙":训练批次上成功的编辑可能在验证分布上失效,门控只看 。保留规则是候选只要不小于当前图的缓存分就被接受(含平局),即
否则维持 。其反事实是:若把判据换成训练分,闭环会不断采纳只在采样轨迹上"看起来更好"的编辑,自进化会朝噪声方向漂移;若改成严格大于,则平局编辑被拒,可能错过无害但有用的属性修订——论文接受平局,是用一点保守换取拓扑探索的自由度。
第四个设计常被低估:拒绝记忆 。当候选被门控拒绝(),其图、编辑、关联训练轨迹与验证结果都被记入拒绝记忆,下一轮 refiner 以"负证据"形式拿到它:
其中 是拼接后的轨迹上下文(超出 时从头截断、保留尾部,以保住轨迹结尾而非前缀)。它解决的是自修正的反复提议同一等价失败编辑这一已知病灶;若删去这一项,refiner 会在错误候选上反复打转,门控虽仍能拦截,却会浪费大量验证 rollout。Algorithm 1(Appendix B.6)把这套"保留 checkpoint 状态 + 结构检查前置"的流程写成显式伪代码,其中结构校验失败的候选甚至不触发验证 rollout,被拒项连同诊断写回拒绝记忆。需要指出论文也坦承一个代价:引导调用本身引入额外 token,即便它降低了 solver 步数,总消耗可能上升(§6 结论与 §5.5 量化)。
实验与证据
主结果:Table 1 在六个基准上比较了 PG 与七个基线(Vanilla ReAct、MemoryBank、RAP、ExpeL、AutoGuide、AWM、KnowAgent),所有方法共享同一 ReAct solver,学习型基线消费与 PG 完全相同的训练轨迹。下表摘录 Claude Sonnet 4.6 这一组,完整数值含置信区间见 Table 1:
| 方法 | HotpotQA 准确率 | MultiChallenge 准确率 | GDPval 评分 | ALFWorld 成功率 | tau-bench Pass@1 | BFCL v3 准确率 |
|---|---|---|---|---|---|---|
| Vanilla ReAct | 74.60 | 83.73 | 46.23 | 86.57 | 66.09 | 61.00 |
| ExpeL | 75.20 | 89.16 | 48.22 | 91.79 | 71.30 | 60.00 |
| AWM | 73.90 | 89.76 | 40.61 | 67.16 | 66.96 | 62.00 |
| KnowAgent | 74.30 | 87.35 | 42.14 | 87.31 | 61.74 | 60.00 |
| ProceduralGraph | 74.50 | 89.76 | 51.49 | 93.28 | 73.91 | 67.00 |
差距结构很说明问题:PG 在 GDPval、ALFWorld、tau-bench、BFCL 这类"过程性强"的基准上领先明显,而在 HotpotQA 上与 Vanilla 几乎持平(74.50 对 74.60)——因为多跳问答的步骤依赖弱,显式过程图没有额外可编码的转移。跨全表的汇总在 §5.1:PG 在 24 个设置中 21 个排第一或并列第一,与每个设置最强基线相比 19 胜 2 平 3 负(单侧符号检验 )。最大三处增益同样来自过程密集任务:BFCL v3 上 Gemini 3.5 Flash 从 58.00% 到 67.00%、GDPval 上 Gemini 3.1 Pro 从 71.37 到 78.78、tau-bench 上同模型从 73.04% 到 80.00%。一个诚实的观察是:没有任何单一基线能稳定排第二,说明"什么算最强对手"本身随任务与模型波动,PG 的胜出因此更像鲁棒性优势而非对某一种记忆的针对性超越。
长程韧性(主结果图):EnterpriseArena 是一个最长 132 个月、含三次不向 agent 披露的宏观危机的 CFO 模拟。Table 8 与 Figure 3 给出跨四模型的生存曲线与现金轨迹:
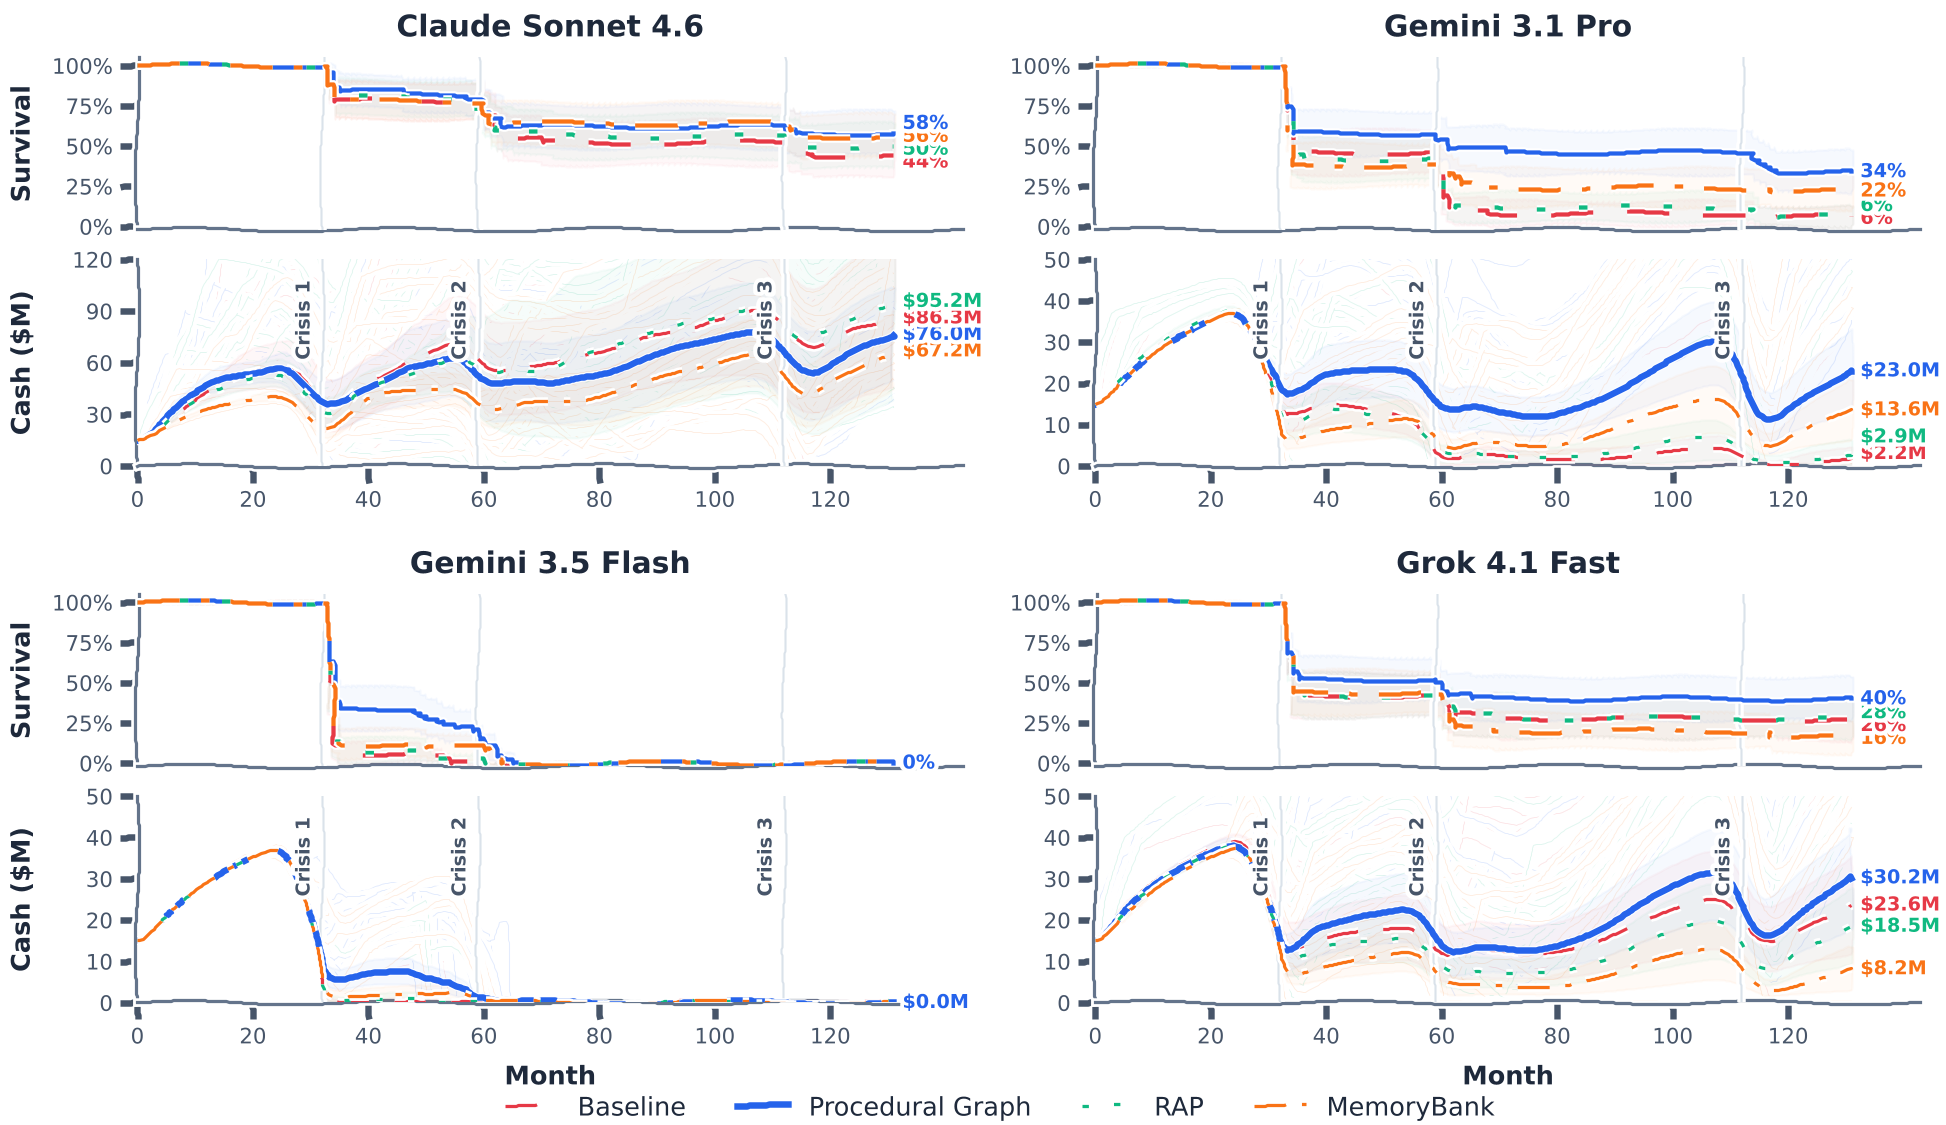
PG 把满程存活率从 Claude Sonnet 4.6 的 44.0% 升到 58.0%、Gemini 3.1 Pro 的 6.0% 升到 34.0%、Grok 4.1 Fast 的 26.0% 升到 40.0%。更值得注意的是机制归因:变化的是"何时调用哪个工具"而非"调用多不多"。无引导的 Gemini 3.5 Flash 基线在单回合内反复查现金与市场,每月 18.94 次工具调用,PG 把它降到 12.53 并提升企业分;而 Claude 与 Gemini 3.1 Pro 上工具调用反而从 0.13 升至 0.36、从 0.89 升至 3.18——因为图把 agent 引向"融资前先做预测和市场核查"。真正拉活命的是前瞻式融资:资本有 1 到 6 个月交付时滞,基线 Flash 平均融资 9.39M、Grok 4.1 Fast 拿到 $30.11M。Appendix C.3 的逐轨对比把这点落到实例:基线在危机中因违反"单一待处理融资"约束而被环境拒单,PG agent 则提前在稳定月份提交并链式核查 runway。
构造策略(消融表):Table 2 对比五种初始化与演化组合,揭示自进化的真正卖点:
| 构造模式 | HotpotQA 答案 F1 | MultiChallenge 总体成功率 |
|---|---|---|
| 无引导基线 | 71.21 | 87.50 |
| 模式1 手工专家 | 76.61 | 58.93 |
| 模式2 专家加一次静态更新 | 77.16 | 53.57 |
| 模式3 专家加在线进化 | 76.34 | 92.86 |
| 模式4 从零加静态构建 | 69.49 | 89.29 |
| 模式5 从零加在线进化 | 78.79 | 91.07 |
这张表最反直觉也最有价值的信息是模式1:一个手工专家图在 MultiChallenge 上把成功率从基线 87.50% 拖到 58.93%,单次静态更新(模式2)甚至更差到 53.57%。但把"新鲜执行反馈 + 验证门控"的迭代组合上(模式3),同一被污染的专家先验被拉回 92.86%,相对专家初始化净增 33.93 点。这等于说闭环不只是"建图工具",更是"修图工具",能纠正一个初始降低性能的人类先验。另一方面,从零演化的模式5 在 HotpotQA 上反而最高(F1 78.79、EM 66.30,较基线各增约 7.5 点),说明先验并非必需——这与 §6 的结论一致。
效率与定位(机制消融表):Table 3 用同一张图、同一 solver 模板、Gemini 3.5 Flash,比较"看多少图"与"怎么用图"两个维度:
| 图配置 | MultiChallenge 准确率 | MultiChallenge 平均 token | GDPval 评分 | GDPval 平均 token | ALFWorld 成功率 | ALFWorld 平均 token |
|---|---|---|---|---|---|---|
| 无图基线 | 80.27 | 6,629 | 54.80 | 275,638 | 72.58 | 18,055 |
| 全图原始注入 | 86.60 | 10,164 | 57.17 | 264,680 | 70.34 | 21,062 |
| 全图生成引导 | 87.35 | 14,434 | 56.75 | 448,972 | 54.48 | 96,360 |
| 子图生成引导(本文) | 89.31 | 12,295 | 63.99 | 367,738 | 81.53 | 28,064 |
这张表是给核心章节设计选择的最直接背书:把整张图原始塞进 prompt 在结构化对话上有效(MultiChallenge 80.27 升至 86.60),却在具身执行上反而伤害(ALFWorld 72.58 降到 70.34);在全图上做生成引导更糟,ALFWorld 掉到 54.48 且 token 飙到 96,360。 localize 到子图再加生成引导,三个基准全部取最优(89.31、63.99、81.53),分别比无图基线高 2.0、6.8、9.0 点,相对全图生成引导在三个基准上把 token 降低 70.9%、18.1%、14.8%,并在 GDPval、ALFWorld 把 solver 平均步数从 28.20、21.84 压到 18.57、18.80。可见 的局部检索不是省算力的权宜,而是避免"结构过载"的必要条件。
自进化轨迹(拆解证据):Figure 4 跟踪 EnterpriseArena 上十轮的寿命与融资变化:
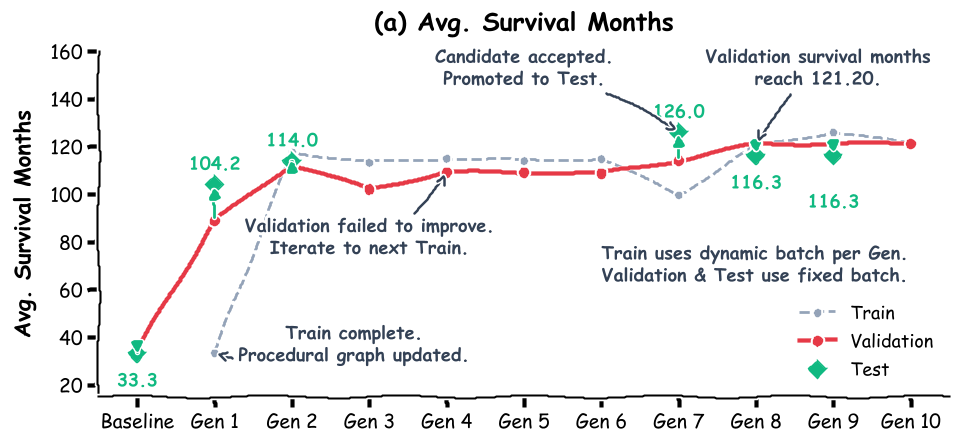
按 Appendix E 的逐轮表:Round 1 发现"先核查现金、预测 runway、再融资"的顺序骨架,验证存活率单次从 0.0% 跳到 45.0%;Round 2 在 Month_Start 后插入 recall_notes 把上轮 save_note 的笔记复用,抬到 80.0%,并把工具调用相对基线降到 3.08 次每月;Round 3 到 6 无接受更新(其一在 rollout 前结构校验失败);Round 7 剪掉 pass_action 分支,Round 8 加入行政绕过使验证存活到 90.0% 并维持到 Round 9,Round 10 被拒后循环终止。最终返回图在测试上达 85.0% 存活(Fisher 精确检验 ,相对基线 0.0%)。
证据质量评估:必须冷静看待两点。其一,论文作者自己声明每 split 仅 20 episodes,"individual accept/reject decisions turn on one or two episodes",因此逐轮的接受/拒绝应被读作搜索轨迹而非显著性检验——这是诚实的标注,但也意味着单轮结论不稳,只有跨模型、跨基准的宏观趋势(Table 1 的 21/24 与符号检验)才具备较强统计支撑。其二,PG 的优势并非普适:它在弱过程依赖任务(HotpotQA)上与基线齐平,在 Gemini 3.5 Flash 上四种配置都 0.0% 满程存活、仅改善平均寿命,说明当模型本身能力成为瓶颈时,结构先验无法凭空造出执行力。
深度洞察与总结
总结:PG 的核心贡献可落到三处机制上。一是表示层,用带 condition/guidance/pitfalls 属性、关系词表封闭的有向属性图,把"合法转移"显式化并置于权重之外;二是推理层,定位加连通邻域检索加生成式翻译的三步把静态图变成情境引导,软偏置而不硬约束;三是优化层,验证门控加拒绝记忆的闭环让图从最小骨架自我构建、自我修复,且编辑的是结构而非参数。
局限性(具体且可证伪):第一,统计功效受数据规模限制——每 split 20 episodes 使逐轮接受/拒绝依赖一到两个样本,作者已声明其应作搜索轨迹解读,这削弱了"某一编辑确实带来某增益"的因果声称。第二,节点与工具目录的一致性缺乏强制:Appendix B.6 写明 ACTION 节点须匹配可用工具名"是 refiner-prompt 要求,通用结构校验器并不独立检查 tool-catalog membership",因此一次不合规的加节点可能绕过校验进入候选。第三,引导的 token 开销被反复承认(§5.5、§6),论文未评估跨步复用或选择性生成能否缓解。第四,跨 solver、跨工具接口的迁移性未被测试,结论段将其列为 future work,这意味着"学到的过程图能否复用"仍是开放问题。
未来展望:较有技术含量的方向包括——把引导从"每步新生成"改为对稳定子图缓存复用,以抵消 Table 3 里相对无图基线仍高 33.4% 与 55.4% 的 token;以及把结构校验器扩成能强制工具目录成员资格的验证器,从源头堵住非法节点;更彻底的是把验证门控的"平局即接受"换成带置信区间的贝叶斯式准入,以在 20 样本规模下把噪声从接受决策里剥离。