
Skill-Pro:赋予 LLM Agent 像人类一样的“肌肉记忆”
ProcMEM: Learning Reusable Procedural Memory from Experience via Non-Parametric PPO for LLM Agents
本文提出了 Skill-Pro 框架,旨在让 LLM Agent 从交互经验中自主学习可复用的“程序性技巧(Skills)”。该框架通过 Non-Parametric PPO 机制,在不更新模型参数的前提下,实现了极高内存压缩率(相比基线降低 100x+)和显著的 SOTA 性能提升。
TL;DR
大模型 Agent 真的需要每次都重新“思考”怎么开门或怎么解题吗?Skill-Pro 认为不需要。它通过模仿人类的程序性记忆(Procedural Memory),让 Agent 能从过往经验中通过“不去更新权重”的 PPO 算法学习并进化出一套“技巧(Skills)”。结果表明:用不到 1k tokens 的技巧库,就能打败存了数十万 tokens 历史记录的传统 Agent。
背景定位:从“历史书”到“操作手册”
目前的 Memory-augmented Agent 大多是在查阅“历史书”(情节记忆):它们把过去的每一次对话、每一个动作全存进数据库(RAG)。当 Agent 需要决策时,得被迫读完厚厚的历史记录。
这带来了三个致命痛点:
- 冗余性:上下文窗口被重复的操作占满。
- 不稳定性:每次即时推理都可能产生新的错误。
- 不可复用:历史记录很难直接跨任务或跨模型使用。
Skill-Pro 将视角转向了程序性记忆——一种直接将情况映射到动作模式的系统。
核心机制:Skill-MDP 与 Non-Parametric PPO
1. 技巧的形式化 (Skill Formalization)
作者将 Skill 定义为一个三元组 :
- 激活条件 ():什么时候用?(如:“当任务开始且没有反馈时”)
- 执行程序 ():具体怎么做?(由自然语言书写的一系列原子动作)
- 终止条件 ():什么时候停?(如:“产生第一个有效移动并观察到反馈时”)
2. 非参数化 PPO (Non-Parametric PPO)
这是本文最惊艳的部分。它不需要微调(Fine-tuning)模型的参数,而是通过两个步骤来进化“技巧池”:
- 语义梯度 (Semantic Gradients):不再计算损失函数的偏导,而是利用 LLM 的事后归因分析,根据轨迹反馈生成“更新建议”的文本(如:“增加一个历史记录检查步骤”)。
- PPO Gate (置信区域验证):为了防止 LLM 瞎改进(Hallucination),引入了一个 PPO 风格的过滤机制。它计算一个权重比例(Importance Ratio),只有当新技巧在过去轨迹上的期望收益显著为正且偏离度受限时,才允许加入技巧池。
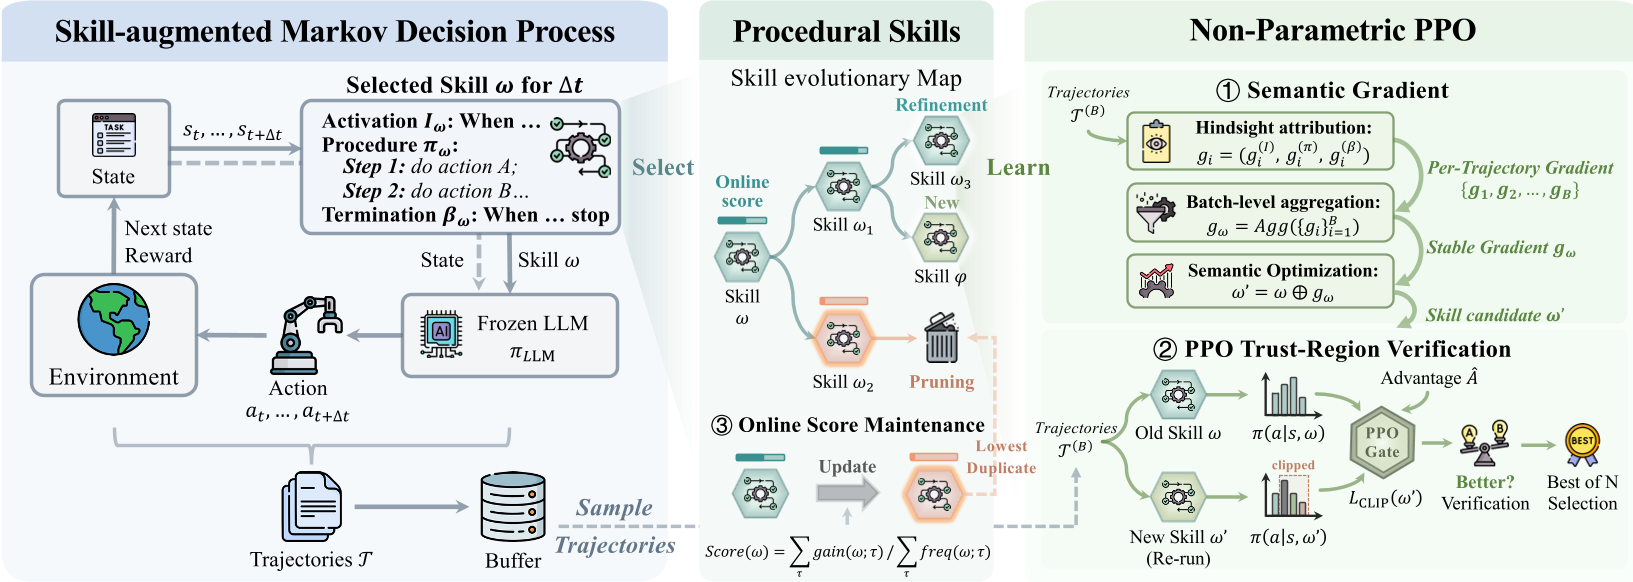 图 1: Skill-Pro 框架概览,展示了从轨迹收集到语义梯度提取再到 PPO Gate 验证的全流程。
实验与战绩:以极简胜繁复
极高的复用率与性能
在 ALFWorld 和 TextArena 两个挑战性的基准测试中,Skill-Pro 的复用率(Reuse Rate)在跨模型(Cross-agent)情况下仍然保持在 80% 以上。这意味着在 Gemma 上学到的技巧,直接拿给 Llama-3 用也同样有效。
令人震惊的效率对比
请看下表的数据对比,Skill-Pro 对内存的压榨达到了极致:
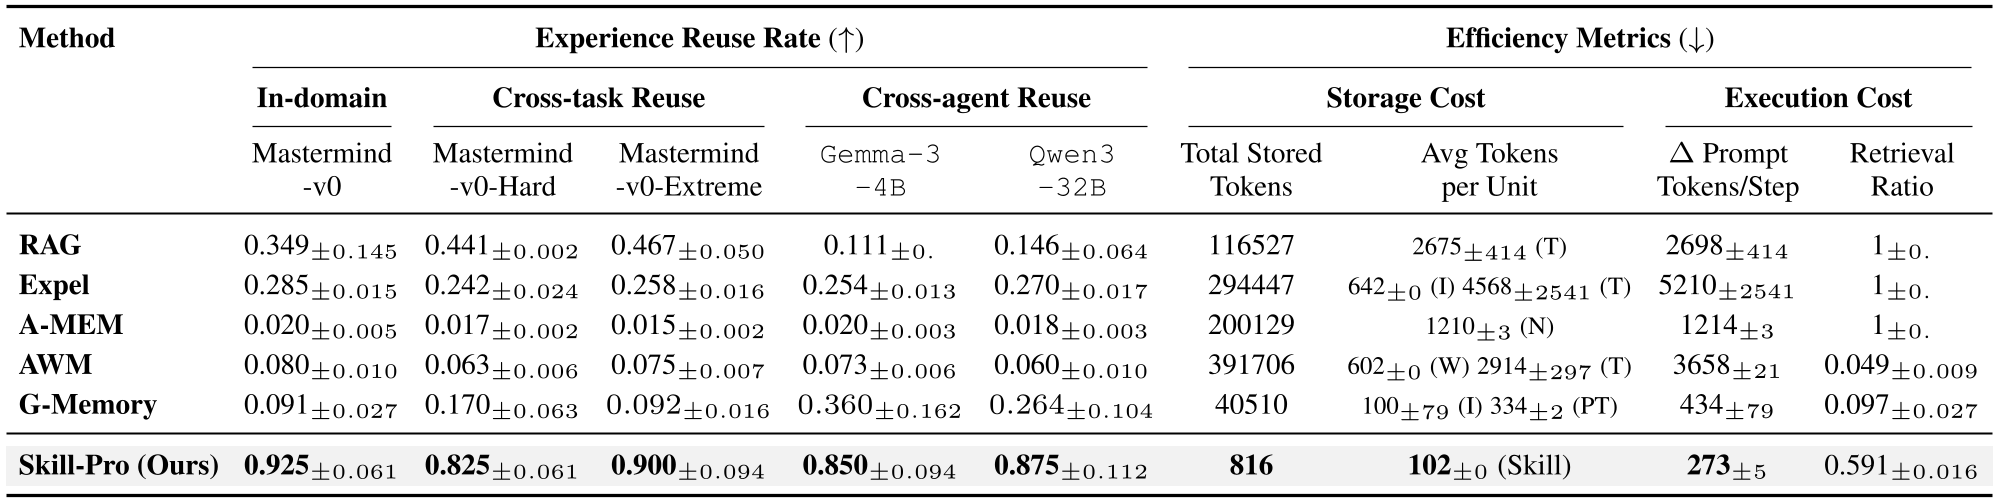 表 1: 效率指标。注意 Skill-Pro 的 Total Stored Tokens 仅为 816,而 RAG 和 Expel 动辄几十万。
- 记忆量:降低了 100 到 300 倍。
- 成功率:在 ALFWorld 上达到 0.90,远超基于 RAG 的 0.48。
消融实验:为什么不能没有 NP-PPO?
通过消融可以看到,如果不使用 PPO Gate 或分数维护机制(w/o Score),技巧池会迅速充斥低质量甚至错误的策略,导致性能雪崩。这证明了**“自动进化 + 严密筛选”**才是闭环学习的关键。
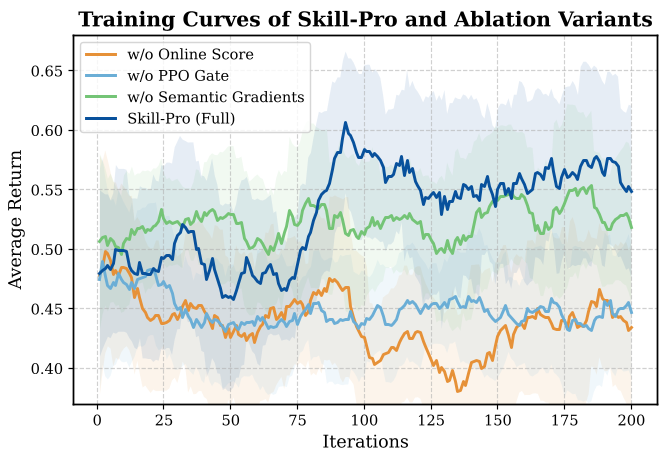 图 2: 技巧的演化谱系。展示了技巧是如何从原始种子阶段(v1)不断精炼、分裂并最终稳定为高价值版本的。
深度洞察与总结
Skill-Pro 展示了 LLM Agent 迈向长期自治的一个新阶段:
- 总结 (Takeaway):技巧的结构化(程序性记忆)比原始日志(情节记忆)在高阶智能中更重要。
- 局限性:目前技巧仍依赖自然语言描述,执行时仍然涉及 Token 处理。
- 展望:未来的方向应该是将这些 Explicit Skills(显式技巧)进一步压缩为代码或隐式策略,实现更接近人类肉体反射般的“肌肉记忆”。
如果你在构建需要长期运行、处理复杂循环任务的 Agent,Skill-Pro 的“技巧驱动”思路绝对值得参考。