
Proteus:破解循环网络长文本遗忘魔咒,零额外开销重构记忆调度新范式
Proteus: Incremental Memory Activation for Long-Context Sequence Modeling
2026-01-01
总结
问题
方法
结果
要点
摘要
本文针对长上下文序列建模中循环记忆模型(Recurrent Memory Models)静态容量分配的固有缺陷,提出了“增量记忆激活”(Incremental Memory Activation)新范式及通用机制 Proteus。该方法在序列初期施加容量瓶颈强迫信息压缩,随后随上下文增长逐步解锁新记忆块以避免干扰与覆写。在 SWLA、Comba、Titans 及 Hope-Attention 等 SOTA 架构上,Proteus 在零额外显存和参数开销下全面提升了通用语言建模与长文本检索性能。
1. 核心速览 (Executive Summary)
- TL;DR:现有记忆型循环神经网络(RNNs / SSMs)在处理长上下文时普遍采用静态容量,导致早期 Token 占用过多自由度并污染记忆状态,后期 Token 面临严重的写入干扰与覆写。本文提出的 Proteus 引入了**增量记忆激活(Incremental Memory Activation)**机制——早期设置容量瓶颈强迫模型紧凑压缩上下文,后期逐步解锁新记忆块提供全新容量。该机制作为纯轻量化调度策略,不引入任何额外参数与显存开销,全面刷新了多款 SOTA 模型的长文本表现。
- 背景定位:该工作跳出了以往“设计更复杂更新算子(如 Delta Rule、Momentum)”或“无限扩大记忆矩阵”的局部改良路线,从在线优化有效容量调度的全局视角切入,属于机制创新型的重要基石工作。
2. 痛点与动机 (Problem & Motivation)
静态记忆的“两难困境”
Transformer 依赖线性增长的 KV Cache 实现无损检索,但付出了 的计算复杂度代价。现代循环模型(如 RetNet、Mamba、Titans、DeltaNet)通过将历史压缩到固定大小的隐藏状态 ,实现了线性计算与恒定解码成本。
然而,现有方法普遍存在一个未被审视的假设:整个序列处理过程中,记忆状态的暴露容量是静态不变的。
这就直接诱发了在线优化中的严重失衡(Imbalance):
- 早期污染(Early Memory Pollution):序列初始阶段,状态几乎全空,模型缺乏压缩压力,倾向于利用全部自由度去“死记硬背”少量早期 Token,导致表征过拟合与状态污染;
- 后期干扰与覆写(Late-context Overwriting & Interference):随着序列增长,有效容量被前期信息消耗殆尽,后续到来的关键 Token 只能被迫挤入已饱和的状态中,造成灾难性的信息覆写与检索失效。
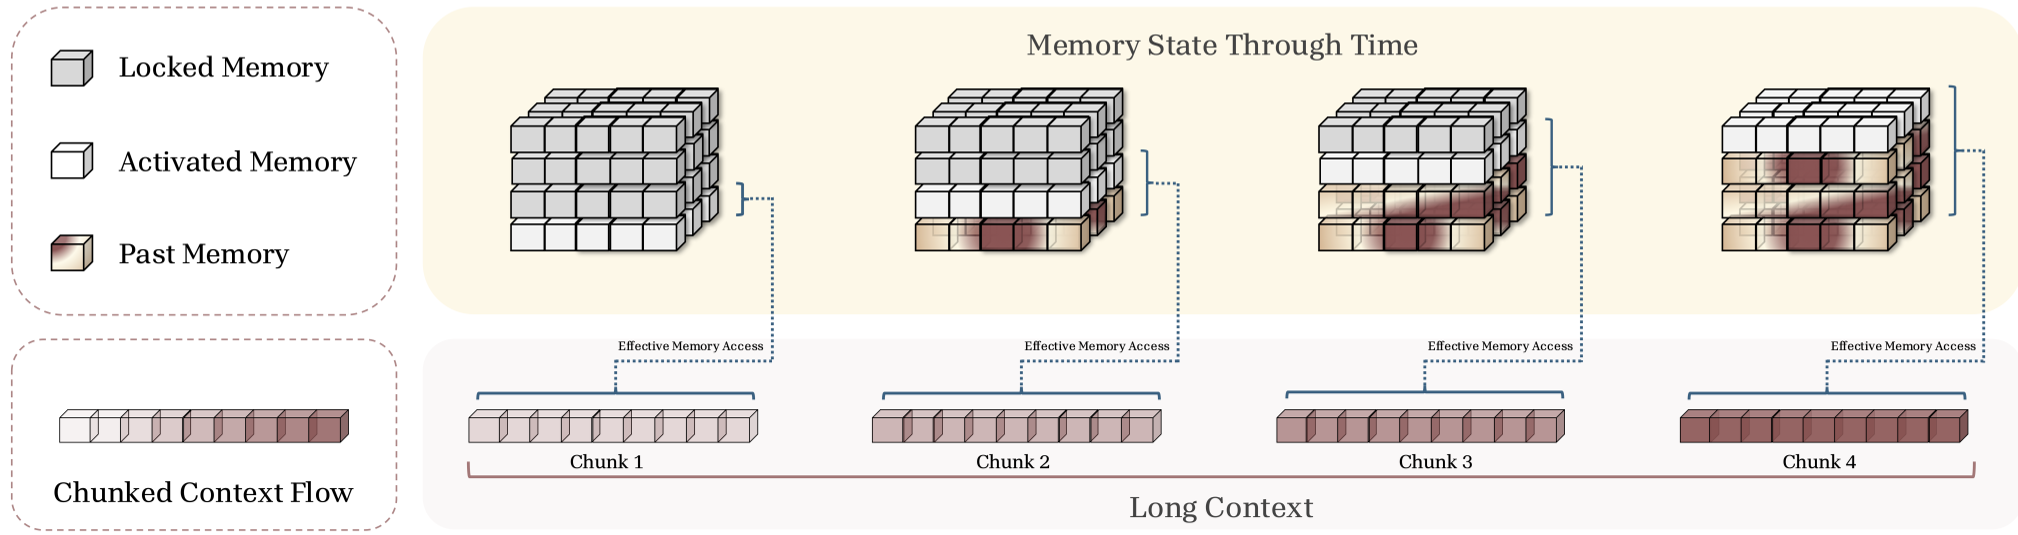
核心直觉 (Insight):容量不应在时间轴上均匀平铺。必须在早期强加瓶颈(Bottleneck)逼迫模型进行抽象摘要,并在长程演进中持续解锁“纯净的全新容量(Fresh Capacity)”,从而在根本上实现早期压缩与后期抗干扰的双赢。
3. 方法论详解 (Methodology - The Core)
3.1 联想记忆与在线优化形式化
将序列模型统一表述为联想记忆算子 ,其目标是最小化内部映射损失 。在在线处理各 Token 的过程即是在线梯度下降更新:
abla ilde{\mathcal{L}}(\mathcal{M}_{t-1}; k_t, v_t)$$ ### 3.2 Proteus:块级增量激活机制 Proteus 定义了一个基于位置 $t$ 的激活算子 $\mathcal{G}_t$,它由一个二进制掩码 $g_t \in \{0, 1\}^{ ext{dim}(\mathcal{M})}$ 驱动。受控的在线更新与读取操作被严格约束在激活子空间内: $$\mathcal{M}_t = \mathcal{M}_{t-1} - heta_t \big(g_t \odot abla ilde{\mathcal{L}}(\mathcal{M}_{t-1}^{(g)}; k_t, v_t)\big), \quad ext{其中 } \mathcal{M}_{t-1}^{(g)} = g_t \odot \mathcal{M}_{t-1}$$ $$y_t = ext{Read}\big(\mathcal{G}_t(\mathcal{M}_{t-1}), q_t\big)$$ 其关键约束性质为: $$(1 - g_t) \odot \mathcal{M}_t = (1 - g_t) \odot \mathcal{M}_{t-1}$$ 未激活的块被完全锁定(Locked),不参与读取,也不接收梯度更新,保持初始或先前状态不变。 ### 3.3 确定性增长调度方案 将记忆切分为 $E$ 个等长块(Block),若训练上下文长度为 $N$,步长定义为 $\Delta = \lfloor N/E \rfloor$。在第 $t$ 步时激活的块数量为: $$k(t) = \min\left(E, 1 + \left\lfloor \frac{t-1}{\Delta} \right\rfloor\right)$$ * Token 在 $[1, \Delta]$ 区间内,模型仅使用前 $1/E$ 的记忆容量,强制执行高压信息瓶颈; * 随着 $t$ 步进,掩码 $g_t$ 单调向后扩展,直至第 $N$ 步完全解锁所有 $E$ 个块; * 在推理阶段超过 $N$ 的序列长度处,全部状态保持完全开放。 ### 3.4 泛化至模型参数(Nested Learning 视角) 根据 Nested Learning 理论,MLP 层更新亦可视为一种广义联想记忆。Proteus 将该机制无缝推广至参数级优化,对优化器(如 AdamW)的一阶/二阶动量实施掩码门控更新: $$\boldsymbol{ heta}_{i+1} = \boldsymbol{ heta}_i - \eta_{i+1}(g_{i+1} \odot \boldsymbol{e}_i)$$ 该扩展在 Hope-Attention 架构上得到了完整验证。 --- ## 4. 实验与结果 (Experiments & Results) 实验在 FineWeb 数据集上展开(8K 训练上下文窗口),覆盖 760M(50B tokens)与 1.3B(100B tokens)两种参数规格,对比了 SWLA、Comba、Titans、Hope-Attention 以及 Transformer++、RetNet 等基线。 ### 4.1 通用语言建模与常识推理 如下表所示,加入 Proteus 后,所有骨干架构在 Wikitext / LAMBADA 困惑度以及 8 项零样本常识问答任务(PIQA, HellaSwag, WinoGrande, ARC 等)上均取得全面一致的提升。  * 在 1.3B 规模下,**Titans + Proteus** 取得了全表最佳的综合准确率 **58.00%**(相比 Titans 原版提升 1.05%),Wiki 困惑度由 15.36 降至 14.94; * 架构增益具备高度一致性,表明容量调度优化的有效性独立于底层具体模型设计。 ### 4.2 长上下文大海捞针 (Needle-In-A-Haystack) 在长文本多难度检索测试中,Proteus 的优势随着上下文长度的延伸而愈发显著。  * 在 16K 极端长度的单针 UUID 检索任务(S-NIAH-3)中,**Titans + Proteus** 准确率从 21.4% 暴涨至 **29.8%**; * 在 S-NIAH-2(数值检索)中,**Comba + Proteus** 准确率从 13.4% 跃升至 **21.2%**; * 多针检索任务(MK/MQ/MV-NIAH)同样展现出一致的抗退化能力。 ### 4.3 召回密集型任务与 LongBench 评测 在 SWDE、SQuAD 和 FDA 检索基准上,基础循环模型(如 Comba、Titans)的精度随长度增长往往呈现断崖式下跌,而 Proteus 显著拉平了退化曲线;在 LongBench 综合长文本评测中,Proteus 亦在 6 个核心子任务上实现了平均分的稳步提升。  ### 4.4 消融实验:分块数量 $E$ 的权衡 研究人员对分块数量 $E$(从 1 到 32)进行了细致消融: 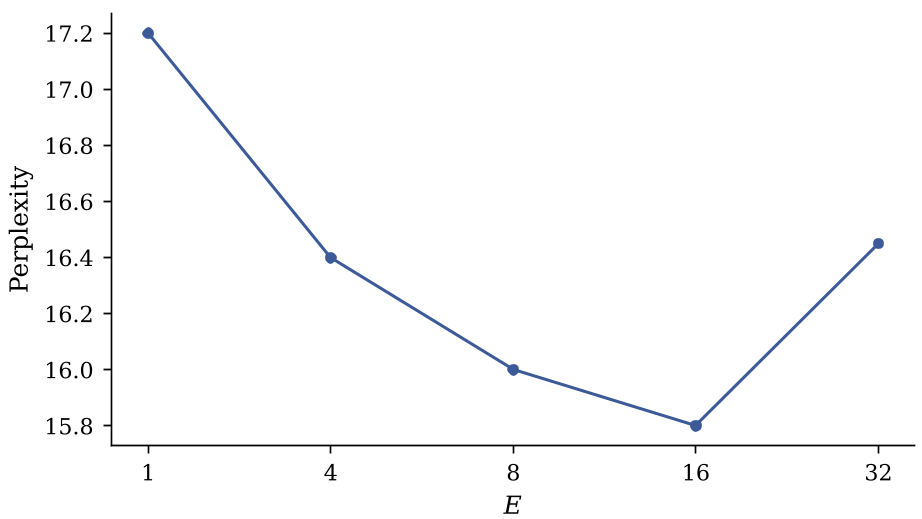 * $E=1$ 对应无调度的静态基线; * 性能随 $E$ 增加逐步提升并在 $E=16$ 达到最优; * 当 $E=32$ 时性能出现回落。这验证了核心假设:瓶颈过窄(首段仅暴露 $1/32$ 容量)会导致早期有效信息欠拟合,合理的调度粒度至关重要。 --- ## 5. 深度洞察与总结 (Critical Analysis & Conclusion) ### 核心价值 (Takeaway) Proteus 揭示了一个此前被忽视的架构盲区:**模型记忆能力的瓶颈不仅在于“如何写(Update Rule)”,更在于“何时暴露多少容量去写(Capacity Scheduling)”**。通过极其简单的分块掩码与增量激活,成功解决了循环网络长期存在的早期记忆污染与后期信息覆写难题。 ### 局限性 (Limitations) 1. **静态均匀调度**:目前的激活策略依赖于人为设定的固定分块与线性均匀步长,尚未建立数据自适应(Data-dependent)的动态路由机制; 2. **超长外推边界**:在训练窗口之外(如 $>8K$),所有块已全量激活,模型重新退化为静态记忆模式,其长程增益主要来源于前置状态的高质量压缩,而非持续的容量供给。 ### 未来展望 (Future Work) * **与动态扩容架构结合**:将 Proteus 的固定容量调度与 Memory Caching(动态增长记忆)相结合——训练窗口内进行增量激活,超出窗口后动态申请新物理内存,构成完整的无限长上下文管理方案; * **内容感知自适应激活**:结合强化学习或轻量 Router,根据输入 Token 的信息熵或“惊奇度(Surprise)”动态决定记忆块的解锁时机与步长; * **持续学习与在线适配**:将增量参数激活迁移至 Continual Learning 场景,有效遏制新任务对旧知识参数的灾难性遗忘。