
Psyche-R1:心理学 LLM 的新高度——共情、专业与推理的深度融合
Psyche-R1: Towards Reliable Psychological LLMs through Unified Empathy, Expertise, and Reasoning
本文推出了 Psyche-R1,这是首个整合了共情能力、专业知识和推理机制的中文心理学大语言模型。该模型基于 Qwen2.5-7B 骨干,通过创新的数据合成管线(包含 75k 高质量心理推理数据和 73k 共情对话)以及混合训练策略,在 7B 规模下达到了与 671B 的 DeepSeek-R1 相当的心理学专业表现。
核心速览 (Executive Summary)
TL;DR:Psyche-R1 是由合肥工业大学、港中文(深圳)等机构联合推出的首个兼具共情(Empathy)、**专业知识(Expertise)与逻辑推理(Reasoning)**能力的中性心理学 LLM。通过一种“冷热数据分类”后的混合训练范式,这款 7B 规模的模型在多个心理学专业基准测试中击败了 GPT-4o,甚至在特定任务中比肩 671B 的 DeepSeek-R1 原生模型。
背景定位:在 AI 心理健康领域,该工作标志着研究重心从早期的“单纯拟人对话”转向了“严谨的临床级推理”。它是 DeepSeek-R1 式推理范武在垂直领域(心理学)成功落地的代表作。
1. 痛点深挖:为什么“懂道理”的模型不“懂人心”?
目前的心理 LLM 领域存在两个极端的遗憾:
- 专家 LLM 不够智能:如 SoulChat、EmoLLM,它们通过大量对话数据微调,回复听起来很暖心,但在面对复杂的心理案例分析(MCQ)时,往往因为缺乏深层推理能力而给出错误的诊断指导。
- 推理 LLM 不够专业:像 DeepSeek-R1 或 OpenAI o1 这样在数学、编程上封神的模型,在心理学场景下表现生涩。原因是心理学推理不仅需要逻辑(Logic),更需要基于共情的直觉(Empathic Intuition)和特定的临床规范。
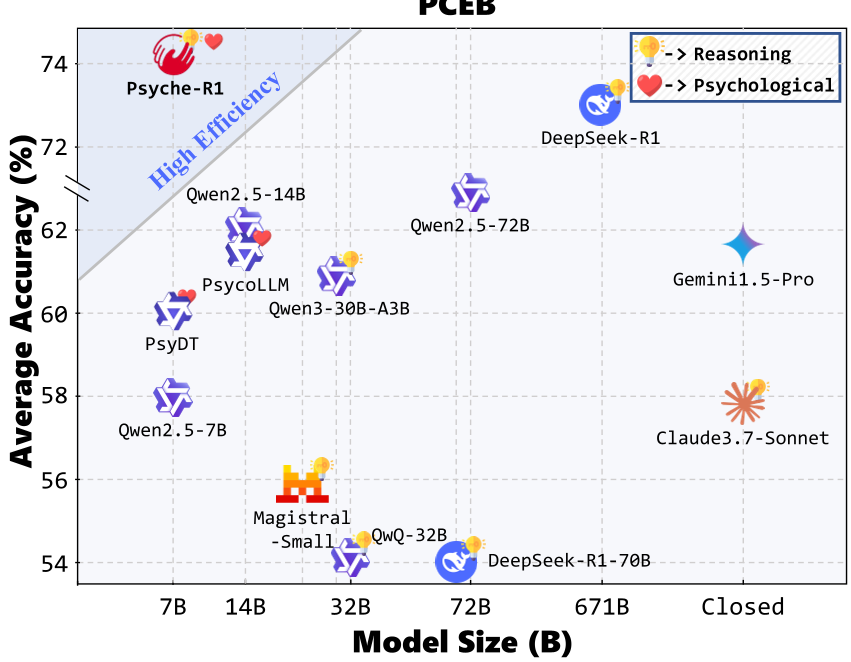 图 1:Psyche-R1 与主流模型在心理学基准上的性能对比,展示了其在小模型规模下的跨级挑战能力。
2. 方法论详解:从数据清洗到混合强化学习
Psyche-R1 的成功归功于一套严密的训练流水线:
2.1 高质量推理数据的“精炼术”
作者不仅收集了教科书和题库,更引入了 迭代提示词-推理优化(Iterative Prompt-Rationale Optimization)。
- Step 1: 使用 CoT 引导模型生成初始推理路径。
- Step 2: 如果答案错,则重写;如果对,则利用 LLM 自我反思去优化 Prompt 和 Rationale 的清晰度,共迭代 3 轮。 这种方法确保了模型学习到的每一条“思考链”(Think Block)都是逻辑严密且符合专业规范的。
2.2 多模型交叉筛选 (Multi-LLM Cross-Selection)
为了找出哪些问题真正需要“Reinforcement Learning”,作者让 Qwen、Llama 和 Phi 三个模型同时做题。三个模型都做错的题被定义为“挑战性样本”,进入 GRPO 强化学习阶段;其余相对简单的样本则用于基础的 SFT。
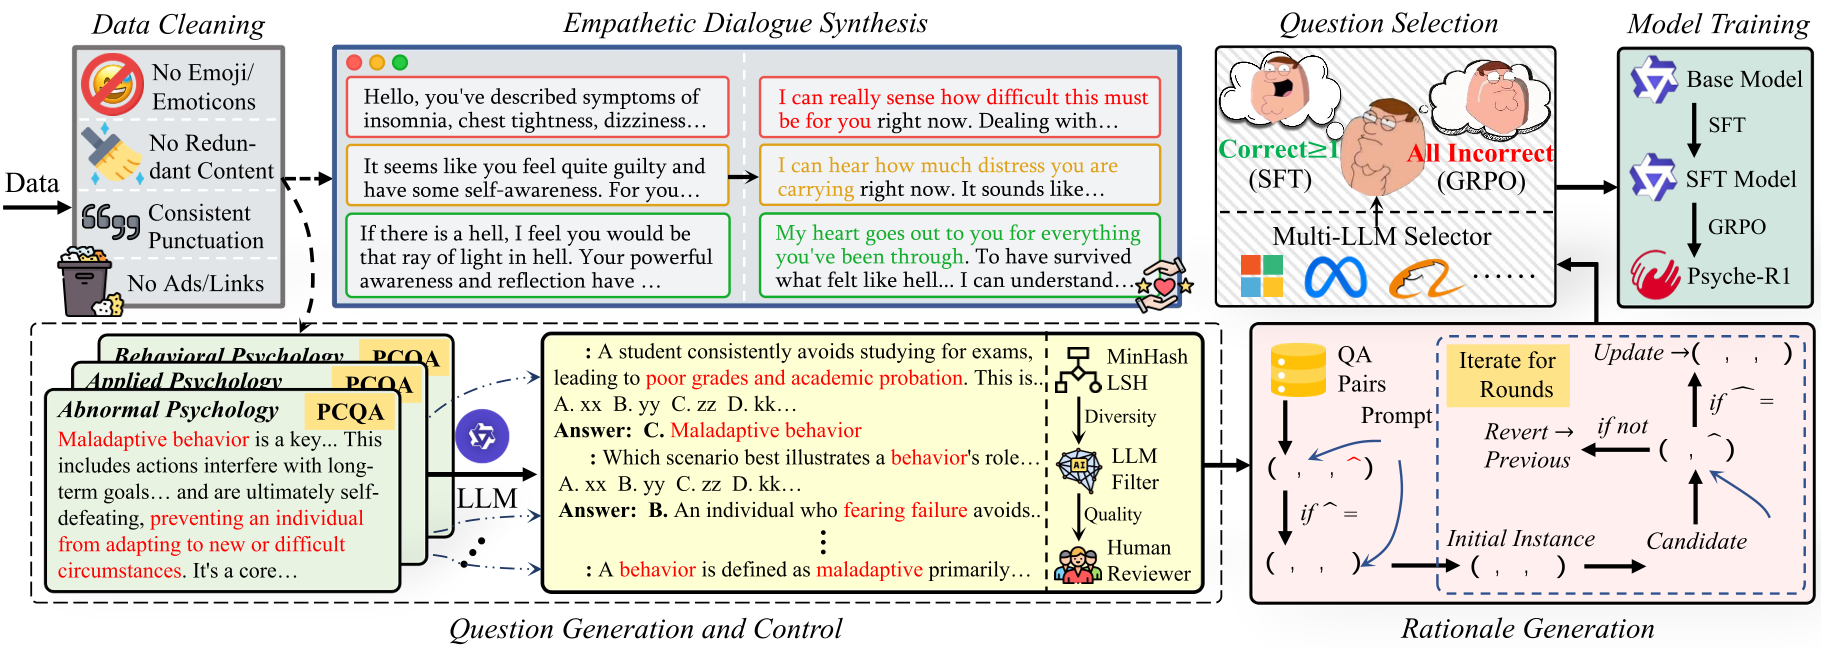 图 2:Psyche-R1 的整体架构,包括数据合成、指令微调(SFT)和群组相对策略优化(GRPO)的双阶段流程。
2.3 混合训练范式
- 第一阶段 (SFT):在 73k 共情对话和基础知识上微调,建立“专业且温柔”的模型底色。
- 第二阶段 (GRPO):借鉴 DeepSeek-V3 的做法,不使用额外的奖励模型(Reward Model),而是通过群组内的相对得分来更新策略。
- 格式奖励:必须在
<think>标签内思考。 - 准确性奖励:答案必须与真值匹配(支持多选部分的按比例打分)。
- 格式奖励:必须在
3. 实验与结果:7B 模型真的能战胜 671B 吗?
在 PCEB(中国心理咨询师考试基准) 上的表现令人惊艳:
- 综合得分:Psyche-R1 (7B) 达到了 74.37%,超过了 DeepSeek-R1 的 72.95%,更是远超 GPT-4o 的 49.96%。
- 多选题 (MMCQ):这一项最考验推理。Psyche-R1 在理论维度的多选题准确率比特化模型 PsyDT 高出近 10%。
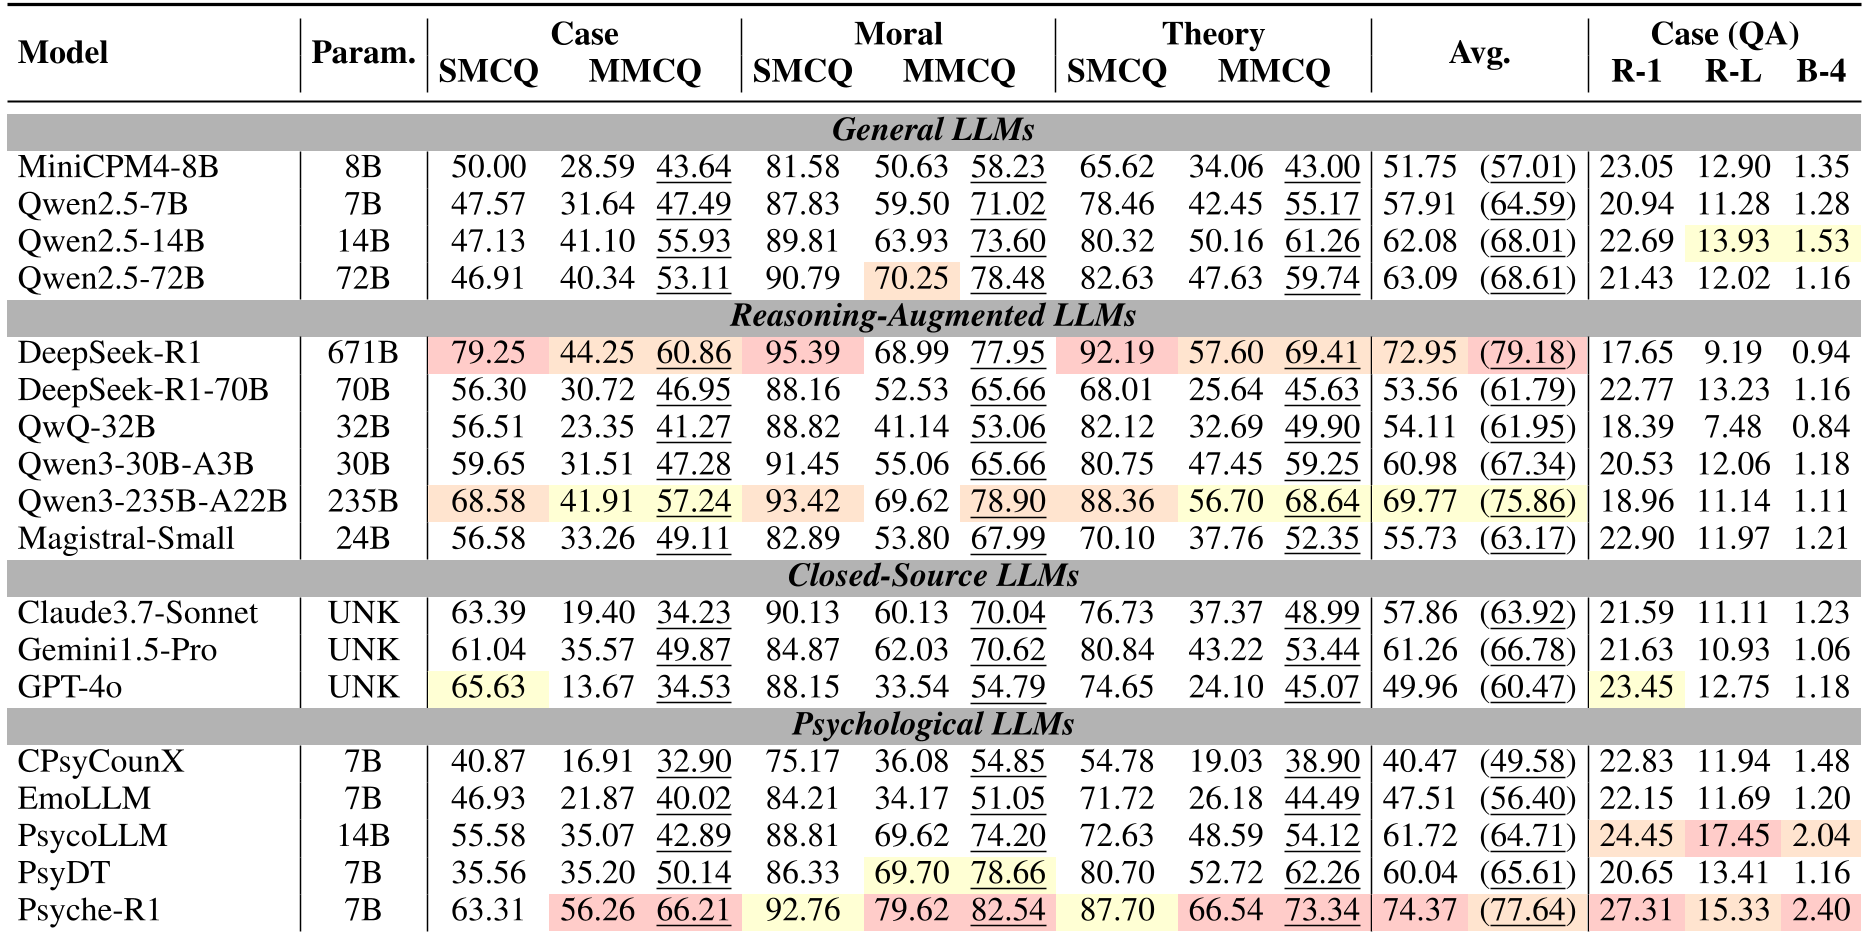 表 1:在 PCEB 任务上的详细评分,Psyche-R1 在案例分析、道德规范和理论知识三个核心维度均表现出众。
深度洞察:消融实验显示,如果去掉 GRPO 推理训练,模型在复杂案例分析上的性能显著下降(Δ -5.85%)。这证明了**“学会思考”**比单纯“记住知识点”对心理咨询师来说更重要。
4. 总结与行业启示 (Conclusion)
Psyche-R1 提供了一个非常有价值的范本:垂直行业的大模型不一定需要追求超大规模。
- 贡献总览:通过对推理数据的精细打磨和混合 RL 策略,7B 模型可以在受限领域内爆发出超越千亿级通用模型的能力。
- 局限性:目前模型主要基于中文语境,跨文化的心理共情(如西方语境下的沟通习惯)仍有待探索。
- 展望:未来的心理模型将不仅限于文字,结合视觉、语音的情感多模态推理(Affective Computing)将是下一个战场。
对于开发者和研究者来说,Psyche-R1 的开源数据管线(Data Pipeline)比模型本身更具启发性:如何在缺乏“Hard Label”的感性领域,通过多模型对齐和迭代优化,构造出高质量的推理样本。