
[PubSwap] 突破联邦学习瓶颈:公共数据引导下的去中心化大模型推理强化
PubSwap: Public-Data Off-Policy Coordination for Federated RLVR
本文提出了 PubSwap,一个专为联邦强化学习(Federated RLVR)设计的推理模型后训练框架。该方法结合了 LoRA 轻量化微调与基于公共数据的离策略(Off-policy)协调机制,在数学与医学推理任务中实现了显著的性能提升。
TL;DR
在 AI 迈向强推理时代的今天,如何利用分散在各机构(如医院、银行)的私有数据进行强化学习(RLVR)是一大难题。卡内基梅隆大学(CMU)团队提出的 PubSwap 框架,通过 LoRA 降低通信负载,并巧妙利用 少量公共数据 作为“路标”,在不泄露隐私的前提下,解决了联邦学习中的模型漂移难题。在数学和医学推理任务中,其表现显著优于传统的 FedAvg 和 FedProx 算法。
背景定位:当联邦学习撞上 RLVR
在大模型的后训练(Post-training)阶段,基于可验证奖励的强化学习(RLVR,如 DeepSeek 采用的 GRPO)是提升逻辑推理能力的关键。然而,现实中大量高质量数据是碎片化分布的。直接整合数据面临隐私红线,而传统的联邦学习(Federated Learning)在处理推理任务时,往往因模型太大搬不动(通信瓶颈)、数据太杂合不来(模型漂移)而告产。
核心痛点:漂移与成本的博弈
- 通信泥潭:Full Fine-tuning 的联邦学习需要频繁同步参数,这对于几十亿参数的模型来说是灾难。
- 客户端漂移 (Client Drift):为了省通信费,我们通常让客户端多跑几步再同步(大 值)。但因为每个客户端的数据分布不一样,跑得越久,模型长得就越“跑偏”,最终导致中心模型聚合失败。
PubSwap 的解法:LoRA + 公共数据“影子交换”
1. 通信减负:全 LoRA 架构
PubSwap 仅对 LoRA 层的 A 和 B 矩阵进行聚合(FedIT 策略),将每轮通信的数据量从 降低到 。实验证明,对于推理任务,低秩更新(LoRA)所携带的奖励信号已经足够。
2. 核心机制:Balanced 公共数据对齐
这是本文最精彩的 Insight。作者引入了一个微小的、不含敏感信息的 公共数据集 ()。
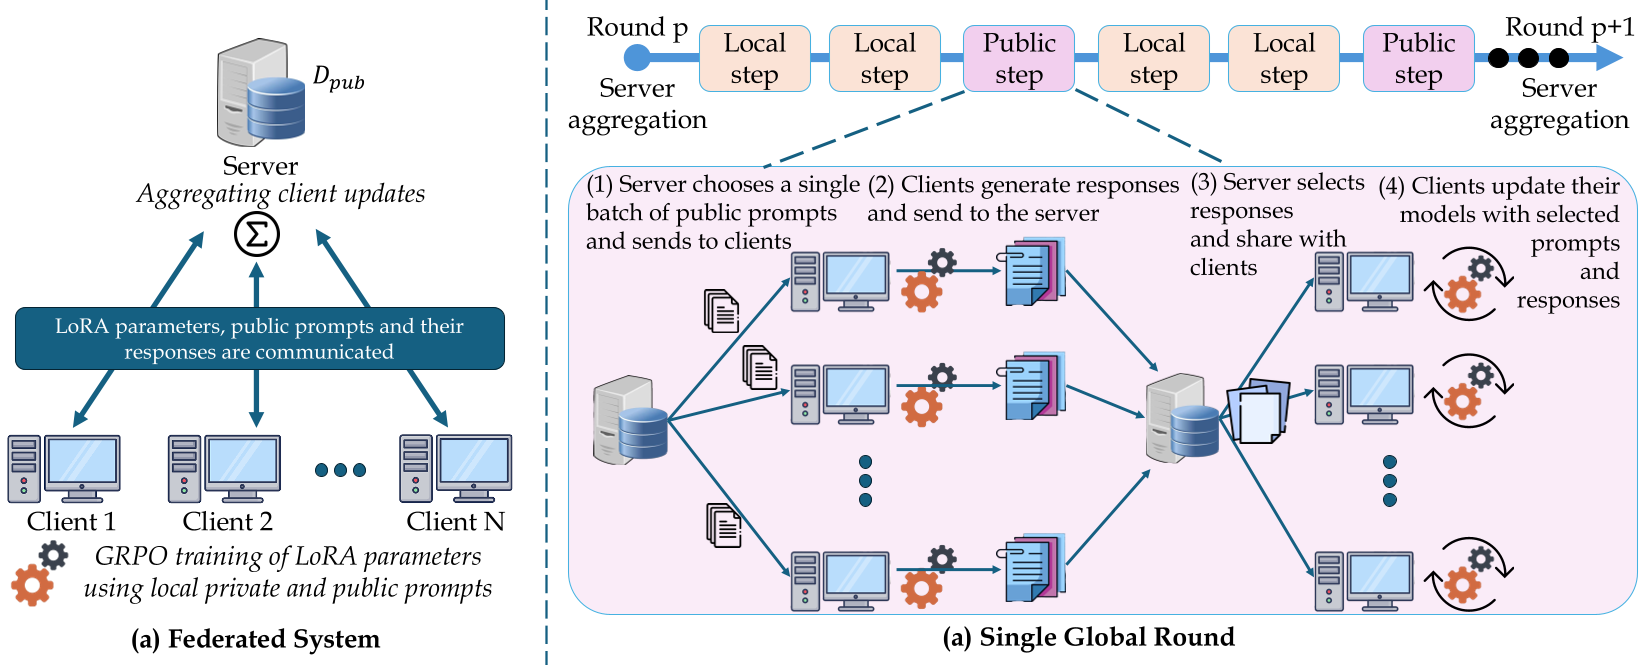 图 1:PubSwap 流程示意。私有步训练本地数据,公共步利用共享 Prompt 进行响应交换。
在训练过程中,系统会插入“公共数据步”:
- 生成响应:所有客户端针对同一组公共 Prompt 生成 个回答,并把答案(仅答案,不含私有数据)传给服务器。
- Balanced 策略替换:如果某个客户端对某个题目的回答大多是错的(正确数 ),服务器会从别的客户端拉来正确的答案,替换掉本地的错误答案。
- 纠偏:通过这种方式,客户端在本地训练时,强制接触到“全局视野”下的正确答案。这不仅增加了奖励方差(有利于 RL 收敛),还像一根无形的绳子,把偏离的客户端拉回到全球化轨迹上。
实验战绩:高效率下的高质量
PubSwap 在 Qwen2.5 和 Qwen3 模型系列上展现了强大的韧性。特别是在 (即每 120 步才同步一次,极高通信效率)的场景下,性能提升最为显著。
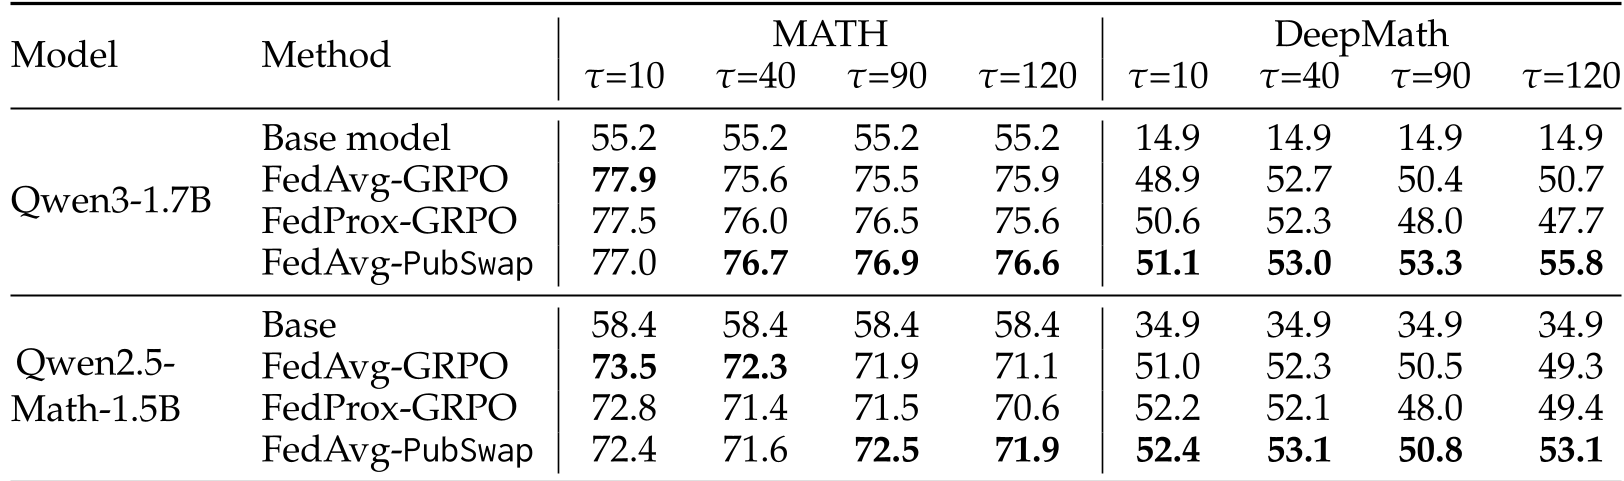 表 1:在数学推理任务中,PubSwap 在各种局部步数配置下均优于 FedAvg 和 FedProx。
关键洞察:
- FedProx 的失效:在 RLVR 场景下,传统的参数空间正则化(FedProx)效果不佳。作者认为,参数空间的微小差异在自回归解码中会被无限放大,因此“响应空间”的直接干预(PubSwap)更有意义。
- 数据异构性:在极高异构度(Dirichlet )下,PubSwap 的优势更加扩大,证明了公共数据锚点的必要性。
深度思考与总结
PubSwap 的成功给了我们一个重要启示:在联邦强化学习中,对齐“行为(Response)”比对齐“权重(Weights)”更有效。
局限性与未来
虽然 PubSwap 表现优异,但其严重依赖公共数据的相关性。如果公共数据分布与私有数据完全脱节,纠偏效果可能会打折扣。未来的方向可能包括:
- 自动化筛选对纠偏贡献最大的公共 Prompt。
- 结合更高级的离策略修正算法(如重要性采样裁剪)提升稳定性。
总之,PubSwap 为医疗、金融等数据孤岛场景下的 LLM 推理能力协作提供了一个极其务实且高效的路径。