
Q-RAG:在隐空间重塑长文本多步检索的性能巅峰
Q-RAG: Long Context Multi-step Retrieval via Value-based Embedder Training
本文提出了 Q-RAG,一种通过强化学习(RL)在嵌入模型(Embedder)隐空间内进行多步检索的方法。该方法在 BabiLong 和 RULER 等长文本基准测试中,实现了高达 10M token 背景下的 SOTA 性能,同时显著降低了训练和推理成本。
TL;DR
传统的检索增强生成(RAG)在面对“大海捞针”或“连环解析”等复杂逻辑时常显乏力。Q-RAG 另辟蹊径,不再折腾昂贵的 LLM 训练,而是通过强化学习(RL)在 Embedder 的隐空间内教智能体如何“按图索骥”。它不仅在 1000 万 token 的尺度上刷出了 SOTA,而且训练成本极低,是长文本处理领域的里程碑式工作。
痛点深挖:为何长文本多步检索这么难?
现有方法主要面临三大瓶颈:
- LLM 的认知负担:多步 RAG(如搜索生成的 Inner Monologue)通常需要频繁调用 LLM 产生查询语句,推理成本极高。
- 时序逻辑缺失:标准向量相似度检索忽略了事实在文档中出现的先后顺序,导致无法处理“发生在前一个事件之前的动作是什么?”这类时序推理任务。
- 性能衰减:大多数模型在上下文超过 128k 后,由于注意力稀释(Attention Dilution),准确率会呈断崖式下跌。
核心机制:Q-Learning 进入 Embedder 隐空间
Q-RAG 的核心构思是将多步检索建模为一个有限时界的马尔可夫决策过程 (MDP)。
1. 价值函数驱动的检索
不同于传统的 Cosine Similarity,Q-RAG 使用两个 Embedder:
- 状态编码器 (State Embedder):编码当前的查询词和已经检索到的信息。
- 动作编码器 (Action Embedder):编码待选的文本块。 通过计算两者的内积来估计 Q 值(即选择该文本块对最终回答问题的潜在价值)。
2. 相对位置编码 (Temporal Reasoning)
为了解决时序推理问题,作者设计了一种动态映射机制。它根据已提取事实的位置,将文档划分为不同的区间。
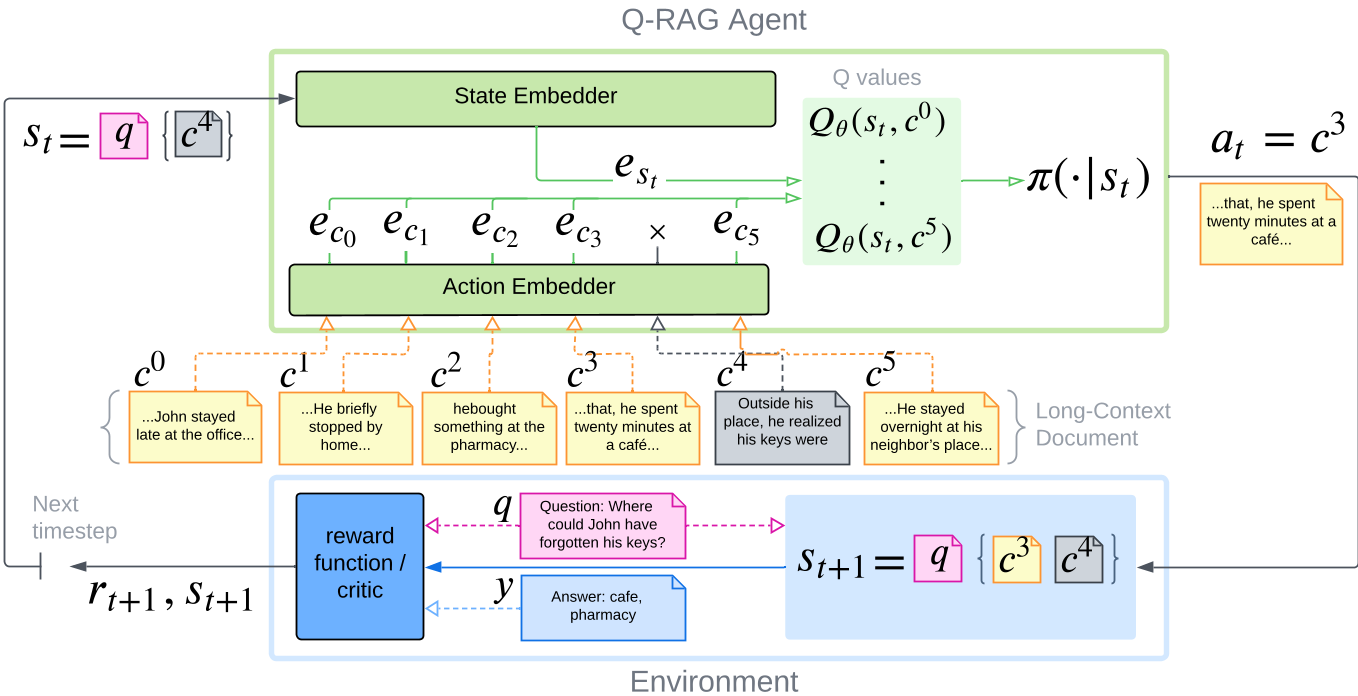 如图 1 所示,Q-RAG 智能体通过不断更新状态向量并对比剩余候选块的 Q 值,实现了在 latent space 的最优路径搜索。
实验战绩:10M 长度下的绝对统治力
在 BabiLong 榜单上,Q-RAG 展示了极强的扩展性。
- 超大规模:在上下文从 100w 增加到 1000w token 时,Q-RAG 的性能表现非常稳健。
- 深度推理:在最难的 QA3(需要 3 步推理)任务中,它彻底拉开了与 Titans, ARMT 等循环神经网络(RNN-based Transformer)架构的差距。
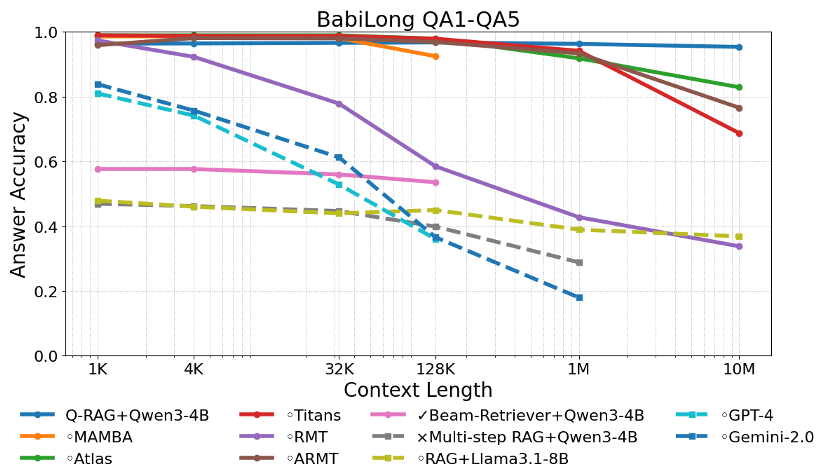 图 2 展示了在不同上下文长度下,Q-RAG 几乎平滑的性能曲线,这在长文本领域极为罕见。
深度分析:为什么它既快又强?
- PQN 算法的红利:采用了最新的 PQN(Persistent Q-Network)算法,由于省去了庞大的 Replay Buffer,内存占用大幅下降,使得在单卡 A100 上训练 10M 的任务成为可能。
- 数学直觉:作者在附录证明了内积近似价值函数在理论上的通用近似能力(Universal Approximation),保证了 Embedder 层确实有潜力接管复杂的逻辑决策。
总结与局限
Q-RAG 证明了:要解决长文本难题,不一定要无限增加 LLM 的上下文窗口,通过更智能、具备逻辑感知能力的 Embedder 进行精准的“多步截取”可能是更经济的方案。
不足之处:目前奖励信号仍需依赖 Ground Truth 支撑事实。未来的方向将探索如何利用 LLM 产生的质量反馈作为 RL 的 Reward,从而实现全自动的检索策略进化。