
QMAVIS:打破时长焦虑,用“分段融合”重塑长视频音视频深度理解
QMAVIS: Long Video-Audio Understanding using Fusion of Large Multimodal Models
本文推出了 QMAVIS,一种专门针对长视频(4分钟至1小时以上)音视频理解的高级融合框架。该系统通过将长视频切片并并行处理,采用一种 late fusion(后融合)策略整合 Video LMM、音频转录模型与大语言模型(LLM),在 VideoMME 长视频基准测试中比 SOTA 模型提升了 38.75%。
TL;DR
处理超过一小时的视频,对当前的 AI 模型来说不仅是内存的考验,更是逻辑推理的噩梦。QMAVIS(Q Team-Multimodal Audio Video Intelligent Sensemaking)通过一种聪明的“后融合”架构,将超长视频化整为零。它不再尝试一次性吞下整部影片,而是通过切片处理、视觉/音频分头提取、LLM 全局聚合的三步走策略,在 VideoMME 榜单上实现了近 40% 的惊人飞跃。
1. 痛点:为什么 LLM 面对长视频会“失忆”?
在多模态领域,10秒被称为“短片”,2分钟已是“长片”。现有的 Video-audio 模型(如 InternVideo2, VideoLLaMA)面临两大算力与架构高墙:
- 下采样之痛:为了塞进有限的 Context Window,模型不得不把 1 小时的视频抽稀成几十帧,导致关键情节丢失。
- 模态对齐之难:视觉与音频在长跨度下的时空一致性极难通过单一的端到端网络训练出来。
QMAVIS 的核心直觉在于:既然当前的 Video LMM 在处理 30 秒短片时已经非常出色,那么我们只需要一个强大的“大脑”(LLM)来协调各个碎片的记忆。
2. 核心架构:QMAVIS 的三位一体
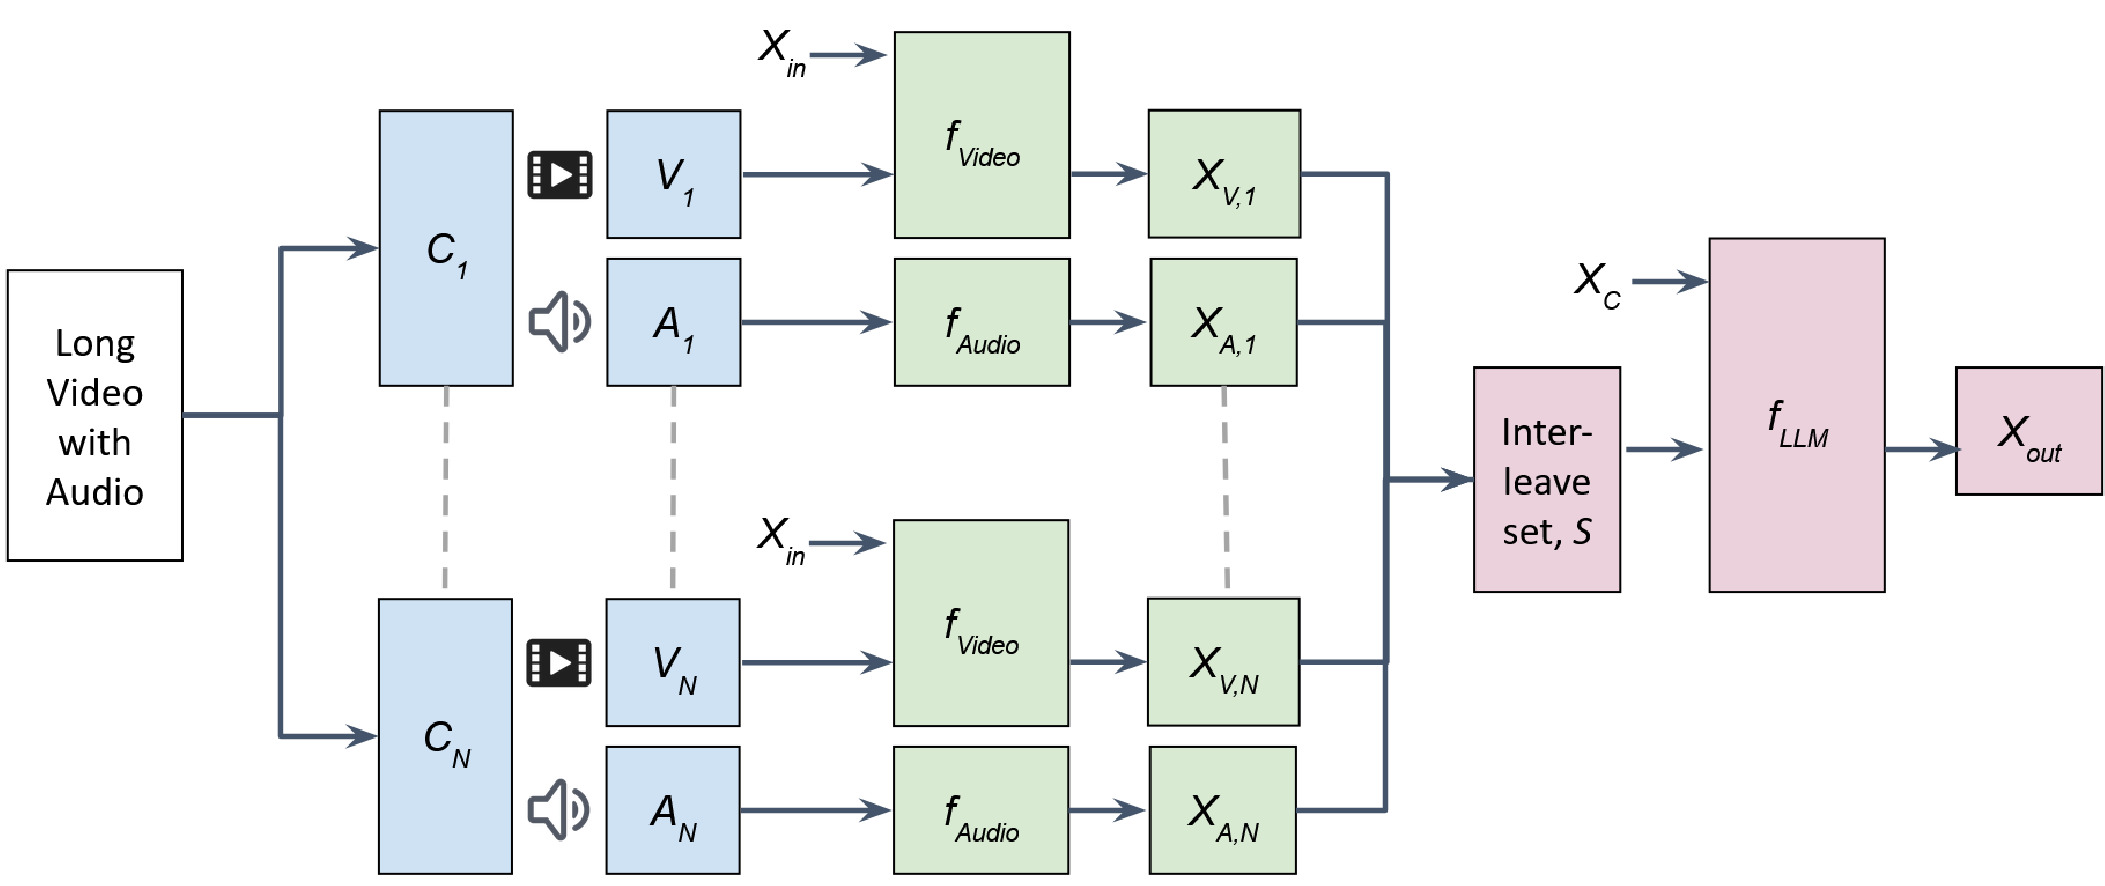
QMAVIS 的设计理念是模块化后融合,其流程高度模拟人类观看长片的方式:
第一步:分片(Video Chunking)
系统将视频切分为 个约 30 秒的短块 ()。这确保了在这个粒度下,模型可以保持 1 FPS 及以上的采样率,不放过任何细节。
第二步:感官提取
- 视觉感官:调用 Qwen2-VL-72B 对每个片段生成详细的视觉描述。
- 听觉感官:使用 Whisper Large v3 将语音转录为文本(ASR)。 此时,原本沉重的原始视频流被转化为了轻量化的文本“原始记忆”。
第三步:大脑聚合(Interleaving & Aggregation)
这是 QMAVIS 的神来之笔:它将视觉描述 和音频转录 进行时序交织,送入 LLM 进行总结或多轮问答。如果总文本量太大,则采用递归聚合的方式进行缩减。
3. 实验结果:长距离任务的降维打击
实验数据显示,QMAVIS 在长文本/视频关联度极高的 VideoMME 数据集上展现了统治力:
| 模型 | VideoMME (w/ subs) | 提升幅度 |
|---|---|---|
| VideoLLaMA2 | 47.9 | 基准 |
| InternVideo2 | 41.9 | - |
| QMAVIS (Full) | 66.46 | +38.75% |
消融分析:音频到底有多重要?
在消融实验(Ablation Study 2)中,移除 Whisper 转录模块后,VideoMME 的分数从 66.46 骤降至 48.18。这有力地证明了:对于现代长视频理解,语音信息所提供的语义价值往往不亚于视觉画面。
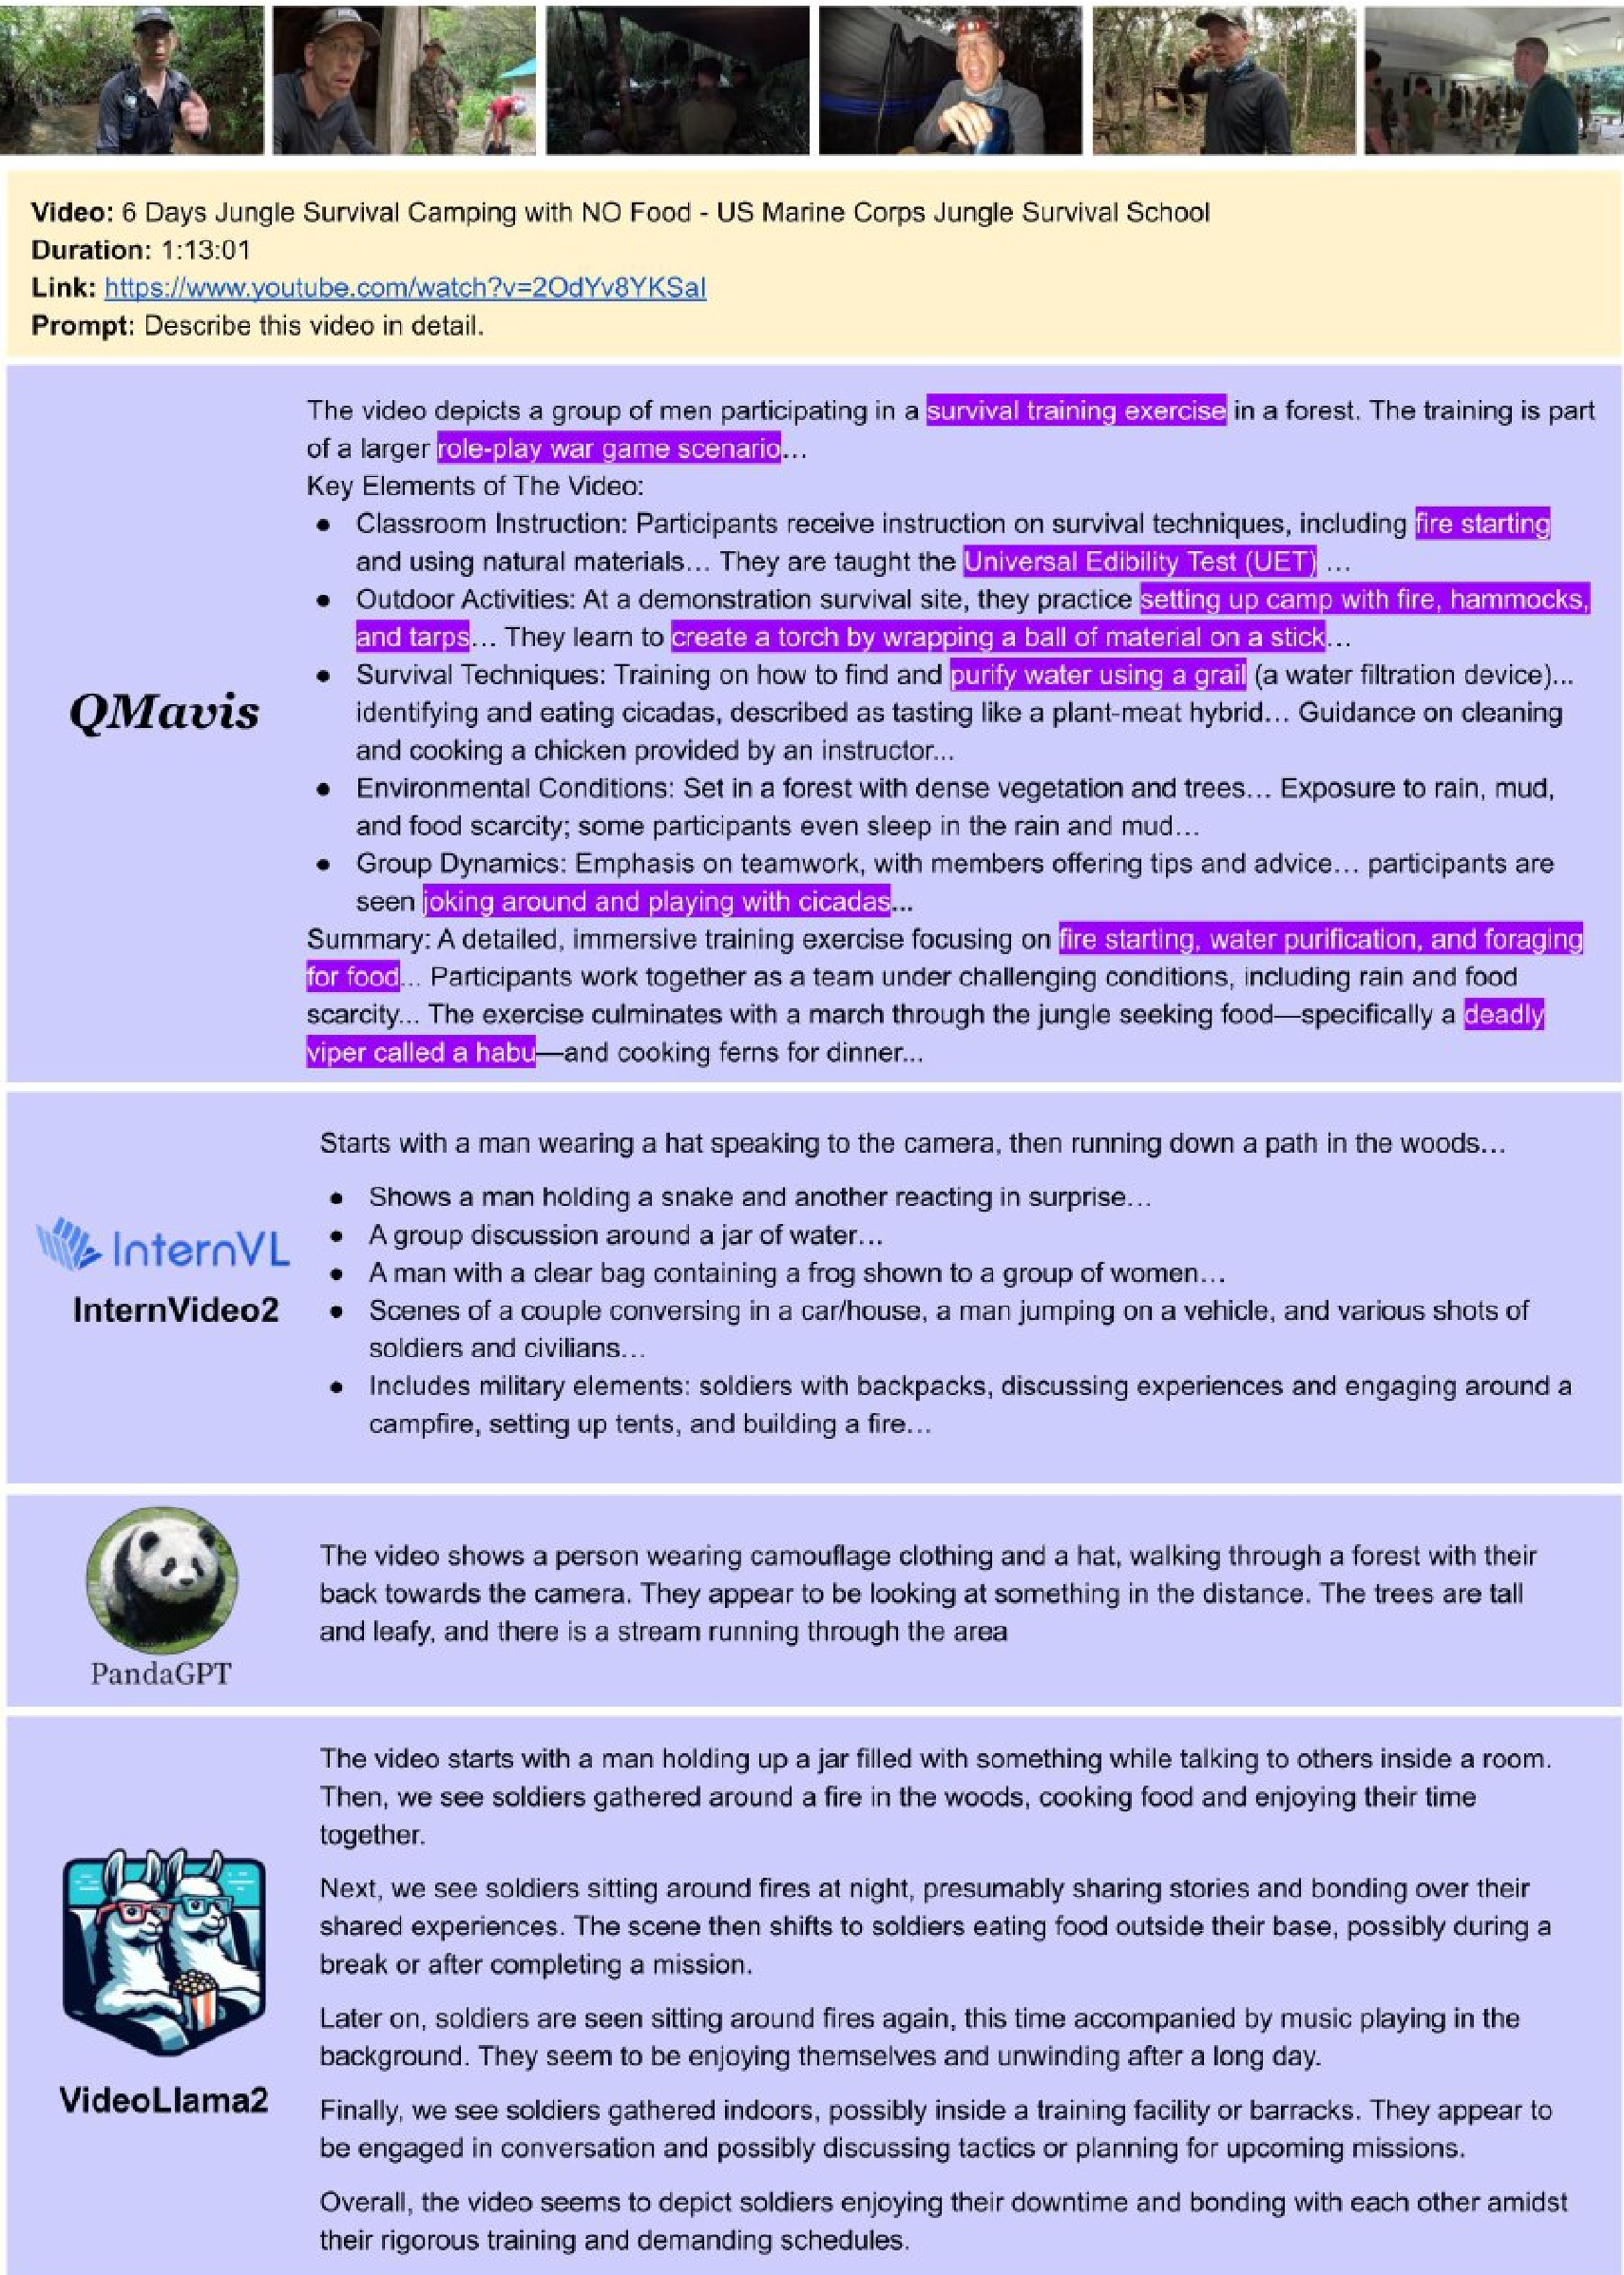 上图展示了 QMAVIS 与其他模型在 1 小时视频下的表现。传统模型往往只能捕捉到碎片化的角色穿着,而 QMAVIS 能理清“开端-发展-高潮”的叙事脉络。
4. 资深主编点评
QMAVIS 虽然在模型原生创新上(Architecture-wise)并不算开天辟地,但它在系统工程层面提供了一个极佳的示范。
- 实战性极强:该方案支持私有化部署,不依赖闭源 API,非常适合公共安全、智慧城市等隐私敏感场景。
- 解耦优势:Video LMM、ASR、LLM 这三个模块均可独立平替。当未来出现更强的 Qwen3 或 Whisper v4 时,QMAVIS 的性能可以几乎零成本无缝升级。
- 局限性:目前主要依赖文本转录,对于背景音乐情感、环境声(如脚步声、枪声)的非语言理解仍有欠缺。作者也提到,未来的方向将是整合更全面的 Audio Model。
总结
QMAVIS 雄辩地证明了:在面对大尺度多模态难题时,“工程架构的巧妙组合”往往比“追求单一算力奇迹”更有效。它为解决现实世界中复杂的、非结构化的长视频分析任务提供了一条极其清晰的技术路径。