
Qwen-VLA:打破孤岛,构建任务与平台大统一的具身底座
Qwen-VLA: Unifying Vision-Language-Action Modeling across Tasks, Environments, and Robot Embodiments
本文推出了 Qwen-VLA,一个统一的具身智能(Embodied AI)大模型。该模型基于 Qwen3.5-4B 骨干网络,通过集成的 DiT (Diffusion Transformer) 动作解码器,实现了在操控(Manipulation)、导航(Navigation)和人体自我中心轨迹预测等异构任务上的端到端建模,并在 LIBERO 和多项真实机器人实验中达到了 SOTA 水平。
TL;DR
阿里 Qwen 团队发布的 Qwen-VLA 标志着具备“通才”潜力的具身底座模型正式步入 2.0 时代。它不再是一个只能“开罐子”或只能“带路”的专项专家,而是在一个统一的 Qwen3.5 + DiT 架构下,通过 10,000+ 小时的异构数据训练,同时掌握了单臂/双臂操纵、室内导航、自动驾驶 VQA 甚至动态抓取能力。其核心突破点在于将异构任务表述为统一条迹映射,并结合具身提示词实现了“千机一模”。
1. 痛点:被割裂的“肢体”与“大脑”
在具身智能领域,长期存在两个痛点:
- 平台异构性:一个为左手设计的模型没法直接给右手用,更别提给轮式机器人做导航。
- 任务孤岛:操控(Manipulation)关注精细动作,导航(Navigation)关注路径点。过往研究往往各玩各的,导致跨领域知识无法迁移。
Qwen-VLA 的直觉是:无论任务多千奇百怪,本质上都是在给定视觉+指令下预测一段时空条迹(Trajectory)。如果能把这些条迹规格化,那么视觉语言模型中强大的推理能力就能直接迁移到运动控制上。
2. 核心架构:认知与运动的耦合
Qwen-VLA 采用了解耦但协同的架构设计:
- 大脑(Qwen3.5-4B):负责理解视觉场景、语义指令和空间关系。它采用 native multimodal 设计,将视觉 Token 交织入文本流。
- 小脑(DiT-based Action Expert):一个约 1.15B 参数的 DiT 解码器,利用 Flow-matching 目标来生成连续、高维的动作脉冲。
 Figure 1: Qwen-VLA 整体流程,展示了从多模态输入到 DiT 动作生成的链路。
创新的 Embodiment-aware Prompting
为了让一个模型控制所有机器人,作者引入了“身份说明”:
"The robot is {robot_tag} with {single arm / dual arms}... Please predict..." 通过这种 Prompt,模型能够实时调整其内禀的控制逻辑,以适配不同的自由度(DoF)和控制频率。
3. 训练秘籍:分阶段压缩与对齐
直接训练 VLM + 动作头是不稳定的。作者提出了一种基于压缩视角的四阶段方案:
- Stage I: Text-to-Action (T2A):冻结 VLM,只让 DiT 根据文本生成动作。这强制模型建立一种“不看图也能懂动作基本逻辑”的先验。
- Stage II: Continued Pretraining (CPT):全量训练,将动作先验与视觉观察(仿真+真实数据)对齐。
- Stage III: SFT:针对特定任务(如 ALOHA 或 2D Grounding)进行指令微调。
- Stage IV: RL:利用
RLinf框架,在闭环仿真环境下根据成功奖励进行优化,解决强化学习中的分布偏移问题。
4. 实验战绩:全能选手的压制力
Qwen-VLA 在模拟器和现实世界中均表现出了惊人的 SOTA 能力。
仿真对比
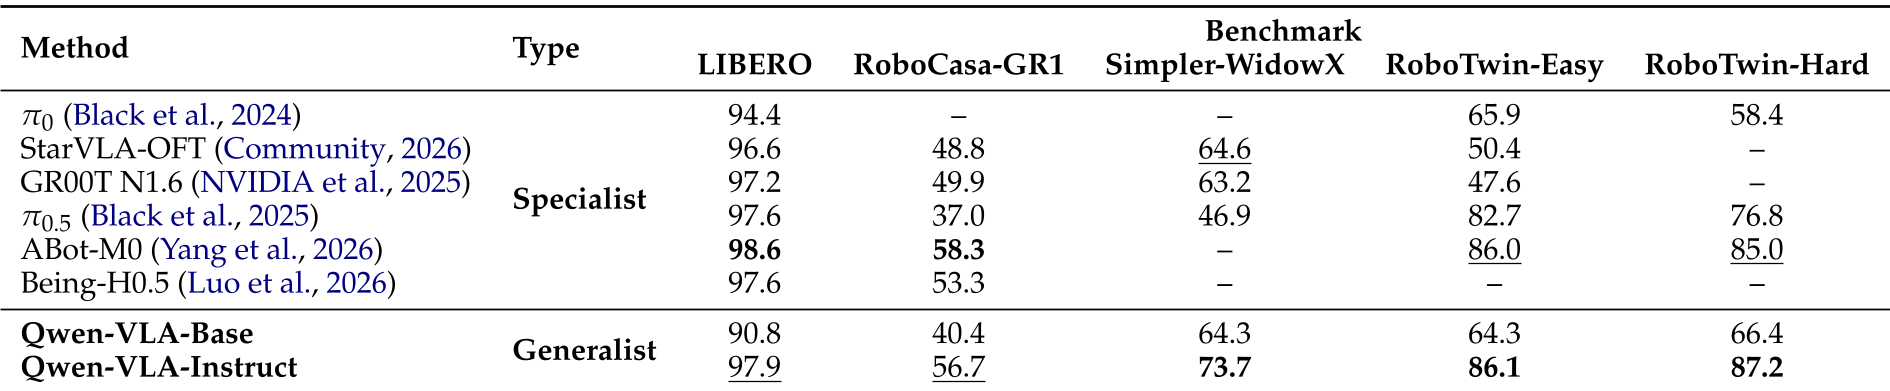
在针对双臂协同的 RoboTwin 挑战中,Qwen-VLA 的表现不仅超过了专为该任务设计的 Specialist 模型,甚至在 Hard 模式下领先上一代基线近 2.2%。
现实世界与分布外(OOD)泛化
最引人注目的是其 DOMINO 动态操纵 表现。即使没见过移动的目标,Qwen-VLA 依然能通过预测相干的动作 Chunk,在物体快速移动时精准实施抓取。
| 任务场景 | 性能指标 (Qwen-VLA-Instruct) | 相比基线提升 |
|---|---|---|
| LIBERO 平均成功率 | 97.9% | 对标最优 Specialist |
| Real ALOHA (OOD) | 76.9% Success | +35% vs π0.5 |
| DOMINO (Zero-shot) | 26.6% SR | 大幅超越 OpenVLA-OFT |
5. 深度洞察:为什么有效?
- 数据的异构联合:引入自动驾驶 VQA 和人类视频(Egocentric Data)极大地丰富了模型的物理常识,使其能够理解“靠近”、“走开”等抽象动词。
- DiT 的威力:相比于传统分类式的动作编码,Flow-matching 支持更高频率和更连续的动作生成,这对精细操作(如插卡、叠碗)至关重要。
- 对齐策略:T2A 阶段先学动作统计分布,再通过 CPT 对齐视觉,有效避免了灾难性遗忘。
6. 局限与展望
尽管 Qwen-VLA 很强大,但它依然面临着诸如“接触密集型任务”和“长程任务规划”的稳定性挑战。未来的方向将集中在引入强化物理反馈(触觉、力觉)以及接入更强大的世界模型(World Models)来预测动作后果。
总结: Qwen-VLA 证明了具身智能不需要为每个机器人重新造轮子。通过统一的架构和语料策略,我们正在接近通用机器人时代的“GPT 时刻”。