
R2Former:用纯 Transformer 统一视觉地点识别的检索与重排
$R^{2}$ Former: Unified Retrieval and Reranking Transformer for Place Recognition
本文提出了 R2Former,一个基于纯 Transformer 的视觉地点识别(VPR)统一框架。该方法通过一个新颖的重排模块,整合了全局检索与局部重排,在 MSLS 等主流数据集上刷新了 SOTA 性能。
核心速览
TL;DR:R2Former 是一个高效的视觉地点识别(Visual Place Recognition, VPR)框架,它摒弃了繁琐的 RANSAC 几何验证,通过一个统一的 Transformer 架构同时完成全局特征检索与候选图像重排。在保持甚至超越 SOTA 精度的同时,其推理延迟降低了 80% 以上,内存占用极低,极具工业落地价值。
背景定位:该工作属于 VPR 领域的“统一架构模型”。它不仅解决了传统方法检索与重排割裂的问题,还挑战了“CNN 局部特征在 VPR 重排中不可替代”的固有认知,确立了 ViT 在该领域的卓越地位。
痛点深挖
视觉地点识别通常分为“全局检索”和“局部重排”两个阶段:
- 全局检索:通过聚合特征(如 NetVLAD)快速从数据库中拉取 Top-K 候选。
- 局部重排:利用 RANSAC 等方法进行几何一致性检查。
为什么传统方法行不通了?
- 信息单一化:RANSAC 只看几何对齐,不看特征之间的相关性强度,这在环境剧烈变化(如昼夜对比)时显得力不从心。
- 效率瓶颈:RANSAC 是 CPU 密集型任务,难以并行化,在大规模实时检索中往往成为“性能杀手”。
- 内存冗余:像 Patch-NetVLAD 这类方法产生的局部描述符动辄几百 GB,令普通服务器望而生畏。
架构解析:从相关性矩阵到 Transformer
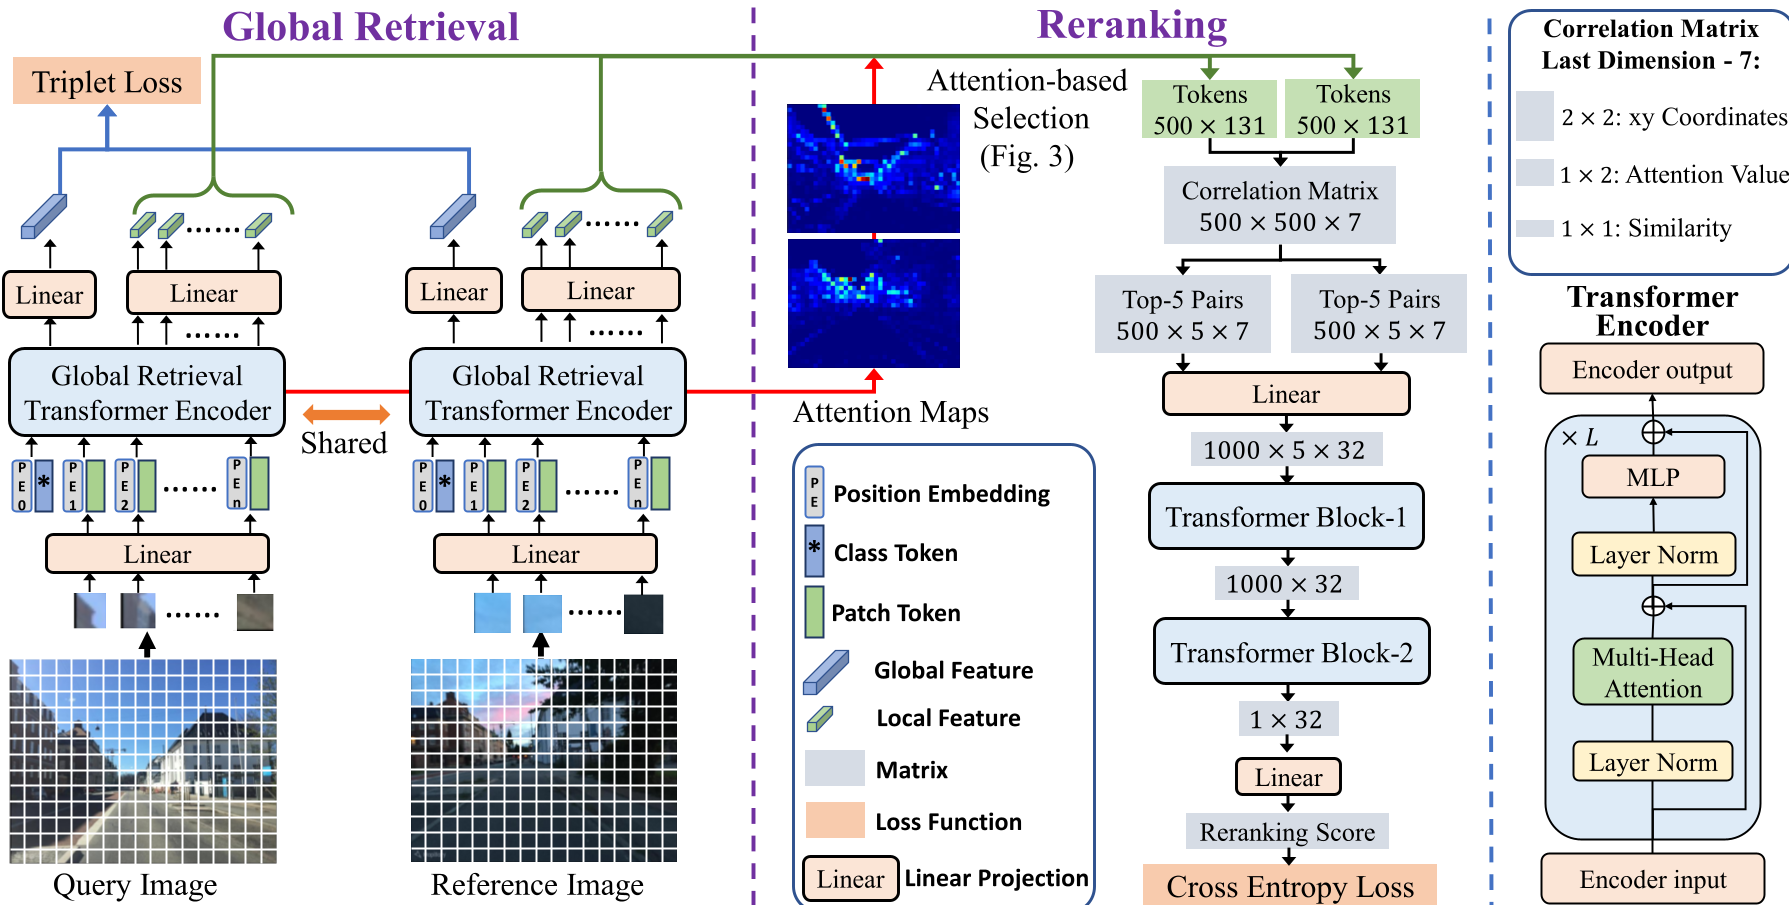
R2Former 的核心逻辑在于:利用 Transformer 强大的序列建模能力,把重排变成一个“二分类”学习任务。
1. 统一提取:CLS 与 Patch Tokens
模型使用 ViT 作为 Backbone。其中 CLS token 经线性层降维后直接作为全局检索向量(256维);而各层的 Patch tokens 则作为局部特征(500个,128维)。这一过程不再需要额外的聚合层,如 NetVLAD 或 GeM。
2. 局部特征选择:注意力即价值
与其处理所有 patch,R2Former 利用 CLS token 在最后一层的注意力图(Attention Map),筛选出注意力值最高的前 500 个 token。这些 token 通常覆盖了建筑物等关键地标,滤除了云朵、行人等干扰。
3. 重排模块:七维信息流 (x, y, A)
这是本文的精华所在。重排模块不仅输入特征的余弦相似度(S),还加入了 (x, y) 坐标信息和注意力权重(A)。
- Transformer Block-1:处理最相似的 Top-5 匹配对,提取候选关键特征。
- Transformer Block-2:聚合所有候选信息,最终通过一个 Linear Head 输出匹配分值。
实验与结果:速度与精度的双重碾压
关键战绩
在 MSLS 挑战赛集上,R2Former 在 Recall@1 这一硬指标上达到了 73.0%,远超 TransVPR(63.9%)和 Patch-NetVLAD(48.1%)。
效率革命
最令人印象深刻的是下表的性能对比:
- 重排延迟:从 Patch-NetVLAD 的 8377ms 锐减至 202ms(单卡),多卡并行下甚至可达 47ms。
- 内存空间:100万张图像的存储仅需 244GB,相比同类重排方法降低了 4 到 190 倍。

深度洞察与总结
为什么它能打破 RANSAC 的神话? 可视化结果显示,虽然 R2Former 的重排模块没有显式的几何约束方程,但 Transformer 动态地学习到了某些“隐性几何”。更重要的是,它能分辨出哪些局部的相似是“更有说服力的”(Task-relevant information),而不仅仅是寻找几何重合。
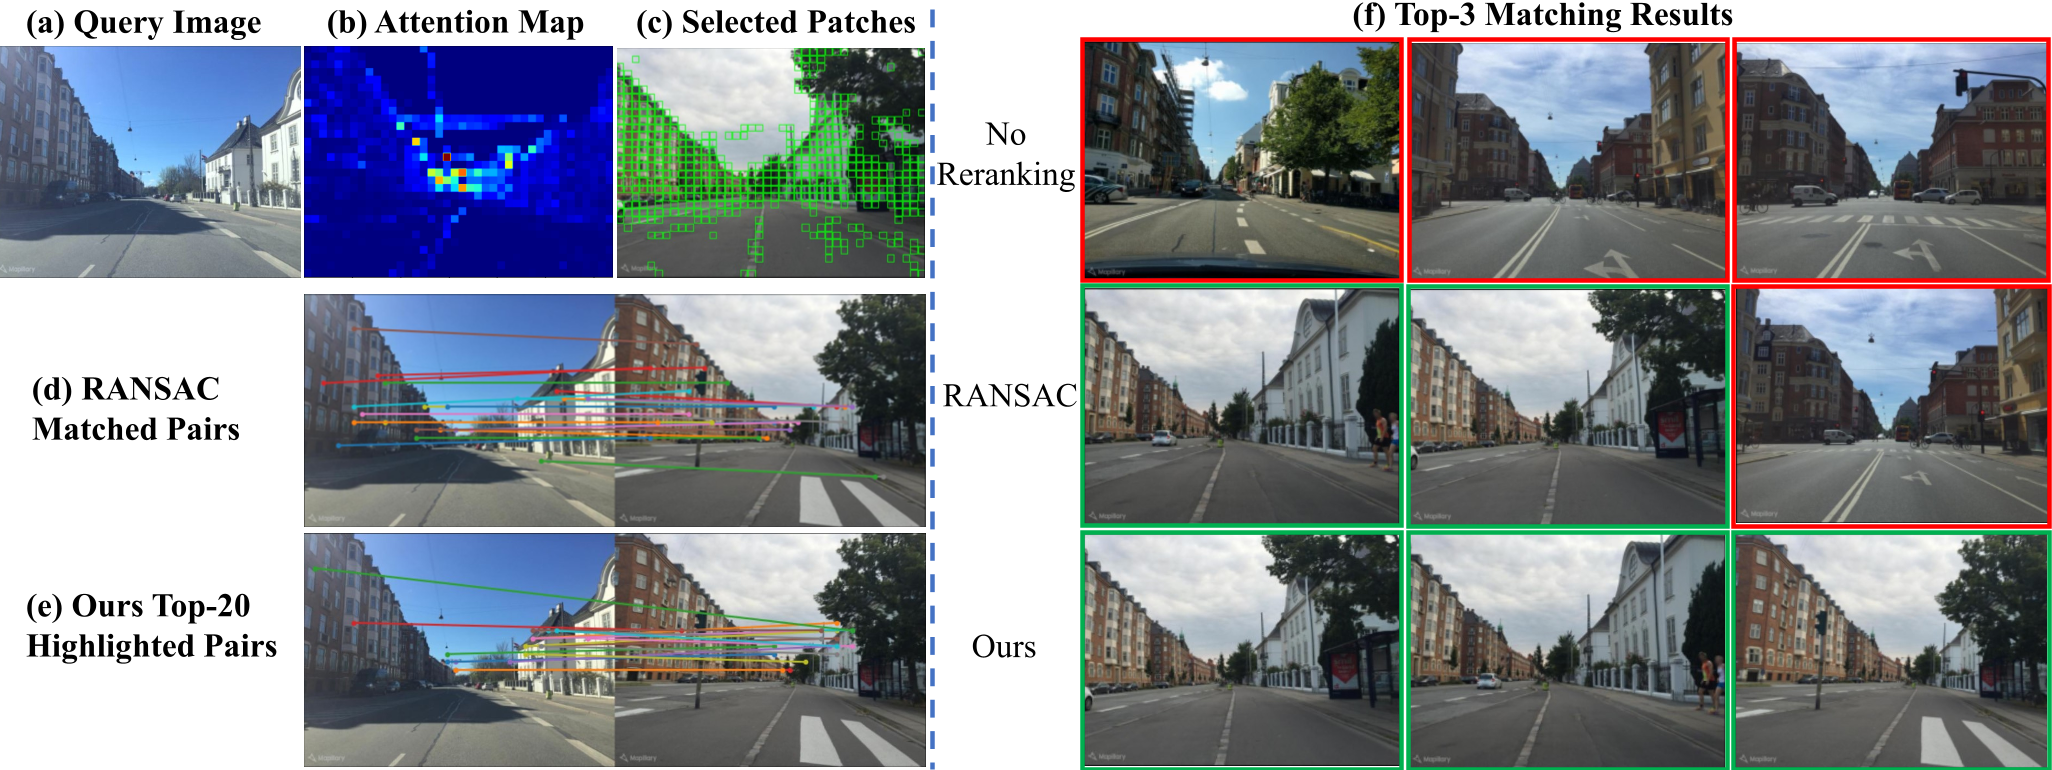
局限性与展望: 由于采用了固定数量的 Token 选择,R2Former 在面对极端缩放变化的场景时,可能会丢失部分细微匹配点。未来的研究方向可以考虑在相关性矩阵中引入跨尺度的几何一致性建模。
Takeaway:R2Former 的出现标志着 VPR 步入了“全端到端模型”时代,其对于相关性矩阵的处理方案,也为其他领域的重排问题(如跨相机跟踪、重识别)提供了极佳的范式。