
揭秘电信级 RAG 评估:RAGAS 指标在专业领域真的靠谱吗?
Evaluation of rag metrics for question answering in the telecom domain
本文针对电信领域(Telecom Domain)的问答任务,对流行的 RAGAS 评估框架进行了深度评测。作者通过修改 RAGAS 源码提取中间推理过程,重点分析了六项关键指标在特定技术领域下的可靠性,并探讨了领域适配(Domain Adaptation)对评估结果的影响。
TL;DR
随着 RAG(检索增强生成)技术在垂直行业的落地,如何准确评估其表现成了头等大事。本文深入电信领域,对主流评估框架 RAGAS 进行了“拆解式”研究。结论显示:并非所有 RAGAS 指标都经得起推敲,Factual Correctness(事实正确性) 和 Faithfulness(忠实度) 是电信领域的黄金准则,而依赖余弦相似度的指标则存在较大偏差。
背景定位
在通用问答任务中,RAG 表现优异,但在 3GPP 标准文档这种“硬核”电信数据面前,LLM 可能会产生误导性的幻觉。本文是针对 电信专有领域 RAG 评估 的首次系统性实验,填补了由于专业术语壁垒而导致的指标失效研究空白。
痛点深挖:黑盒评估的不可信
目前的 RAG 评估主要面临三个挑战:
- 指标黑盒化:RAGAS 只给分数,不给推导过程。
- 术语敏感性:电信术语(如 gsmSCF, Ngmlc_location)微小的差异可能导致语义天差地别。
- 相似度陷阱:传统方法过度依赖 Embedding 的余弦相似度,但在专业领域,随机句子的相似度也可能虚高,导致评价失真。
方法论详解:打开 RAGAS 的黑盒
为了验证 RAGAS 的有效性,研究团队不仅使用了原本的框架,还开发了一个增强版本,能够记录下 LLM 在判定过程中的每一条 Verdict(结论)。
实验流程架构
作者设计了一个严密的对比实验,涵盖了从检索器(Retriever)到生成器(Generator)的全链路适配。
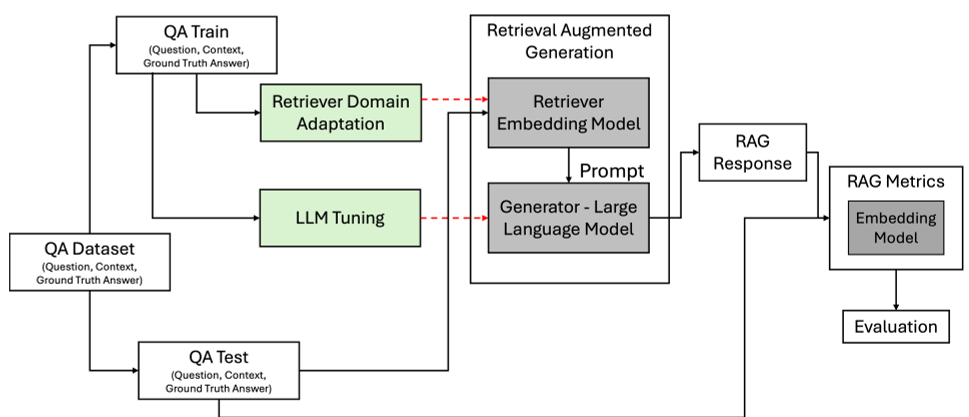 上图展示了实验装置:包括对 BGE 模型进行预训练(PT)和微调(FT),以及对 Mistral-7b 进行指令微调(IFT)。
核心指标再定义
- Faithfulness (FaiFul): 答案是否能在检索到的上下文中找到证据。
- Factual Correctness (FacCor): 基于 TP(真阳性)、FP(假阳性)及 FN(假阴性)陈述计算的 F1 分数。
实验与结果分析
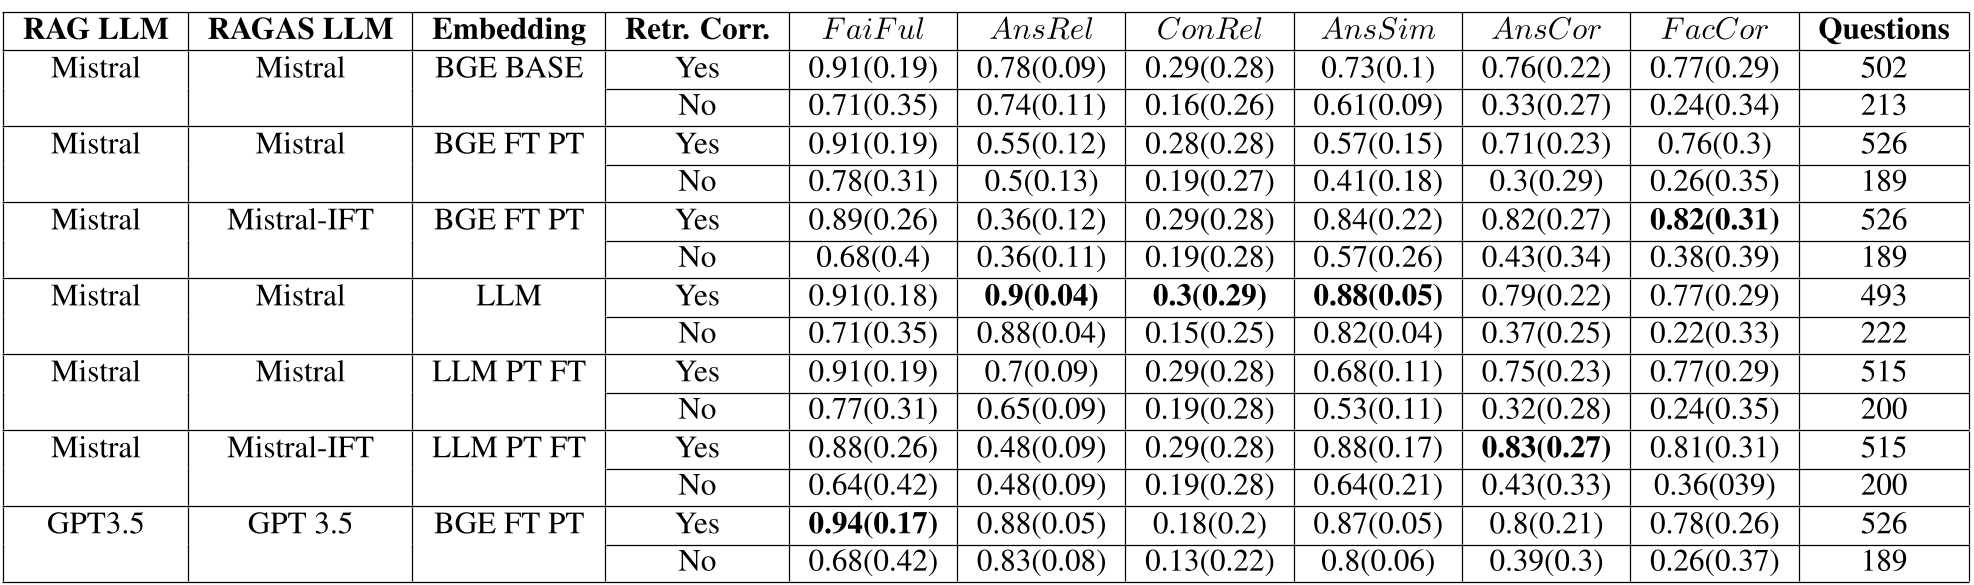
研究通过 SME(领域专家)的评估作为真值,对比了不同指标在“正确检索”与“错误检索”场景下的表现。
哪类指标最稳定?
经过与专家评议的对比,表格 2 显示了一个关键信号:当检索正确时,所有指标普遍升高;但当检索错误时,唯有 FacCor 和 FaiFul 能显著拉开差值。
领域微调的魔力
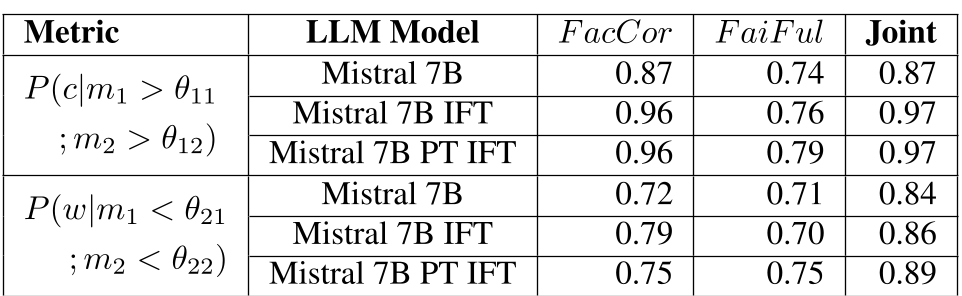
研究发现,对 LLM 进行指令微调(IFT)能显著提高其评估一致性。如下表所示,使用微调后的 Mistral 7B 作为评估器,其与专家评估的联合吻合概率高达 0.97。
深度洞察:为什么 Answer Relevance 失效了?
作者尖锐地指出,Answer Relevance (AnsRel) 和 Answer Similarity (AnsSim) 高度依赖 Embedding 空间的各向同性(Isotropy)。在电信领域,由于专业词汇分布极其稀疏且集中,余弦相似度往往无法准确反映真实的逻辑相关性。
此外,Context Relevance (ConRel) 的定义过于机械(仅为相关句子占比),没有考虑句子的质量权重,因此在长文本块(Chunks)处理中参考价值有限。
结论与展望
这项工作为垂直行业 RAG 的闭环开发提供了重要启示:
- 去伪存真:在电信等领域,应重点关注基于推理的 Faithfulness 和 Factual Correctness,弱化基于向量相似度的指标。
- 白盒化评估:开发者应像本文一样,监控 LLM 的中间判定步骤,防止评估器产生“合理的错误结论”。
- 未来方向:作者建议进一步探索 ARES 等其他依赖 RAGAS 的更高级评估框架在特定领域的鲁棒性。
Senior Editor's Note: 本文最核心的价值在于其“反直觉”的发现——即通用的相似度评估在硬科技领域往往是一场幻觉。对于正在构建垂直领域 LLM 应用的技术团队来说,这具有极高的实战指导意义。