
[CVPR 2026 预研] 从 RAG 到 Agentic RAG:打造“不说谎”的伊斯兰教 AI 助手
From RAG to Agentic RAG for Faithful Islamic Question Answering
本文推出了 ISLAMICFAITHQA 评估基准,旨在解决 LLM 在伊斯兰教知识问答中的幻觉问题。作者通过构建包含 3,810 个双语 QA 对的生成式基准,并结合 SFT Reasoner 数据集、RL 偏好数据以及一种全新的智能体化 RAG(Agentic RAG)框架,显著提升了模型在严苛宗教领域的回答准确性和可靠性。
TL;DR
在涉及宗教、法律等高严肃性领域,AI 的一个“微小幻觉”可能导致严重的社会后果。本文通过推出 ISLAMICFAITHQA 双语基准和一套 Agentic RAG(智能体化 RAG) 流程,成功将模型在复杂伊斯兰知识问答中的准确率提升了近一倍,并利用工具化检索流程极大地抑制了幻觉生成。
1. 痛点:为什么当前的 RAG 搞不定“严肃知识”?
在伊斯兰教义问答中,用户的问题往往不是简单的“事实检索”,而是涉及复杂的法理推导(Fiqh)。
现有方法的局限性:
- 由于过度对齐导致的“即便不知道也硬说”:通用 LLM 的安全对齐往往让其在面对未知信息时倾向于提供一个“圆滑但虚假”的答案。
- MCQ 评估的陷阱:多选题(MCQ)掩盖了模型的真实水平,模型可能只是通过排除法选对了,而没有真正的逻辑支持。
- 跨语言知识鸿沟:同一个模型在英语下可能表现尚可,但在阿拉伯语(教义原始语言)下却可能因为检索质量波动而出现逻辑崩塌。
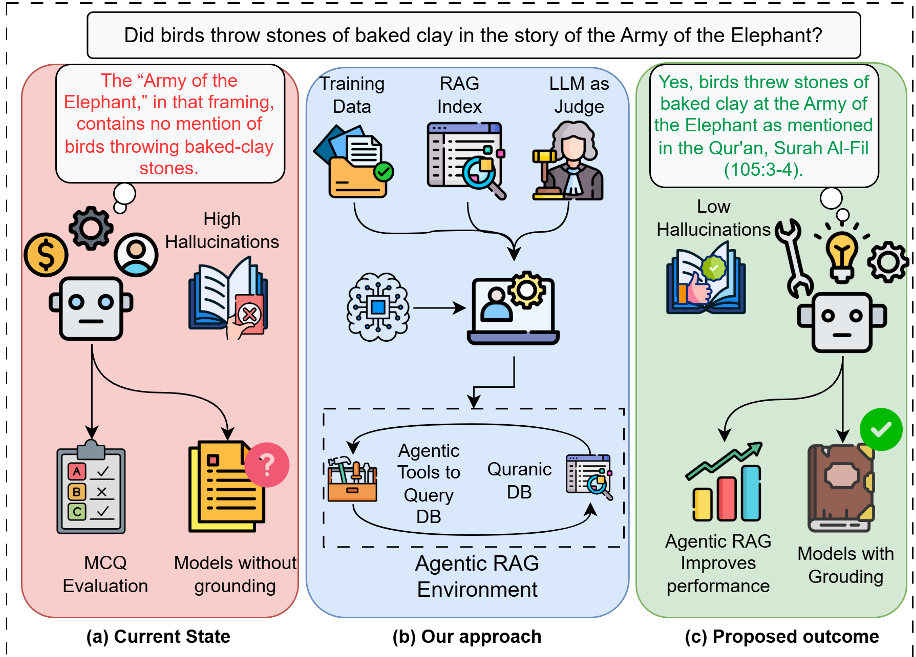 图1:传统的伊斯兰问答流程(a) vs 作者提出的基于智能体化证据搜寻的流程(b, c)
2. 核心架构:Agentic RAG 的直觉
作者认为,针对高精度知识,检索不应该是生成前的“一锤子买卖”。
所谓的 Agentic RAG,本质是将模型变成了一个带有“搜索引擎访问权限”的研究员:
- 计划(Plan):模型先思考需要哪些证据。
- 搜寻(Search):调用
search_quran或read_ayah(阅读特定诗篇)工具。 - 内省(Verify):检查检索到的证据是否能完全回答问题。如果不能,则调整关键词再次搜索。
- 最终回答:只有在证据充足时,才生成带引述(Citation)的回答;否则选择拒绝回答(Abstain)。
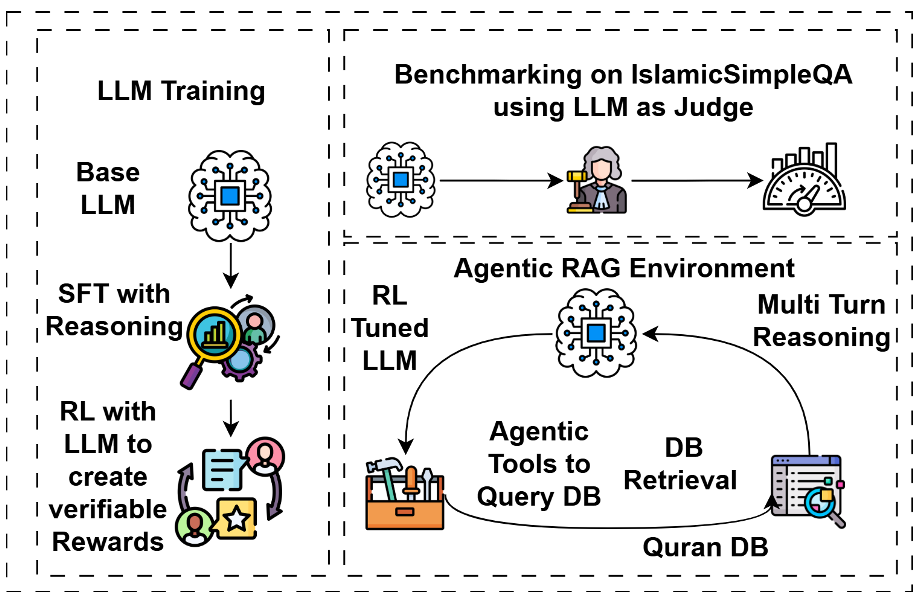 图2:模型的端到端开发与评估流,重点在于推理阶段的 Agentic RAG 环境
3. 实验战绩:小模型也能逆袭
实验结果非常令人惊喜,尤其是 Agentic RAG 的“杠杆效应”。
- 显着的性能提升:在 Qwen3-4B 模型上,仅使用普通 RAG 时准确率为 38.85%,引入 Agentic RAG 后飙升至 48.90%。这意味着多轮工具调用带来的逻辑闭环对性能贡献巨大。
- 跨语言稳定性:Agentic RAG 极大地缩小了阿、英双语之间的性能差距(见下表数据)。因为无论输入什么语言,模型都被强迫去对齐同一套底层的阿拉伯语《古兰经》原子诗篇(Ayat)。
- SOTA 表现:Fanar-2-27B 配合 Agentic RAG 达到了 57.30% 的均值,远超目前所有的开源和闭源基准模型。
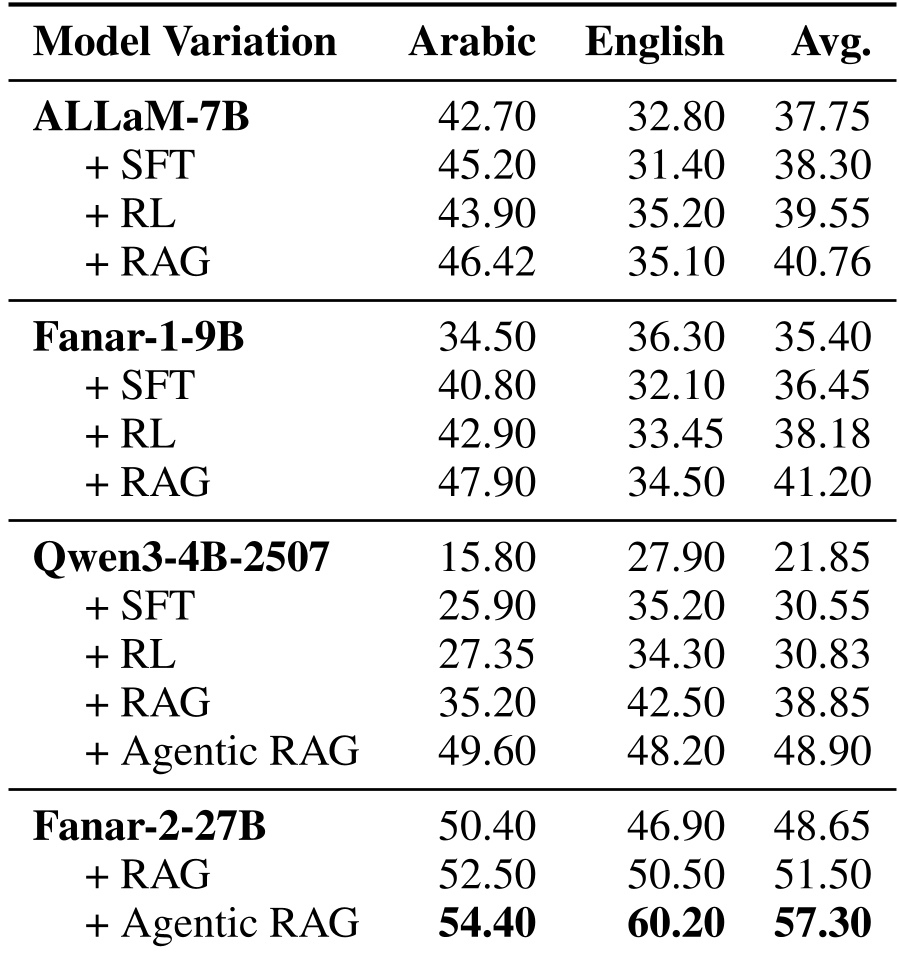 表1:不同模型变体在 ISLAMICFAITHQA 上的表现统计
4. 深度洞察:为何“慢思考”很重要?
论文中的一个核心对比(图5)非常有解释力。对于有关“晨祷(Fajr)开始时间”的复杂问题:
- 普通 RAG:检索到了关键词,但模型在整合时发生了混淆,将“黎明”错误地等同于“日出”。
- Agentic RAG:模型通过调用工具深入查看了特定诗篇(2:187),并根据语境推导出了“真黎明(al-fajr al-sadiq)”的精确定义。
这种“慢思考(System 2)”的逻辑,确保了回答的严谨性。
5. 局限性与未来展望
尽管提升巨大,但作者也坦诚了目前的局限:
- 信源范围:目前主要基于《古兰经》,对于圣训(Hadith)和各教法学派(Madhabs)的细微分歧还未完全覆盖。
- 引述洗白(Citation Laundering):存在模型为了使答案看起来可信而强行关联无关诗篇的风险。
总结:ISLAMICFAITHQA 的出现为严肃领域的 LLM 应用树立了新标杆。它告诉我们,要解决幻觉,不仅需要高质量的数据(SFT/RL),更需要给 AI 一套能够自我纠错、循环验证的任务执行系统。