
[arXiv 2026] 从 RAG 到 Agentic RAG:构建忠实可靠的伊斯兰问答系统
From RAG to Agentic RAG for Faithful Islamic Question Answering
本文提出了 ISLAMICFAITHQA,一个包含 3,810 个条目的双语(阿/英)生成式基准测试,并开发了 Agentic RAG 框架。该框架通过结构化工具调用实现迭代证据检索和答案修订,显著提升了 LLM 在伊斯兰教问答中的准确性与可靠性。
TL;DR
在涉及宗教教义等高度严肃的领域,LLM 的“一本正经胡说八道”可能带来严重的社会后果。来自卡塔尔计算研究所(QCRI)等机构的研究者提出了 ISLAMICFAITHQA 基准,并证明了相比于传统的单次 RAG,一种基于智能体决策的 Agentic RAG 框架能通过多轮证据搜索与验证,将模型的事实准确性提升 10% 以上,并显著增强跨语言的鲁棒性。
核心痛点:宗教领域的“幻觉”代价
在伊斯兰教问答中,答案往往涉及法律推理(Fiqh)、教派规范(Madhahib)等。现有模型面临三大难题:
- 盲目自信:即使证据不足,模型也会强行生成答案。
- 评估失效:选择题(MCQ)式的测试容易被“猜对”,无法衡量模型是否真正理解背景。
- 双语失衡:虽然伊斯兰经典主要是阿拉伯语,但全球英语用户的问答需求同样巨大,多数模型无法兼顾。
架构解析:为什么 Agentic RAG 更强?
传统 RAG(检索增强生成)更像是一个“静态插件”:用户提问 -> 检索 Top-K 经文 -> 生成答案。这种方式在面对复杂问题(如继承法、多步法律逻辑)时,往往会因为第一次检索不够精准而导致失败。
本文提出的 Agentic RAG 将检索变成了一个循环决策过程:
- 规划与调用:模型不再是一次性读取,而是决定调用哪些工具(如
search_quran语义搜索、read_ayah精准阅读)。 - 迭代修正:如果初次获取的证据不足以支撑结论,智能体会调整查询语句,直到收集到足够经文。
- 强制引用:答案必须绑定具体的古兰经(Qur'an)节数。
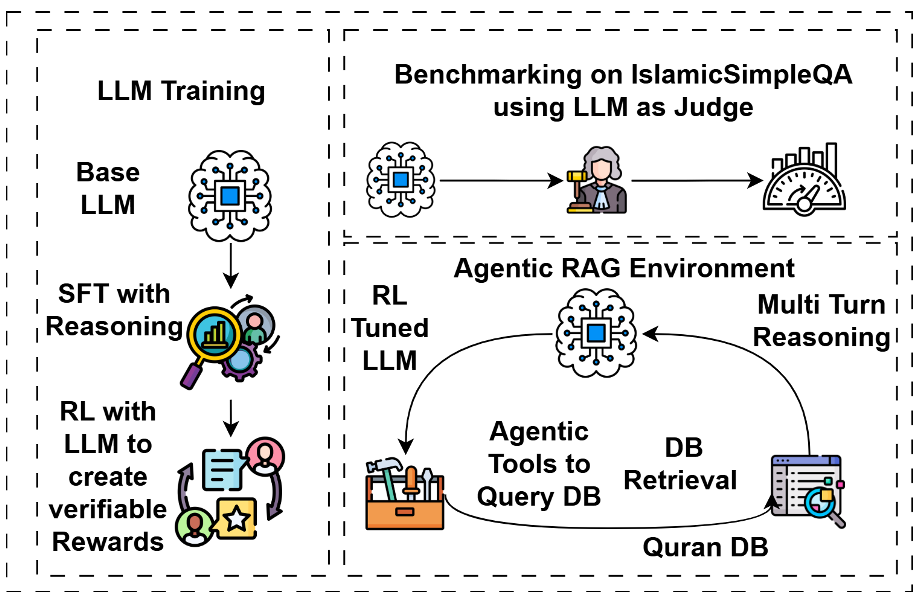 图 1:从数据提取、SFT 到 Agentic RAG 推理的完整开发流程。
定制化对齐:SFT + RL 数据集
除了架构创新,作者还发布了一套总价值极高的伊斯兰本域资源:
- SFT Reasoning (25K):不只是问答,而是带有“推理路径”的微调数据。
- RL Preference (5K):利用 GSPO (Group Sequence Policy Optimization) 算法,训练奖励模型识别出哪些回答是事实准确的,哪些是带有幻觉的。
- Qur'an RAG Index:将古兰经精细切分为 6,236 个原子级 Ayat(节),支持更精准的召回。
实验战绩:小模型也能逆袭
研究团队评估了包括 Llama-3.1, Qwen3, Fanar 在内的数十个模型。结果令人振奋:
- 检索是基石:几乎所有模型在加入 RAG 后,正确率都翻倍增长。
- Agentic 的威力:在 Qwen3-4B 上,Agentic RAG 比标准 RAG 额外提升了 10.05 个百分点,让 4B 小模型在 Arabic-English 双语上的表现趋于平衡,甚至超越了体积更大的基座模型。
- SOTA 表现:Fanar-2-27B + Agentic RAG 在极其严格的 LLM-as-a-Judge 评分下达到了 57.30% 的最高均分。
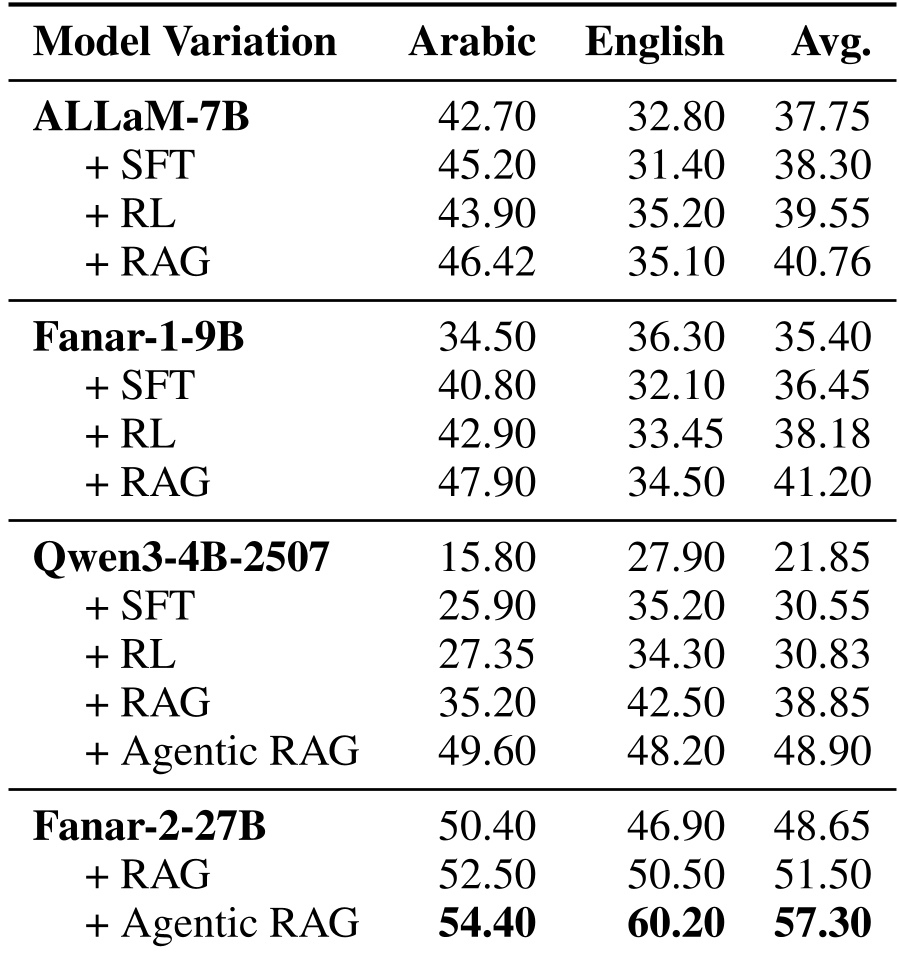 表 1:不同模型配置在 ISLAMICFAITHQA 上的表现统计。
深度洞察:垂直领域的未来
- 弃答(Abstention)与信任:本文通过严格的 Correct/Incorrect/Not_Attempted 三分类评估,逼迫模型在证据不足时选择“我不知道”,这对于建立宗教助手的社会公信力至关重要。
- 工具调用的必然性:单纯的“增加模型参数”或“增加长文本能力”在处理极高精度任务时回报递减。Agentic RAG 提供了一个更具成本效益的途径——增强模型的“搜索习惯”和“查证逻辑”。
局限性与挑战
尽管表现优异,Agentic RAG 仍面临推理延迟和“引用洗白”(Citation Laundering,即生成看似权威但与内容不符的引用)的风险。未来的研究需要进一步引入更广泛的圣训(Hadith)语料库以及不同法学流派的分歧处理。
总结
这项工作不仅填补了伊斯兰 AI 评估的空白,更提供了一种通用的思路:当面对涉及真理和正义的垂直领域时,我们需要让模型学会“三思而后行”,而 Agentic RAG 正是这种查证逻辑的最佳承载者。