
RankCLIP:超越一对一匹配,用排名一致性重塑图文表征空间
RankCLIP: Ranking-Consistent Language-Image Pretraining
本文提出了 RankCLIP,一种创新的图文预训练方法,通过引入排名一致性(Ranking Consistency)将传统的点对(Pair-wise)对比学习扩展到列表式(List-wise)对齐。该方法在 ImageNet-1K 零样本分类上显著超越原始 CLIP,并在多模态检索和鲁棒性基准测试中达到 SOTA 水平。
TL;DR
传统的 CLIP 模型专注于“找伴侣”(一对一配对),而 RankCLIP 则教会模型“排序”(理解语义层级)。通过引入排名一致性损失(Ranking-Consistent Loss),RankCLIP 在不增加额外数据和计算资源的前提下,显著提升了模型对多模态语义结构的理解能力。在 ImageNet-1K 零样本分类中,它实现了对原始 CLIP 的降维打击。
背景定位
自 CLIP 问世以来,对比学习(Contrastive Learning)统治了图文对齐领域。然而,这种 paradigm 存在一个本质的 Inductive Bias 缺陷:即所有的负样本都被视为平等的噪音。但在现实世界中,语义是连续且有层级的(例如:金毛犬与拉布拉多犬的相似度显然高于金毛犬与电饭煲)。RankCLIP 正是针对这一痛点,将预训练任务从简单的“二元分类”推向了更深层的“结构化排序”。
痛点深挖:消失的语义层级
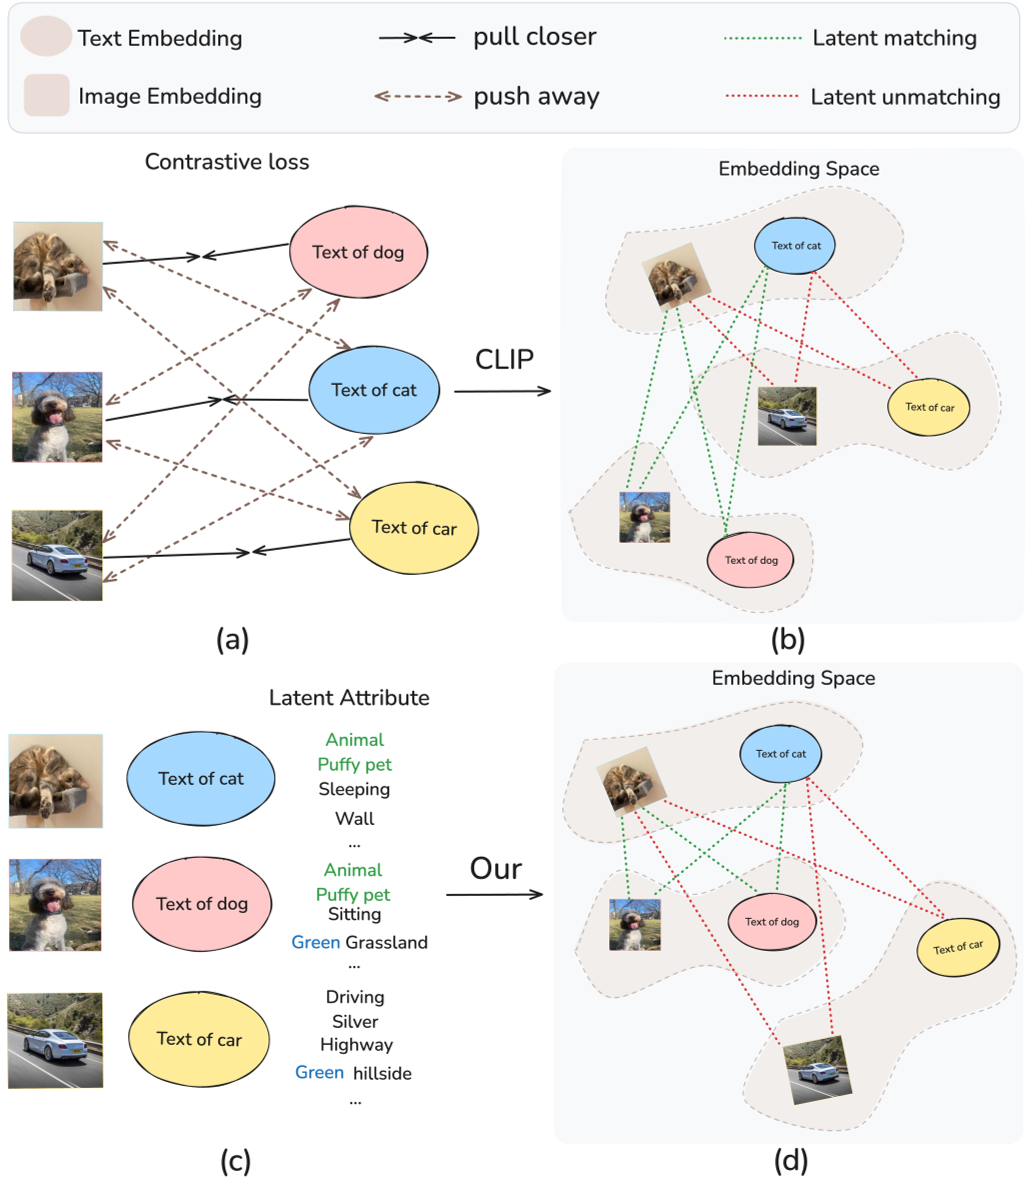
在图 1 中,我们可以清晰地看到作者的动机:
- CLIP 的局限:在训练阶段,模型只知道“狗图”配“狗文”。对于“猫文”和“汽车文”,它统统视为负样本进行推离。
- RankCLIP 的洞察:作者提出,如果两张图在视觉空间很像,那么它们对应的描述在文本空间也应该保持相似的排名。这种**模态内(In-modal)和跨模态(Cross-modal)**的结构一致性,提供了极其丰富的隐式监督信号。
核心方法:列表式排名模型 (List-wise Ranking)
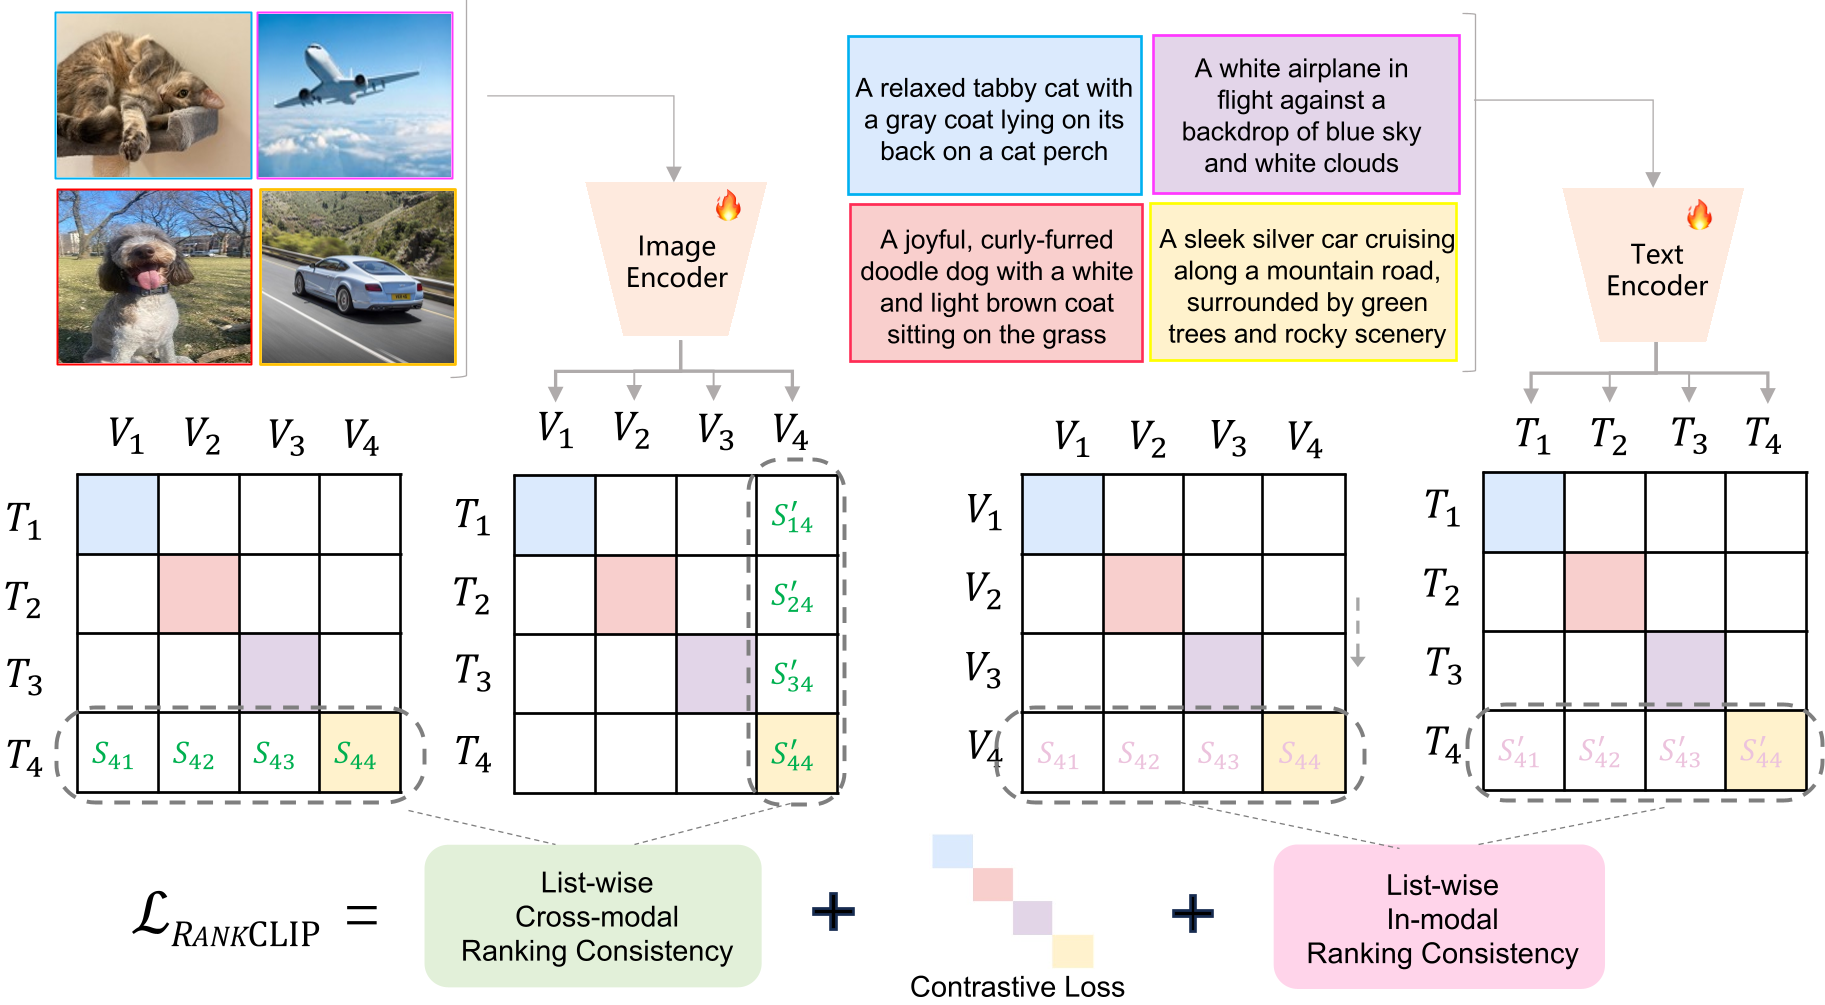
RankCLIP 的核心在于将排名问题数学化。它并不仅仅比较 对,而是考察整个 Batch 内的相似度分布。
1. 排名公式化 (Plackett-Luce Model)
模型使用 Plackett-Luce (PL) 概率模型来衡量排名序列的对齐度。这是一种基于得分(相似度)计算整个列表排列概率的模型。通过最大化这个对齐概率,模型被强制要求在不同模态下维护相同的“邻居关系”。
2. 跨模态与模态内对齐
- 跨模态一致性:确保从图像看文本的视角,与从文本看图像的视角,其排名权重是对称的。
- 模态内一致性:确保“图像 vs 其他图像”的距离矩阵,与“文本 vs 其他文本”的距离矩阵在拓扑结构上趋同。
实验与结果分析
RankCLIP 在多个维度展现了其统治力:
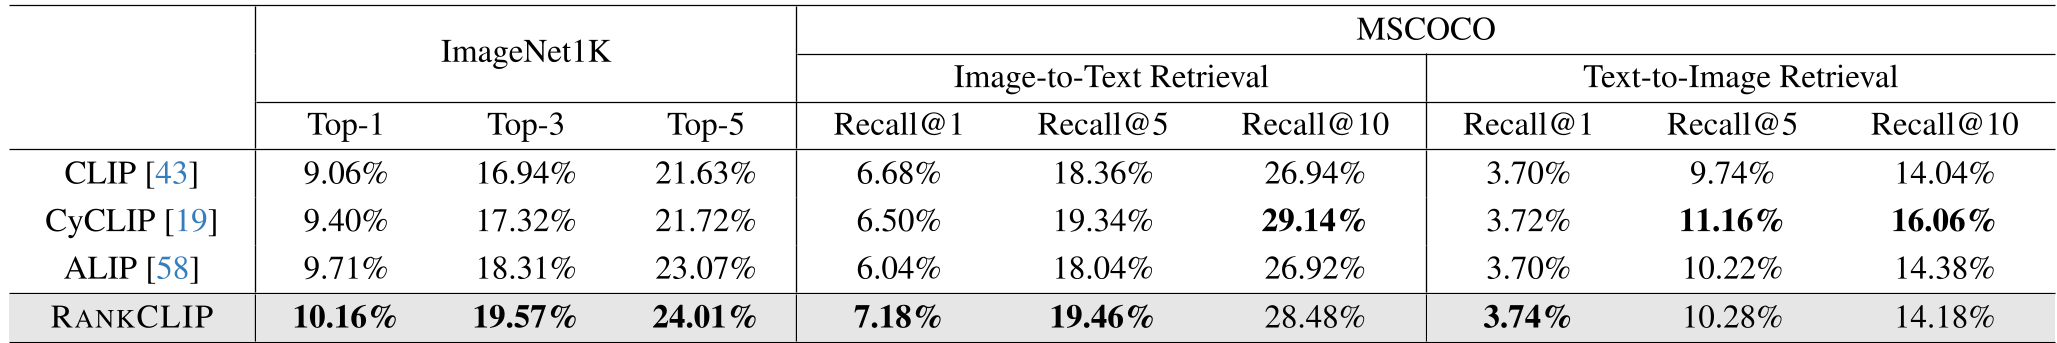
- SOTA 性能:在 CC3M 这种规模受限的数据集上,RankCLIP 将 ImageNet Top-1 准确率拉升至 10.16%。
- 惊人的扩展性:在 15M 规模的 YFCC 数据集上,RankCLIP 相比 CLIP 的领先优势进一步扩大,证明了该方法在大规模预训练中的潜力。
- 模态缝隙(Modality Gap)的缩减:分析表明(见原文图 6),RankCLIP 显著缩小了文本和图像表征在 Latent Space 中的几何距离。
细粒度定位能力
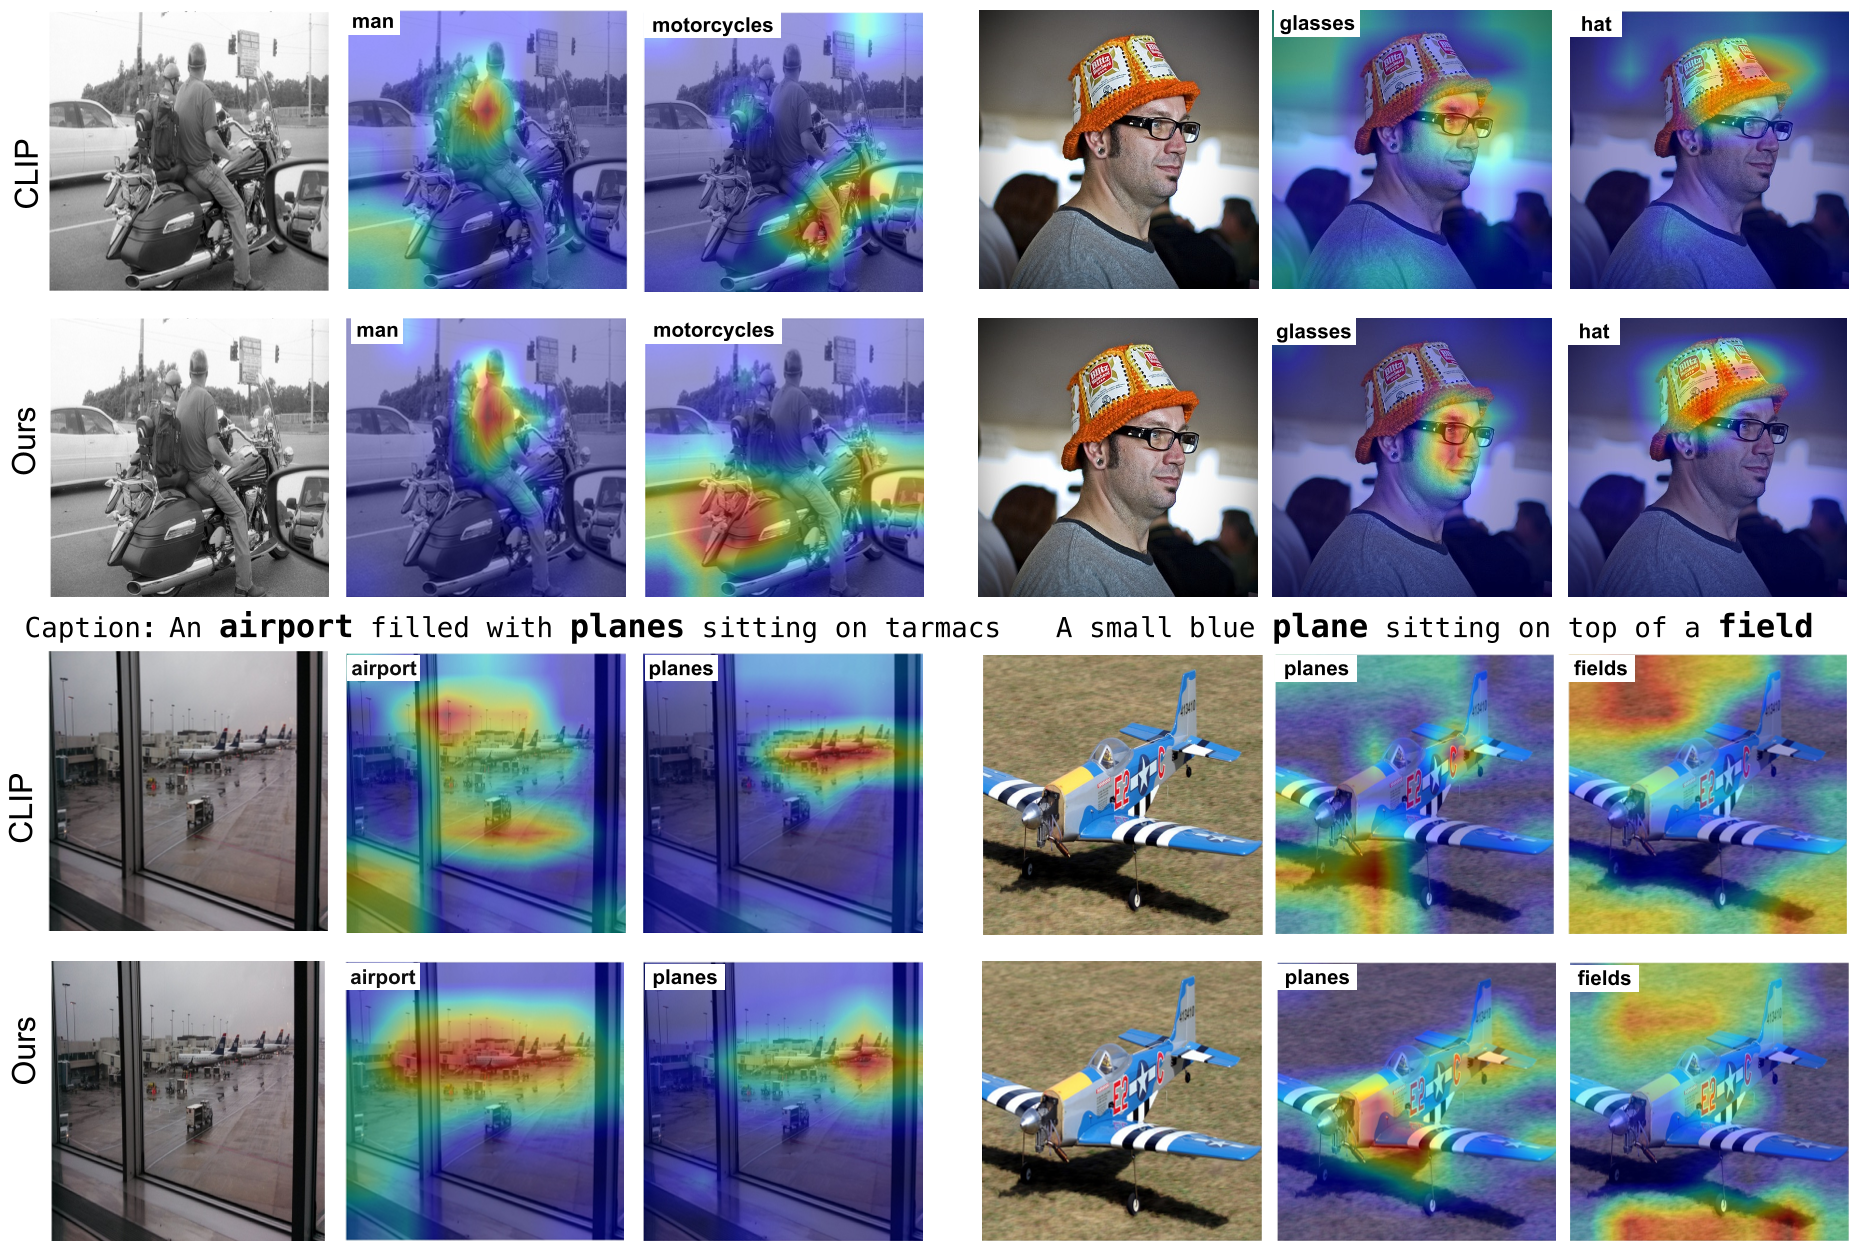
通过 CAM (Class Activation Maps) 观察,RankCLIP 在接收到“铺满飞机的飞机场”指令时,能够更精准地聚焦于飞机个体,而 CLIP 则容易模糊地关注背景。这说明排名损失约束让模型学到了更具判别性的视觉特征。
深度洞察与总结
RankCLIP 的成功揭示了一个重要的研究方向:对比学习不应仅仅是点对点的相互吸引与排斥,更是群体关系的拓扑对齐。
局限性与展望
- 计算复杂度:列表式损失在计算时涉及到 Batch 内的全矩阵操作,虽然没有增加额外的 Encoder 负担,但在 Batch Size 极大(如 32k+)时,其梯度计算的内存压力值得关注。
- 未来启示:这种 Ranking 的思路非常适合引入到大语言模型(LLM)的对齐(RLHF)中,或者用于改进长文本检索系统。
结语:作为资深主编,我认为 RankCLIP 是对对比学习范式的一次优雅补丁。它没有使用复杂的合成数据或繁琐的多阶段训练,而是通过回归统计学中的经典排名模型,找回了被 CLIP 遗忘的“语义邻里关系”。