
RankFlow:打破重排序瓶颈,LLM 多角色协作开启检索新范式
RankFlow: A Multi-Role Collaborative Reranking Workflow Utilizing Large Language Models
本文提出了 RankFlow,一种基于大语言模型(LLM)的多角色协同重排序(Reranking)框架。该框架将重排序任务拆解为查询重写、伪答案生成、文档摘要和最终排序四个环节,实现了在 TREC-DL、BEIR 和 NovelEval 等多个检索基准测试上的 SOTA 性能。
TL;DR
在信息检索(IR)领域,重排序(Reranking)是决定用户体验的关键。传统的文本重排序往往面临查询模糊和文档冗余的双重挑战。来自罗格斯大学和康涅狄格大学的研究团队提出了 RankFlow,通过将重排序任务分解为 Rewriter(重写者)、Answerer(回答者)、Summarizer(摘要者) 和 Reranker(排序者) 四个角色,显著提升了 LLM 在处理复杂查询时的准确性。在多个 SOTA 基准上,RankFlow 展现了超越 RankGPT-4 的统治力。
背景定位:从“单一提示词”到“结构化工作流”
目前的 LLM 重排序研究主要集中在 Listwise 方法(如 RankGPT),即让模型一次性对一组文档进行排序。虽然效果优于 Pointwise,但当面对简短的“搜索框式”查询或动辄成千上万词的候选文档时,LLM 容易迷失在长上下文中,导致推理能力下降。RankFlow 的出现,标志着重排序从简单的 Prompt Engineering 进化到了结构化代理工作流 (Agentic Workflow) 阶段。
痛点深挖:为什么 LLM 需要“帮手”?
- 查询之困:用户输入的 Query(如 "wifi vs bluetooth")往往过于宽泛,缺乏 IR 系统所需的判别性特征。
- 噪声之灾:原始网页文档包含大量 HTML 残留或无关背景,不仅浪费 Token,更干扰了 LLM 对相关性的判断。
- 推理之压:在 Listwise 排序中,随着文档数量增加,模型的指令遵循能力(Instruction Following)呈指数级衰减。
方法论详解:RankFlow 的四重奏
RankFlow 并不是简单地调用四次 LLM,而是设计了一套严密的逻辑链路:
1. Rewriter & Answerer:语义增强层
- Rewriter:将原始 Query 转化为更正式、具体的描述。
- Answerer:这一步最直觉的改动在于生成一个“伪答案”。既然 LLM 已经博览群书,直接让它先针对问题写一个标准答案,再用这个“完美答案”去匹配真实文档,其相关性判断会精准得多。
2. Summarizer:上下文蒸馏层
这是 RankFlow 提升效率的核心。通过 Summarizer 对每个 Passage 进行预处理,剥离冗余信息。在实验中,这不仅提升了性能,还大大缩减了 Reranker 阶段的 Token 输入压力。
3. Reranker:深度推理层
在最终排序阶段,作者引入了 CoT(思维链) 和 相关性标准(Relevance Standard)。模型不再是直接给出一个列表,而是先“思考”文档为何相关,这种思维过程确保了排序逻辑的一致性。
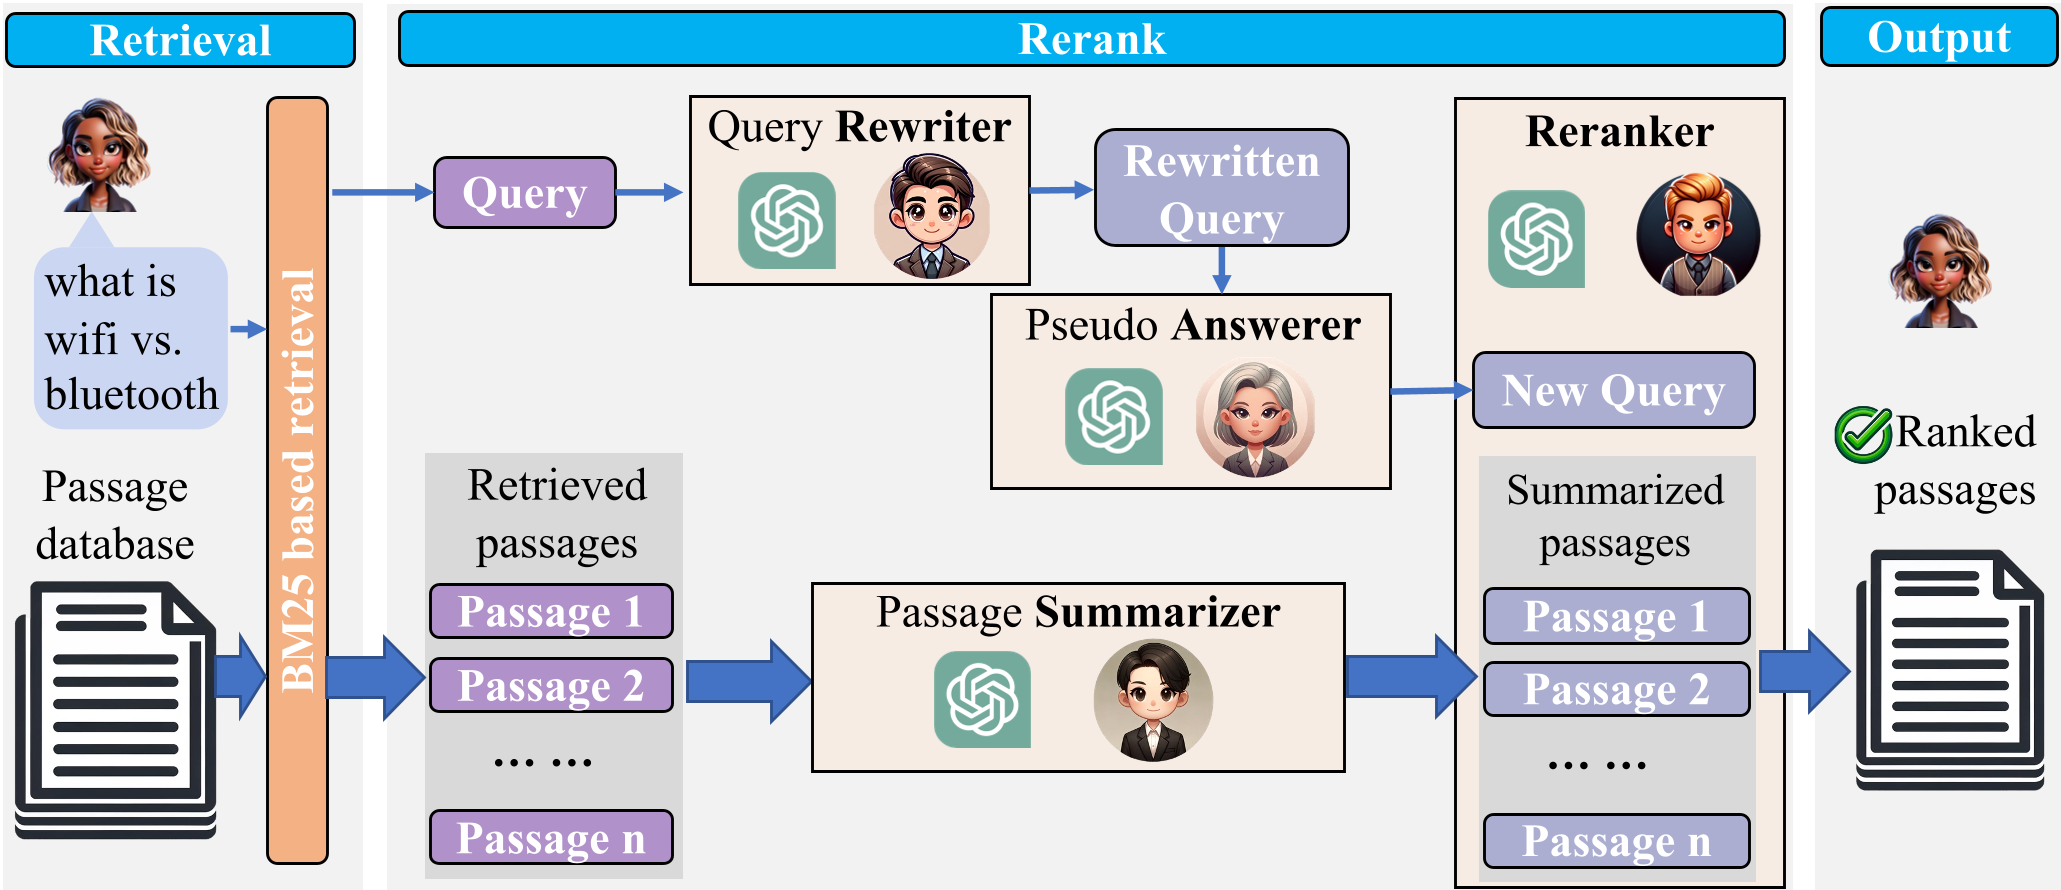 图 1:RankFlow 的四角色协同工作流架构
实验与结果:全线 SOTA
RankFlow 在三大 benchmark 上进行了严苛测试:
- TREC-DL:在 2019/2020 两个测试集上,RankFlow 位居 unsupervised 方法榜首。
- NovelEval:这是为了避免数据污染而专门设计的最新数据集。在此数据集上,RankFlow 相比强劲基线 RankGPT-4 提升了 5 个百分点(NDCG@10)。
- 小模型的福音:在 Llama-3-8B 上,RankFlow 带来了超过 5 点 的性能飞跃。这说明通过 Summarizer 缩减上下文,可以让轻量级模型也具备强大的重排序能力。
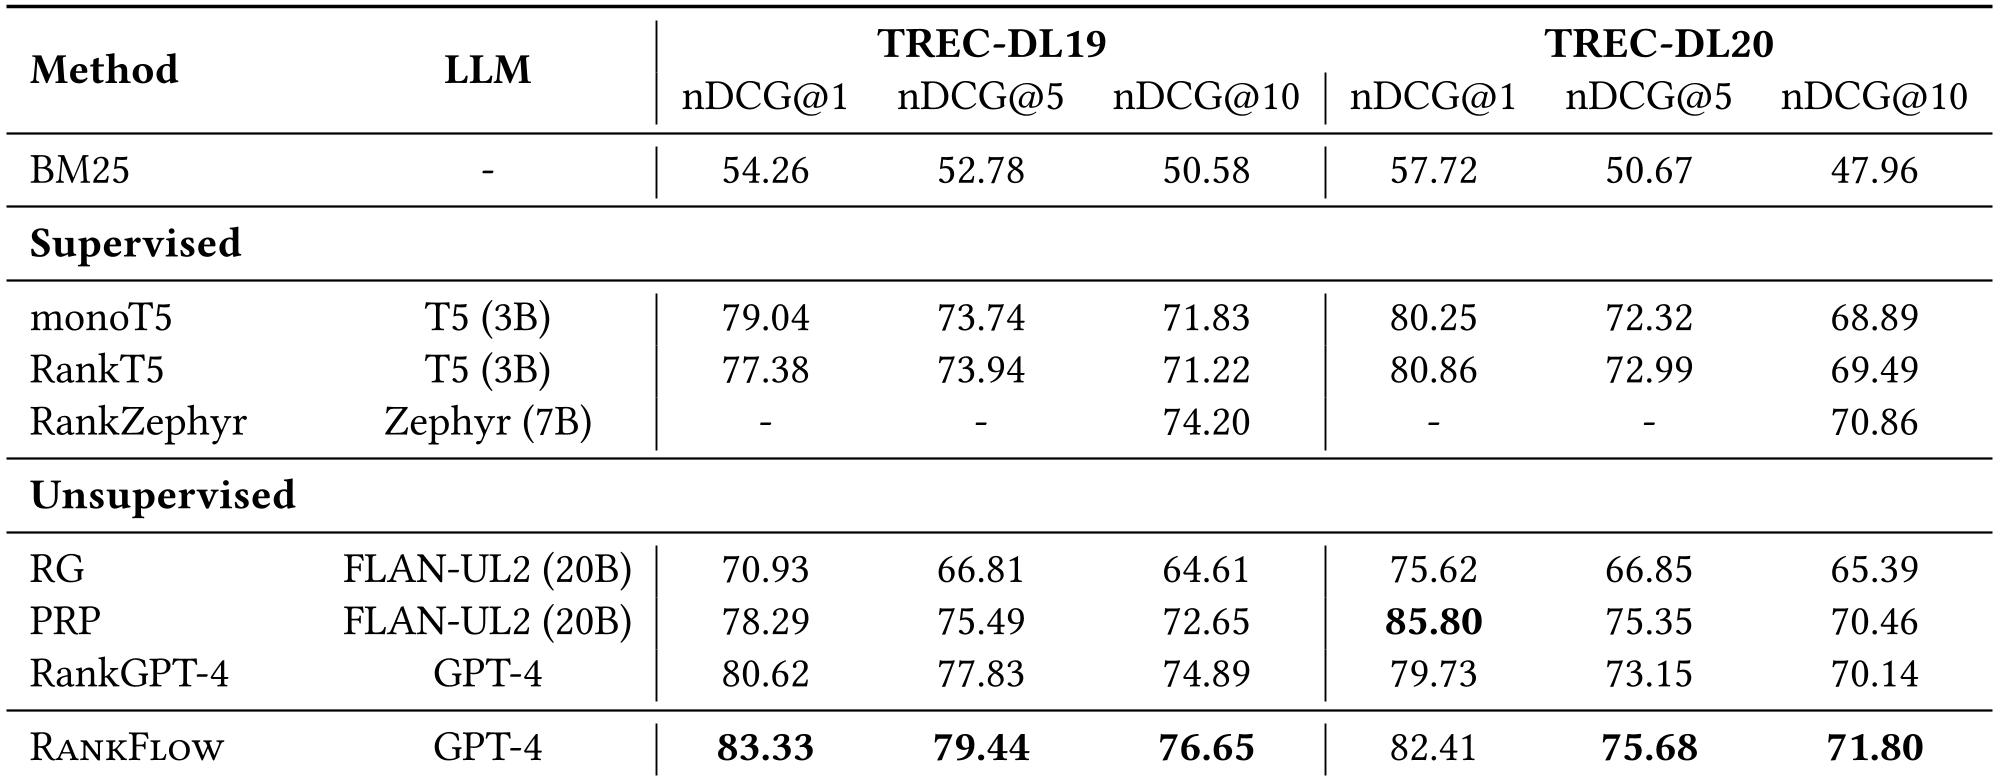 表 1:RankFlow 在 TREC-DL 上的性能表现。
成本分析:更快、更准、更省
尽管 RankFlow 涉及多个步骤,但作者提出了一种“RankFlow w. Local Passage”模式。由于 Summarizer 处理后的文档可以本地缓存,因而在后续大规模排序中,总 Token 消耗减少了 29% 以上,推理延迟降低了 26%。这证明了该框架具备极高的工程落地价值。
深度洞察与总结
Takeaway:RankFlow 成功的本质在于将非结构化的文本相似度计算,转化为了结构化的语义特征对齐。它通过 Summarizer 降低了 LLM 的认知负载,通过 Rewriter/Answerer 丰富了语义锚点。
局限性:尽管缓存机制能缓解成本,但在长尾查询(无法预先缓存文档摘要)的情况下,多步 LLM 调用仍存在一定的冷启动延迟。
未来展望:这种“多角色协同”的思路可以进一步推广到多模态检索或复杂问题的长链式推理中,是通往垂直领域 AI Agent 的必经之路。