
ReasonAlloc:破解推理长文本瓶颈,精准分配 KV Cache 的“推理波”
ReasonAlloc: Hierarchical Decoding-Time KV Cache Budget Allocation for Reasoning Models
本文提出了 ReasonAlloc,一个专为大语言模型(LLM)推理逻辑任务设计的、无需训练的层级化 KV Cache 预算分配框架。它通过离线校准“推理波”层间需求和在线动态路由头间资源,显著提升了 DeepSeek-R1 等推理模型在极小显存预算下的性能。
TL;DR
在处理复杂的数学推理任务时,DeepSeek-R1 等模型生成的思维链(CoT)极其冗长,导致 KV Cache 迅速膨胀。ReasonAlloc 提出了一种创新的“层级化资源路由”方案:它不仅发现大模型在推理时存在固有的“推理波(Reasoning Wave)”层间特征,还通过在线动态分配技术,将显存预算精准投喂给最有用的注意力头,在不牺牲精度的情况下实现了大幅度的显存压缩和速度提升。
背景:逻辑推理模型的“显存饥渴”
长文本推理(Reasoning)与普通文本生成不同,它依赖严密的逻辑闭环。现有的 KV Cache 压缩技术(如 SnapKV)倾向于“一刀切”——每层、每个注意力头分到的存储配额(Budget)是一样多的。
然而,作者通过实验发现,这极大地浪费了显存:
- 架构异构性:有些层负责宏观感知,需要大量缓存;有些层负责局部逻辑,只需少量。
- 动态波动:在生成逻辑推导的过程中,不同的注意力头在不同时刻的贡献度瞬息万变。
如果强行采用统一预算,模型关键的“逻辑节点” Token 可能会被误删,导致推导链条断裂,模型开始出现胡言乱语(Hallucination)。
核心发现:任务无关的“推理波 (Reasoning Wave)”
作者对 DeepSeek-R1 分化模型进行了深度剖析,发现了一个非常有趣的物理现象:尽管输入的问题在变,但特定架构模型对 KV Cache 的需求曲线在层间是极其稳定的。这种非线性的需求曲线被命名为 “推理波”。
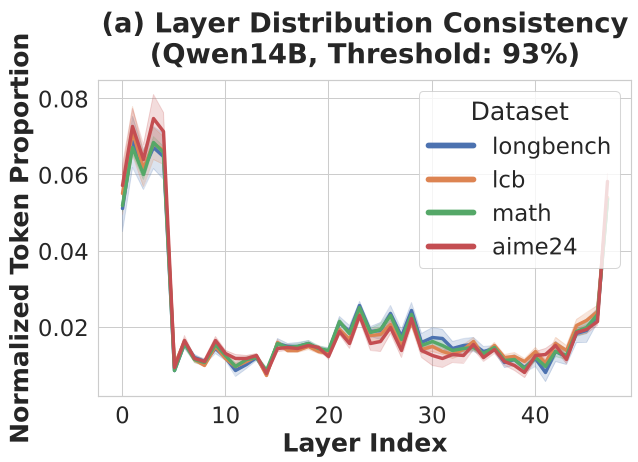 上图显示:浅层(读取上下文)和深层(结果验证)需求量巨大,中层则相对震荡,这完全打破了前人提出的“金字塔递减”假设。
Methodology:两手抓的层级化分配
ReasonAlloc 将压缩问题转化为了一个资源路由问题,分为两步走:
1. 离线层间预分配 (Offline Layer-wise Preallocation)
基于上述“推理波”的观察,模型在正式推理前,会先通过少量样本校准出各层的“原始需求”。为了防止某些层独占显存导致其他层“饿死”,作者设计了一个鲁棒化算子(Robustification Operator)。
- 平滑:取平方根收缩,缓解极端值。
- 保护:设定上下限,确保每一层都有最低限度的“工作记忆”。
2. 在线头间动态路由 (Online Head-wise Dynamic Routing)
在推理过程中,每生成 128 个字符(Δ步长),算法就会重新评估每一个注意力头的“有用性”。
- 动态路由:如果某个头在这段逻辑推导中表现活跃,系统会临时调拨更多的 KV Cache 额度给它。
实验战绩:小预算下的奇迹
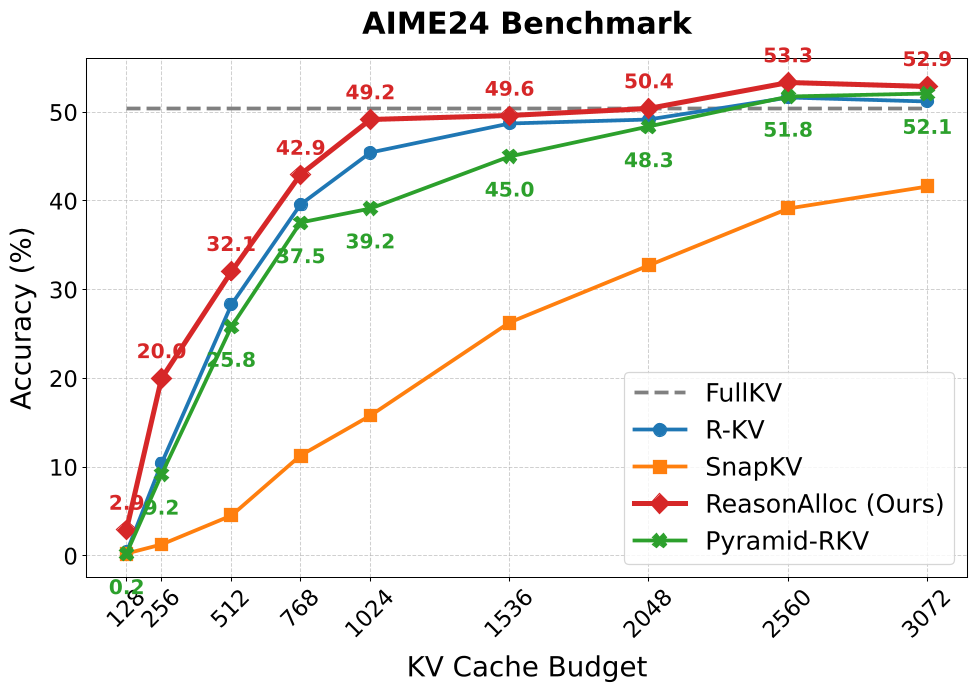
在数学竞赛级别的题目 AIME 2024 上,ReasonAlloc 展示了极强的韧性。
- 精度逆袭:在极度苛刻的 256 Token 预算下,传统的 R-KV 准确率为 10.42%,而 ReasonAlloc 直接拉升到了 20.00%。
- 吞吐飞跃:在 16K 上下文生成时,相比不压缩的情况(FullKV),ReasonAlloc 达到了 5.52 倍 的吞吐量提升。
案例分析:为何它是“真推理”?
在 AIME 的一道三次方程求解题中,基线模型因为删除了早期的代数约束 Token,最后只能靠猜;而 ReasonAlloc 成功保留了关键的因式分解凭证,完整走通了整个推导过程。
专家总结与展望
ReasonAlloc 的价值在于它跳出了“如何打分”的旧框架,转向了“如何分配”的新思路。
- 即插即用:它不改模型权值,不需要重新训练,能无缝兼容现有的 Token 剔除算法。
- 局限性:目前的层间分配依赖于前期的离线校准。虽然文末提到了全动态方案,但在极端长文本下的实时开销仍需进一步工程优化。
对于正在构建长上下文推理服务的工程师来说,ReasonAlloc 提供了一个极其经济且高效的范式:了解你的模型架构,比疯狂剔除数据更管用。