
SiPeR:精准破解场景化对话推荐中的“何地”与“何物”难题
Where and What: Reasoning Dynamic and Implicit Preferences in Situated Conversational Recommendation
本文提出了 SiPeR (Situated Preference Reasoning),一个专门针对场景化对话推荐 (SCR) 任务的新颖框架。该框架集成了场景转移估计 (STE) 和贝叶斯逆向推理 (BI-INF) 机制,在 SIMMC 2.1 和 SCREEN 两个基准数据集上取得了 SOTA 性能。
TL;DR
在购物中心或 3D 虚拟店面中,推荐系统不仅要懂“话”,还要懂“景”。香港理工大学的研究团队提出了 SiPeR 框架,通过场景转移估计 (STE) 解决“该带用户去哪看 (Where)”的问题,并利用贝叶斯逆向推理 (BI-INF) 解决“用户内心真正想要哪件 (What)”的问题。该方法在多个 SOTA 基准上实现了 10% 以上的精度飞跃。
痛点深挖:为何场景化推荐这么难?
在真实物理或虚拟环境中,对话推荐系统 (CRS) 面临着比纯文本对话更复杂的挑战:
- 动态位置依赖 (Dynamic Situations):当用户说“我想看点户外运动的”,如果当前画面全是西装,系统必须主动做出“场景切换”决策。
- 隐性偏好陷阱 (Implicit Preferences):用户说“尺码是对的,但还有别的吗?”,这背后隐藏了对款式、颜色或材质的不满。传统的多模态大模型 (MLLM) 往往只能看到“尺码对”这个表层信息,而忽略了深层的不匹配。
核心方法:SiPeR 的双轮驱动机制
SiPeR 的核心在于将复杂的感知过程拆解为两个逻辑严密的推理模块。
1. 场景转移估计 (STE):从感知到导航
SiPeR 不直接在海量视觉像素中匹配场景,而是采用了一种“生成-检索”的混合模式:
- 语义预想:首先让 MLLM 根据对话历史生成一个理想中的“目标场景轮廓 (Profile)”。
- 粗到细检索:将生成的轮廓作为 Query,在场景库中进行稠密编码匹配,确保最终切换到的场景是真实的且最符合预期的环境。
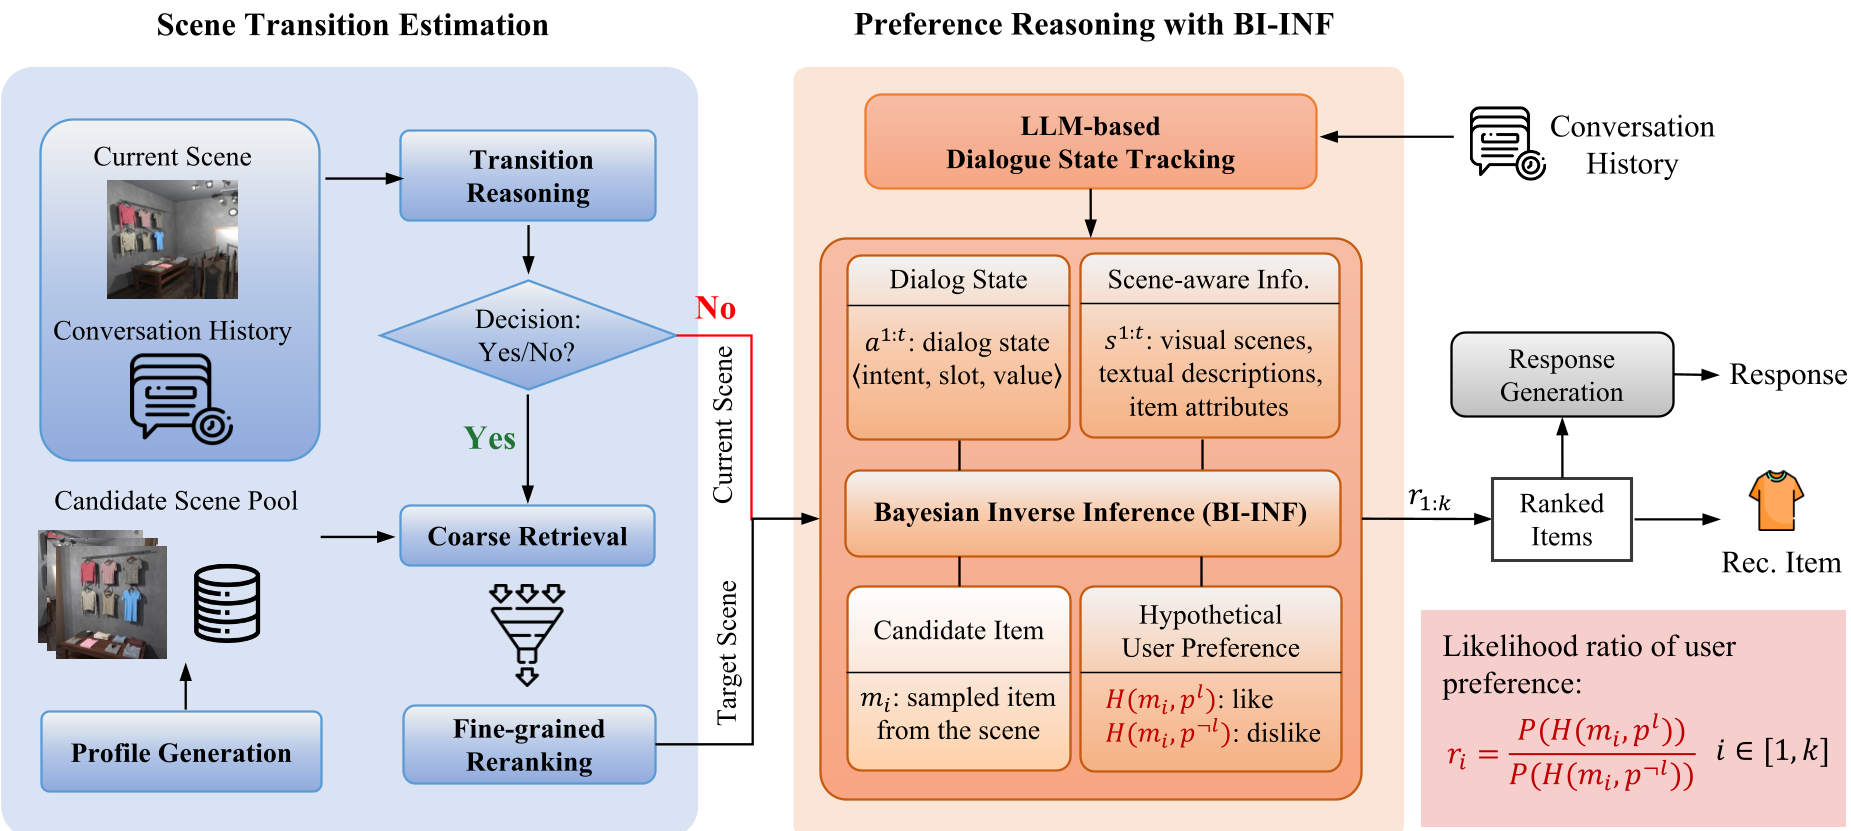 图 1:SiPeR 整体框架,展示了从场景转移到隐性偏好推理的全流程。
2. 贝叶斯逆向推理 (BI-INF):洞察用户心智
这是本文最具学术深度的地方。作者受到了心理理论 (Theory of Mind) 的启发,不直接询问模型“用户喜欢哪个”,而是建模一个逆向概率问题:
- 假设竞争:同时设立两个假设——(用户喜欢该物品)和 (用户不喜欢)。
- 似然比计算:计算在每种假设下,用户说出当前这句话(Action)的概率。如果观测到的对话在“喜欢”假设下概率更高,则该物品得分更高。这种方法有效解决了 LLM 在长对话中容易产生的幻觉和事实僵硬问题。
实验与结果:全方位吊打基线
SiPeR 与 GPT-4o、LLaVA-NeXT 以及 ReGeS 等强基线进行了对比。
1. 推荐准确率 (Recommendation Accuracy)
在 SIMMC 2.1 数据集上,SiPeR 的 R@1 达到了 38.75%,而未经过此类结构化推理的 Qwen2.5-VL 仅为 29.47%。这意味着贝叶斯逆向推理确实挖掘出了 MLLM 在普通 Prompt 模式下无法触达的隱性偏好。
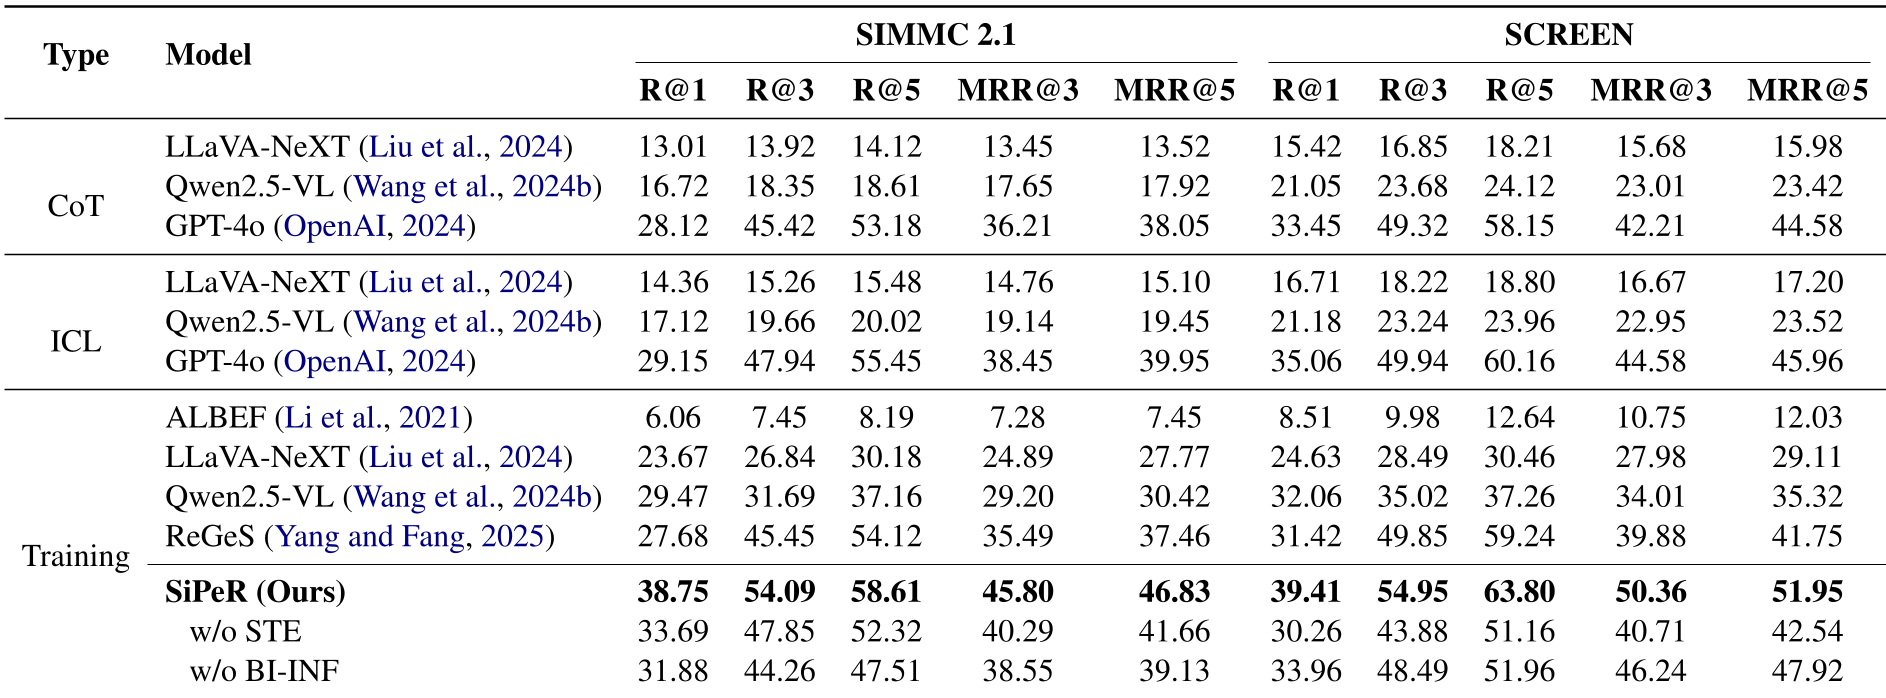 表 1:在两个主要数据集上的推荐性能对比。
2. 人工评价:更懂场景的 AI
在人工评价中,SiPeR 在场景化程度 (Situatedness) 上的得分 (1.84) 显著高于纯文本模型和通用 MLLM。消融实验证明,一旦去掉 STE(场景转移)模块,模型性能会断崖式下降(R@1 从 39.41% 掉到 30.26%),这印证了“在哪荐”和“荐什么”是 SCR 任务中不可分割的整体。
总结与见解
SiPeR 的成功证明了,对于复杂的交互式任务,单纯堆砌模型规模 (Scale) 并非最优解,结构化的推理机制 (Mechanism) 能够带来更高的价值。
- 局限性:由于需要对每个候选物品计算似然比,当场景中候选物极多时,计算开销会显著增加。
- 未来展望:这种“逆向建模用户心智”的思想,可以被广泛应用于自动驾驶人机交互、虚拟现实导览等更广阔的具身智能领域。
主编点评:在 MLLM 泛滥的今天,SiPeR 难能可贵地回归了认知科学的本质,利用贝叶斯工具重新武装了大模型,为场景化 AI 提供了一个清晰且可落地的范式。