
突破深度诅咒:Recirculation 如何在零微调下赋予 Transformer 动力系统状态追踪能力
Recirculation
本文提出了“再循环”(Recirculation),一种无需重新训练即可在推理期直接增强现成 Transformer 基础模型的架构机制。该方法通过在相邻时间步之间将深层残差表征回流并注入至浅层,将前馈 Transformer 转化为具备显式信念状态(Belief State)追踪能力的动态系统。实验表明,在 Gemma 3 等模型上,该方法结合轻量自适应调节(Adaptive Recirculation)实现了高达 23% 的困惑度(Perplexity)降幅,并在 GSM8k 推理任务上将 pass@128 错误率降低了 20.9%,且在自回归生成阶段几乎不引入额外延迟。
1. 核心速览 (Executive Summary)
- TL;DR:来自 Google DeepMind 的研究团队提出了 Recirculation(再循环)——一种面向现成(Off-the-shelf)Transformer 基础模型的推理期架构增强机制。该方法通过在时间步推进中将深层计算的高阶语义“渗漏回流”至浅层残差流,打破了前馈网络受制于模型深度的序列状态追踪瓶颈。在完全不改动原始权重的条件下,模型困惑度下降高达 23%,GSM8k 推理错误率显著降低 20.9%,且生成期几乎零额外延迟。
- 背景定位:这是模型可解释性、表示工程(Representation Engineering)与测试期动力学计算(Inference-time Scaling)交叉领域的突破性工作。它既非简单堆叠深度的 Looped Transformer,亦非高成本重训的 Recurrent Transformer,而是通过发现并利用预训练模型内在的架构可供性(Architectural Affordances),首次证明了免训练的跨步激活反馈足以构成连续信念状态追踪器。
2. 痛点与动机 (Problem & Motivation)
2.1 前馈架构的“深度诅咒”与状态追踪失效
大语言模型在多轮对话断联、多步推理幻觉以及歧义消解(Contextualization)上的典型失效,本质上归因于其底层动力学机制的缺失。
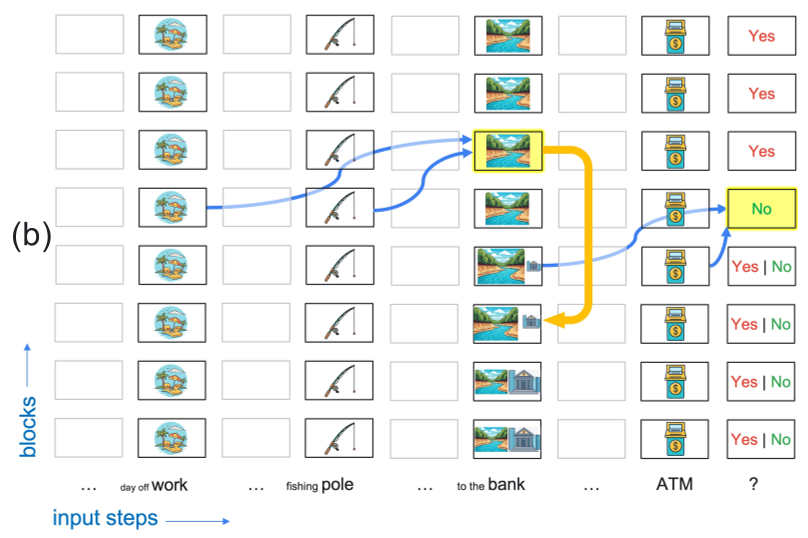 图 2:(a) 传统 Transformer 中,歧义词(如“bank”)在浅层无法被有效消解,直到深层才完成语义确定,导致后续处理无法利用该高阶状态;(b) Recirculation 将深层解析后的状态表征回流至浅层,为后续时步提供充分的上下文状态。
如图 2(a) 所示,当输入多义词(如既有“河岸”又有“银行”含义的 bank)时,模型直到顶层才能基于前序语境(钓鱼)消除歧义。然而,由于前馈 Transformer 的状态传递严格沿对角线向右上流动,当后续 token 在浅层进行计算时,该高阶信念状态无法被浅层注意力头读取,导致模型在多轮交互中出现极其荒谬的“立场翻转”(例如在后续对话中又将 bank 理解为有 ATM 机的金融机构)。
2.2 理论局限:为什么 Looping 无法解决问题?
以往针对该问题的尝试主要存在两大学派的局限:
- Looped Transformers(深度循环):将相同层块循环执行多次()。但这仅仅等价于具有权重共享的更深前馈网络,其时间步 的状态依然无法基于 步形成的任意隐式状态进行一阶马尔可夫转移更新()。
- 显式思维链(CoT)与重训 RNN 架构:CoT 占用宝贵的输出序列长度,且将低级状态追踪与高级逻辑推理解耦不良;而端到端训练 Block-Recurrent Transformer 则牺牲了并行预填充(Prefill)的高效训练吞吐。
2.3 物理直觉:残差流的天然跨层表征对齐
作者的核心 Insight 在于:由于 Transformer 的残差流本质上是一个所有层均可写入的“共享黑板”(Shared Blackboard,如 Elhage et al. 所述),各层表征之间天然保持着高度的一致性与线性可加性。因此,无需引入任何复杂的跨层 Affine 投影或 Cross-Attention Adapter,直接在隐空间进行微量激活渗漏(Activation Leakage),即可实现安全的自驱动导引(Self-steering)。
3. 方法论详解 (Methodology - The Core)
3.1 拓扑展开:Recirculation vs. Looped Transformer
为了厘清 Recirculation 与现有循环机制的本质差异,作者在二维计算网格(深度 时间步)上对比了展开计算流:
 图 3:(a) 单一栈内设置反馈连接;(b) 深度循环(Looped Transformer),仅在深度方向展开;(c) Recirculation,在深度与时间步两个维度同时展开。
- Looped Transformer(图 3b):计算流仅在当前时间步内纵向循环,其状态依赖于层深的递增。
- Recirculation(图 3c):将第 步深层源层 的激活,直接跨时间步注入到第 步的浅层目标层 。这使得同一物理层在 与 步能够分别承载 与 ,从而在数学上完整构成了任意状态转移函数 。
3.2 激活混合与重归一化方程
在最简形式(单次迭代回流)下,第 步在目标层 的残差流输出更新公式为:
其中:
- 表示在架构副本步 、输入时间步 、层级 处的残差流向量。
- 与 分别代表选定的源层(Source Layer)与目标层(Destination Layer)索引。
- 为混合系数(通常在基础版中设定 或 )。
- 为 范数重归一化函数,用于消除因网络加深导致的残差向量模长发散问题(Residual Growth):
3.3 进阶演化:自适应再循环 (Adaptive Recirculation)
为了进一步释放性能,作者提出了不改动 LLM 主干权重的 Adaptive Recirculation: 利用一个极轻量的 2 层 GELU-MLP,根据当前 token 在源层与目标层的实时激活拼接向量 ,动态输出通道维度的自适应门控向量 :
该机制使模型能够根据词性(PoS)及上下文信息熵,自主决定何时、以何种强度调取先前的深层信念。
4. 实验与结果 (Experiments & Results)
4.1 超参数空间扫描与跨模型普适性
作者在 Gemma 3 (1B, 4B, 12B) 及其他模型家族上对 层对及 进行了系统性网格搜索。
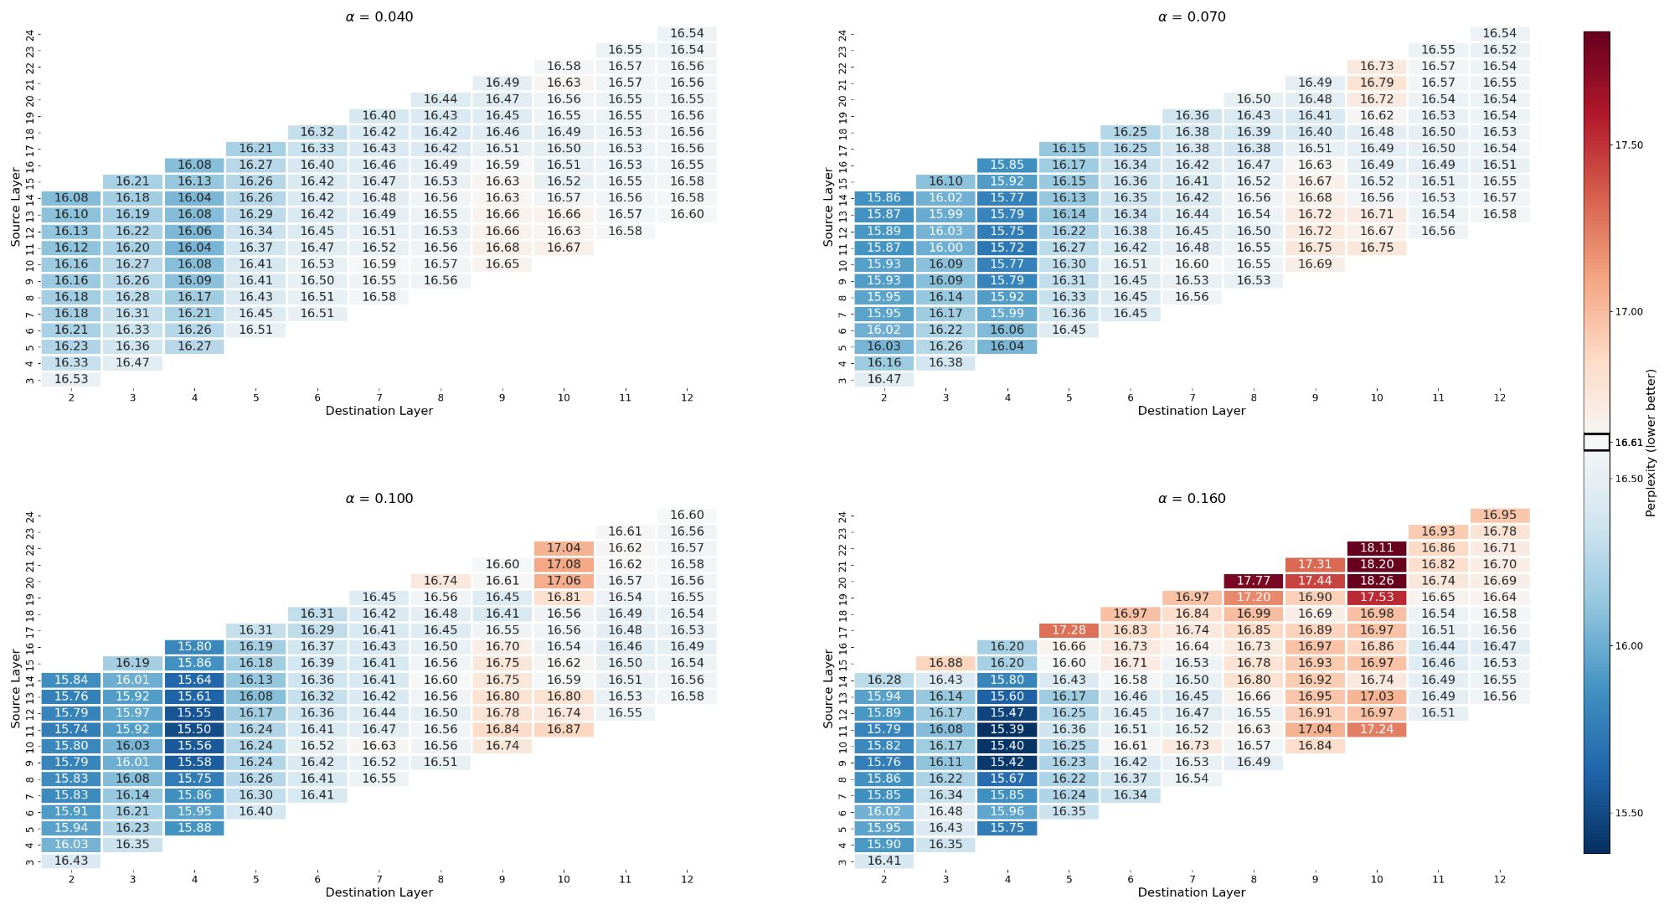 图 5:Gemma 3 1B 在 arXiv 验证集上的超参数扫描热力图,蓝色区域代表困惑度显著下降。
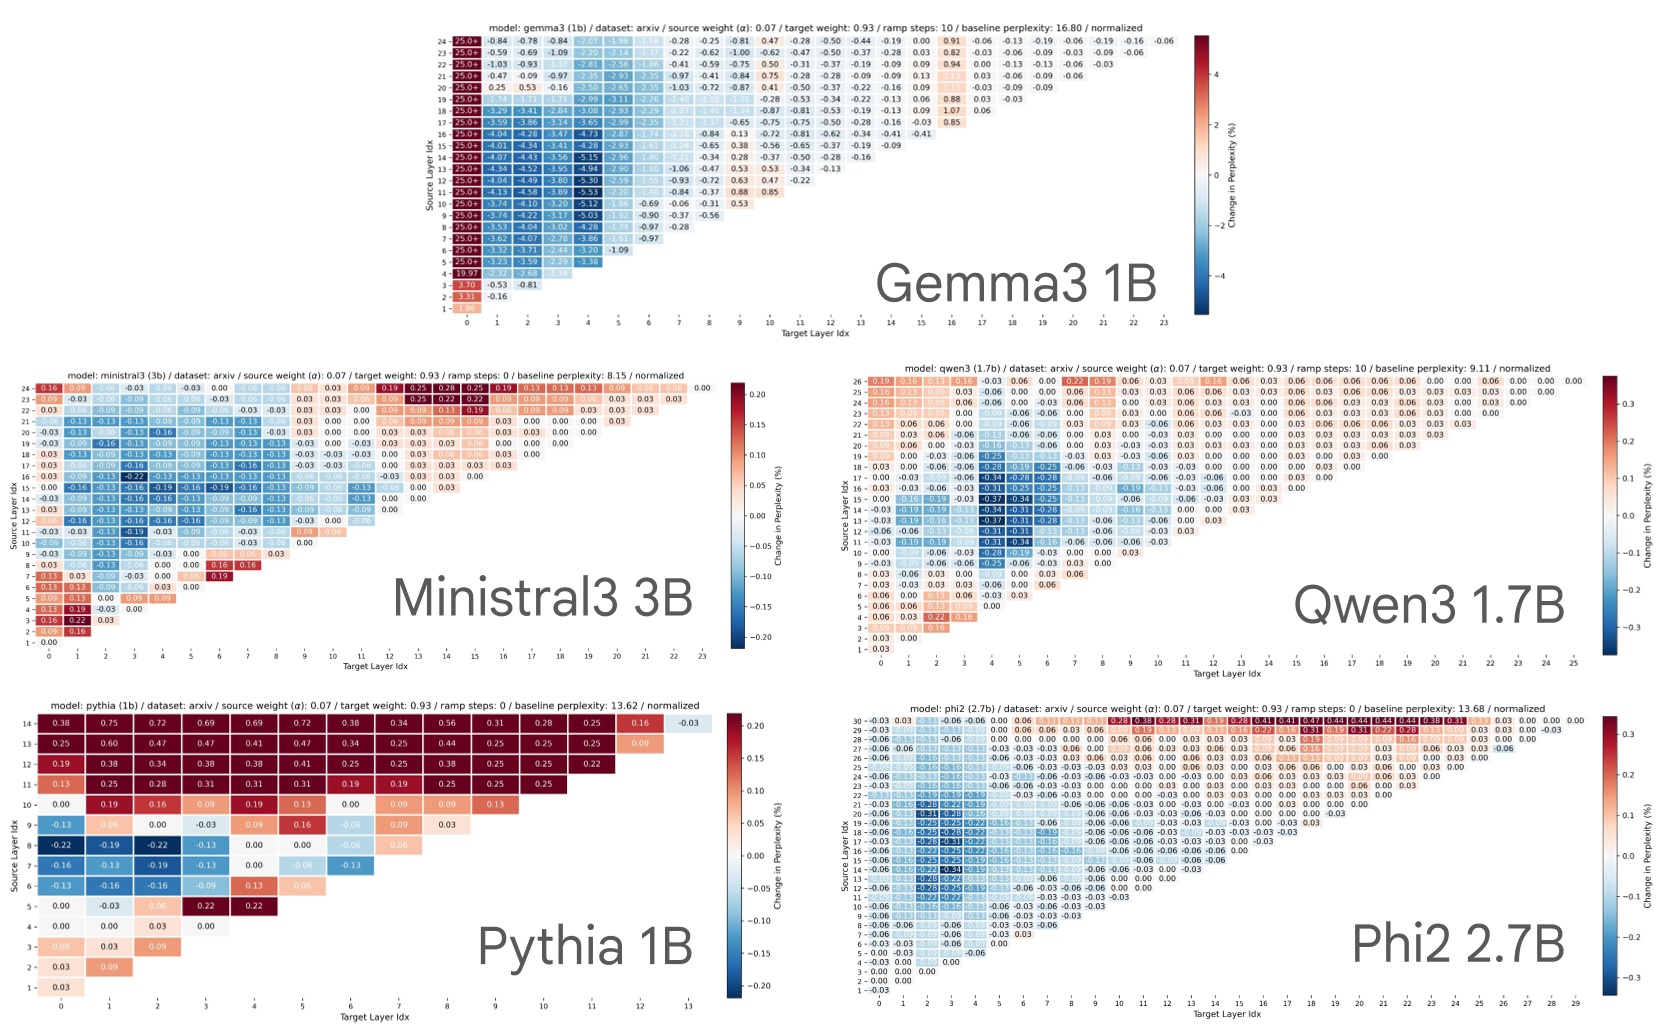 图 7:Ministral 3、Pythia、Qwen 3、Phi 2 与 Gemma 3 的层对扫描均呈现高度一致的“中部回流增益区”。
实验表明:
- 最优拓扑位置:在所有模型中,将网络**中深层(约 2/3 深度处)作为源层,回流至前中层(约 1/4 至 1/3 深度处)**能够稳定取得最大增益。
- 泛化性验证:Gemma 3 1B、4B、12B 的最优层对分别为 、 和 。
4.2 语言建模困惑度(Perplexity)量化评估
在覆盖学术论文、小说、代码及网页文本的 10 个数据集上,Recirculation 均展现出卓越且一致的压制效果:
| 数据集 | Token 量 | Gemma 3 1B 基线 PPL | Recirc. PPL (降幅) | Gemma 3 4B 基线 PPL | Recirc. PPL (降幅) | Gemma 3 12B 基线 PPL | Recirc. PPL (降幅) |
|---|---|---|---|---|---|---|---|
| arXiv | 51M | 19.10 | 16.54 (-13.99%) | 14.76 | 13.10 (-11.26%) | 33.93 | 25.38 (-25.20%) |
| PG-19 | 10.8M | 22.27 | 19.06 (-14.41%) | 19.49 | 16.43 (-15.72%) | 52.86 | 34.15 (-35.40%) |
| BookSum | 7.7M | 32.48 | 27.30 (-15.95%) | 29.09 | 24.45 (-15.95%) | 77.02 | 51.67 (-32.91%) |
| GovReport | 3.4M | 11.86 | 11.00 (-7.26%) | 10.79 | 9.78 (-9.37%) | 27.59 | 19.11 (-30.74%) |
此外,当引入轻量 MLP 调优的 Adaptive Recirculation 后,在 9 个基准上的平均 PPL 降幅跃升至 23.0%,其表现甚至超越了直接对 Gemma 3 1B 进行全参数重训练(21.6%)。
4.3 复杂推理与下游任务突破
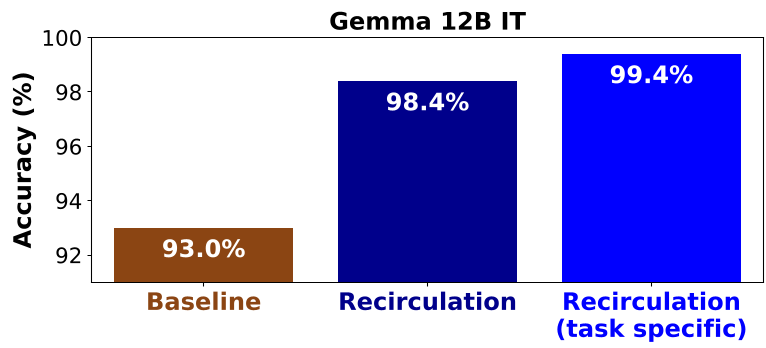 图 10:Gemma 3 4B 与 12B 在长程复杂指令遵循任务中的表现对比,Recirculation 使得错误率大幅削减 25% 至 75%。
- GSM8k 数学推理:在多步数学推理任务中,自适应再循环在 Gemma 3 4B 上实现了 pass@1 错误率下降 8.8%、pass@128 错误率下降 20.9% 的巨大飞跃。这证明了跨步隐空间状态对维持长链条 CoT 推理的动态一致性具有关键价值。
- 抗干扰消歧能力(Racing Thoughts 基准):面对插入大量无关干扰句的情境,带 Recirculation 的模型能够准确锁定前序指代,消除歧义错误率达 60% 以上。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
5.1 为什么 Recirculation 是非平凡的?(消融分析)
研究团队通过严格的对比实验排除了以下平庸假设:
- 排除了温度调节伪影(Temperature Artifact):实验证明,通过全局 Softmax 温度调优获得的收益与 Recirculation 是严格正交且可叠加的(叠加后 PPL 下降达 19.55%)。
- 词性敏感性(PoS Analysis):回流增益主要由动词、形容词和副词等富含上下文动态状态的语义词驱动,而对于代词、限定词等闭集功能词几乎不产生增益,证明其行为符合真实的信念动力学特征。
5.2 局限性与权衡 (Limitations)
- Prefill 阶段的串行开销:在自回归生成(Decode)阶段,现代硬件执行双栈并行的额外时延几乎为 0;但在处理超长 Prompt 的预填充阶段,Recirculation 强制打破了注意力全并行计算,转为串行/分块处理,导致长上下文 Prefill 耗时上升。
- 架构归一化敏感度:该方法在采用 Peri-LN(如 Gemma 系列,在层输入与输出端均施加 Norm)的模型上效果尤为突出,而在仅使用 Pre-LN 的老旧架构上增益相对收敛。
5.3 行业启示:倾听模型自带的“设计可供性”
Recirculation 提供了一种极具启发性的学术视角:未来的架构演进或许不必依赖从零开始的人工试错设计与昂贵重训。 通过在预训练模型的连续隐空间中探索其固有的动力学流动倾向,我们能够以近乎零成本的推理期干预(或外挂微型控制器),赋予静态前馈大模型以生命般的连续状态追踪能力。