
让特权教师跟着学生一起进化:递归自蒸馏与简洁精炼推理
Recursive Self-Improvement via On-Policy Distillation for Reasoning
本文针对 On-Policy Self-Distillation 中特权教师被冻结导致监督信号与策略漂移脱节的问题,提出 Recursive Self-Improvement via On-Policy Distillation 框架,由 Dynamic Co-Evolution 与 Self-Refined Concise Learning 两部分组成。DCE 让 gold-conditioned privileged teacher 随学生每一轮同步刷新,SRCL 用更短且通过验证的自改写控制推理冗余。在 Qwen3-8B 的四项数学竞赛基准上,DCE 加 SRCL 达到 65.97% Average@12,相比 OPSD 的 30.35% 提升 35.62 个百分点。
TL;DR
这篇论文的核心贡献是发现并修复 On-Policy Self-Distillation 中的一个结构性问题:冻结 gold-conditioned privileged teacher 会让监督信号在训练后期跟不上学生已经学会的反思、纠错和回溯行为。作者提出的 Dynamic Co-Evolution 把每一轮更新后的模型同时作为下一轮学生和特权教师,使修订能力可以递归进入监督源;Self-Refined Concise Learning 则用更短且通过验证的自改写控制 token 成本。主结果显示,Qwen3-8B 的 DCE+SRCL 在四个竞赛数学基准上达到 65.97% Average@12,相比 OPSD 的 30.35% 提升 35.62 个百分点,并把平均输出长度从 DCE 的 19,046 token 降到 17,561。
背景定位
这篇工作属于典型的方法改进型论文,其直接对手是 Zhao et al. (2026) 提出的 On-Policy Self-Distillation,简称 OPSD。OPSD 的卖点是无需外部教师:同一个 base checkpoint 分裂成两个角色,学生只看 problem,特权教师额外看到 verified solution,并在学生自己生成的前缀上给出 next-token 监督。为了稳定性,OPSD 将特权教师冻结在 θ0。论文的贡献不是简单把蒸馏换成了 RL,也不是又加一个 verifier,而是指出冻结教师会在“学生越会反思、教师越不会指导反思”时失效,并把监督源变成随学生共同进化的递归对象。与此同时,SRCL 与 test-time scaling 和长度惩罚路线保持距离,而是通过模型自己的短改写构造 token-level supervised target。
问题与动机
推理后训练长期存在监督粒度困境。RLVR 用最终答案的正确性给整条回答打分,能激励中间验证、回溯和纠错,但它只指出最终是否对,不指出错误在哪一步、应该怎么改。Process supervision 能给出更局部反馈,却依赖 step-level annotation 或单独训练的 verifier。On-Policy Distillation 试图处在两者之间:在 student 自己采样出来的 trajectory 上,由 teacher 对每个 prefix 给出 next-token distribution,从而把外部知识压成 token-level target。
OPSD 去掉外部教师,让 frozen privileged teacher 在同一个 student trajectory 上给出 gold-conditioned prediction。问题在于,post-training 会改变 student 的行为分布。论文在 AIME 2024、AIME 2025 和 AIME 2026 的固定错误 trajectory 上做 matched-prefix probe,发现冻结教师对错误回答末端 EOS 的平均概率高达 94.5%,但对实际观察到的反思 token Wait 的概率只有 22.0%。这说明教师即使看了 gold solution,仍然把大量错误回答的合理延续判断为“结束”,而不是“回到中间步骤继续修正”。
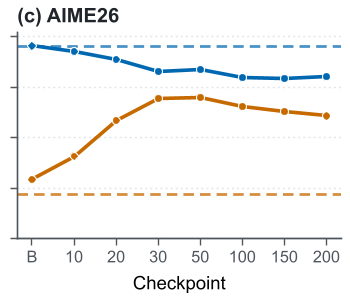
因此,冻结特权教师造成的不是普通意义上的教师太弱,而是监督分布与 student 行为分布之间的递归错位。student 在训练中变得更能反思,teacher 却还停留在初始 checkpoint 的偏好上。作者由此提出让 teacher 和 student 每一轮同步刷新,使第一轮学到的修订行为可以成为第二轮监督的组成部分。
核心章节:从冻结教师到递归共同进化
基线 OPSD 的形式与冻结假设
标准 OPSD 的目标可以写成:
其中 x 是题目,g 是 verified solution,y 是 student 生成的回答,y<t 是生成到第 t 步之前的前缀,τ 是 transition instruction,C_t^ref 是把题目、参考答案、过渡指令和当前前缀拼接起来的 privileged context。θ0 是初始 checkpoint,也是始终冻结的 privileged teacher;θ 是正在更新的 student。这个式子承担的是“把特权信息压进普通推理”的角色:teacher 看到 g 和当前 prefix,student 只看到题目和 prefix,优化让 student 的 token-level prediction 靠近 teacher。若把 Δ 换成 Forward KL,式子强调 teacher 支持的 correction mode;但论文的关键缺陷不在损失函数本身,而在 teacher 参数固定为 θ0。随着 student 越来越会在错误前缀中反思,frozen teacher 仍然按照初始模型的 EOS 偏好打分,监督信号就会越来越不匹配 student 自己真正需要的错误修正。
DCE:让特权教师吸收学生学到的修订能力
论文提出的 Dynamic Co-Evolution 首先在第 k 轮用当前模型 θk 生成 on-policy rollout:
其中 y^(k) 是当前学生自己采样出来的完整回答,不是离线示范,也不是教师生成文本。这个式子在论证链里的作用是确保监督发生在 student 的分布上:teacher 的 next-token guidance 必须针对 student 当前会遇到的错误前缀,而不是只针对训练数据中的标准解法。如果把它换成 off-policy teacher 生成文本,就变成了传统蒸馏,无法保证 student 在错误前缀上获得纠正式监督。
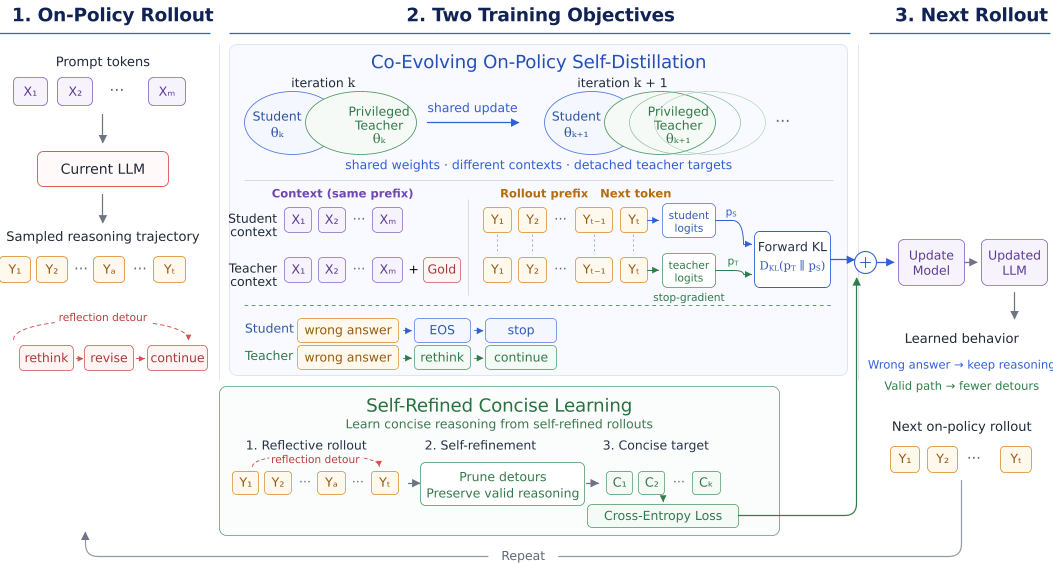
接着,论文在同一个前缀上构造 student 和 privileged teacher。student 分布为 p_k,t = p_θk(· | x, ỹ_<t^(k)),teacher 分布为 q_k,t,它由同一个 θk 产生,但额外接收 verified solution 并 stop-gradient。DCE 的指导损失为:
其中 ỹ^(k) 是从 y^(k) 中保留用于计算 guidance 的 m 个 token,Δ 在主实验中取 Forward KL,即 D_KL(q | p) = Σ_v q(v) log(q(v) / p(v))。q_k,t 是看到 gold solution 的 privileged teacher 预测,p_k,t 是只看题目的 student 预测,stopgrad 表示 teacher 分支不接收这一轮 student loss 的直接梯度。这个目标相对 OPSD 的本质改动不是把 KL 换个方向,而是让产生 q_k,t 的参数从 θ0 变成 θk。每一轮优化得到 θk+1,之后 θk+1 同时初始化为下一轮 student 和 privileged teacher。若仍然令 teacher 冻结为 θ0,DCE 就退化为 OPSD;论文 Figure 1 的 probe 和 Table 13 的冻结对照都说明,这种退化会导致监督信号滞后于学生能力。
论文还把 privileged context 的放置作为设计选择。OPSD 的参考答案放在 user turn,作为外部 reference material;DCE 的主设置把 g 放进 assistant turn,让 teacher 把它当作先前模型生成推理的一部分。Table 5 显示,assistant-side prefill 相比 user-side instruction-last 在 Qwen3-8B 上平均准确率高 9.79 个百分点,在 Qwen3-4B 高 6.39 个百分点,在 Qwen3-1.7B 高 14.66 个百分点。这个证据给出的直觉是:gold solution 放在“模型自己已经说过”的上下文中,更像是在初始化一条修正路径;Table 17 进一步显示 assistant-side 的最强影响集中在 Y0 开头附近,说明它主要改变路线选择,而不是均匀修改所有 token。论文未给出严格因果实验来隔离 prompt position,因为不同 placement 是分别训练出来的模型,因此这个证据应理解为设计对照而非单变量因果。
SRCL 与联合目标:控制修订带来的 token 成本
DCE 强化修订能力后,会产生一个新问题:模型更频繁地检查、回溯和自我批判,回答可能保留有效推理但加入大量冗余。SRCL 的回应是让当前 checkpoint 重写自己的 on-policy response,生成不带 gold solution 的短改写:
其中 R_θk 表示 refinement prompt,目标是把完整 rollout 改写成直接、自包含、去除不必要绕路的答案推导;c_i^(k) 是候选短改写。这个式子的作用是让模型学习“保留有效推导、删除低价值反思”的行为分布。它不是测试时 truncation,也不是简单终止惩罚,而是在训练时构造新的 supervised target。若没有 verified answer 过滤器,模型可能学到短而错的回答;若把 gold solution 放入改写 prompt,则会把参考答案泄漏进学生行为,削弱其作为自改写目标的训练意义。
SRCL 的损失只在通过验证的短改写上计算:
其中 A_i^(k) 是 indicator,表示第 i 个改写是否通过更短、自然终止、结构有效和答案正确四道门槛;N_k 是 minibatch 内所有接受改写的总 token 数。论文 Section M 显示,在 Qwen3-8B DCE+SRCL 运行的 3,200 个候选改写中,2,296 个被接受,接受率为 71.75%,接受目标平均比源 rollout 短 83.74%。如果 N_k = 0,则该 mini-batch 不计算 SRCL loss,仅用 DCE 更新。这个边界很重要:SRCL 不是单独可稳定的目标,消融显示 DCE 被移除时,SRCL alone 在 Qwen3-8B 上最高只有 2.36% accuracy with 1,116 tokens,在 Qwen3-4B 上只有 0.76% with 531 tokens。因此 SRCL 的作用更像是给 DCE 的修订能力加上“简洁但正确”的行为约束。
两个目标通过加权求和联合优化:
其中 λ_G 控制 privileged guidance 的强度,λ_S 控制短改写 supervised target 的强度。论文 Table 3 显示,主设置 λ_G = 5 × 10^4 给出 65.97% average accuracy 和 17,561 tokens,而 λ_G 从 1 × 10^4 到 1 × 10^5 的 sweep 中平均 accuracy 只在 63.96% 到 65.97% 间变化;λ_S sweep 从 12.5 到 500 跨度很大,但多数结果仍在主设置约 2.57 个百分点内。这说明两个目标存在互补的宽操作区,但不是单调的 scale-independent optimum。若 λ_S 过大,简洁目标可能压过修订指导;若去掉 DCE,SRCL 单独会退化成短而错误的回答分布。
实验与证据
Table 1 汇总了 Qwen3-8B、Qwen3-4B 和 Qwen3-1.7B 在四个数学基准上的平均表现:
| 方法 | Qwen3-8B 平均准确率 | Qwen3-8B 平均 token | Qwen3-4B 平均准确率 | Qwen3-4B 平均 token | Qwen3-1.7B 平均准确率 | Qwen3-1.7B 平均 token |
|---|---|---|---|---|---|---|
| Base | 19.51 | 3,922 | 17.57 | 3,805 | 9.17 | 3,085 |
| SFT | 20.00 | 4,088 | 18.68 | 3,718 | 10.14 | 3,177 |
| GRPO | 20.28 | 3,705 | 18.47 | 3,363 | 10.90 | 3,053 |
| OPSD | 30.35 | 6,009 | 22.85 | 8,350 | 10.35 | 5,380 |
| OPSD-TTS | 30.76 | 16,384 | 22.99 | 16,384 | 9.24 | 16,384 |
| DCE | 65.76 | 19,046 | 60.00 | 19,360 | 23.33 | 12,600 |
| DCE+SRCL | 65.97 | 17,561 | 61.88 | 17,265 | 26.88 | 19,504 |
这张表把三个结论放在一起。首先,DCE 是主要增益来源:Qwen3-8B 上 DCE 已经从 OPSD 的 30.35% 提升到 65.76%,Qwen3-4B 从 22.85% 到 60.00%。其次,SRCL 在较大规模上改善准确率与长度权衡:8B 上 accuracy 从 65.76% 到 65.97%,平均 token 从 19,046 降到 17,561;4B 上 accuracy 从 60.00% 到 61.88%,平均 token 从 19,360 降到 17,265。第三,1.7B 并不稳定,SRCL 将 accuracy 从 23.33% 提到 26.88%,但平均 token 从 12,600 增到 19,504,且 Table 19 显示后续 checkpoint 会塌缩到极低准确率,说明小规模需要更早停止或更强控制。
教师刷新机制是论文最关键的拆解性证据。Table 13 显示,在 Qwen3-8B 上 frozen privileged teacher 的 DCE+SRCL 只有 41.04% average accuracy 和 8,723 tokens,而每轮同步 dynamic teacher 达到 65.97% 与 17,561 tokens。EMA teacher 的 d = 0.3 达到 65.35%,d = 0.7 达到 65.00%,periodic snapshots 最高为 63.47%,但仍低于 dynamic θk。Qwen3-4B 上 frozen teacher 的 DCE+SRCL 为 27.29%,dynamic teacher 为 61.88%。这些数字支持论文的核心论点:不是 teacher 看到 gold solution 就足够,而是 teacher 必须把 student 已经学会的修订能力纳入监督分布。
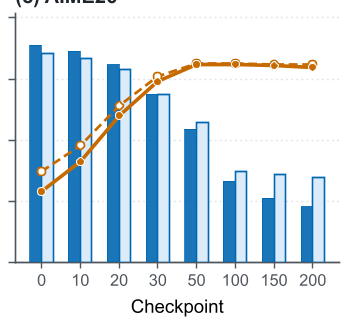
固定错误轨迹 probe 给出了行为层面的解释。论文 Figure 4 显示,在三个 AIME cohort 上宏平均后,teacher endpoint EOS probability 从 90.4% 降到 41.3%,student 从 92.6% 降到 26.3%;teacher 对观察到的 reflection token 的概率从 32.8% 升到 77.4%,student 从 30.1% 升到 77.0%。这说明 recursive training 不只改变 policy,也改变 supervised signal 本身:更新后的 teacher 更少在错误答案末尾选择 EOS,更可能在需要反思的位置支持 Wait 类 cue。
蒸馏方向同样不是无关细节。论文第 5.5 节对照表显示,Qwen3-8B 上 Forward KL 达到 65.97% accuracy 和 17,561 tokens;Reverse KL 降到 60.42% 但需要 23,748 tokens;JSD 只有 17.99% 且仅 3,767 tokens。这组数字符合 Forward KL 的 mode-covering 直觉:teacher 支持但 student 低估的 correction mode 会被强调,而 Reverse KL 更偏向 student 已有 mode,可能错过 privileged teacher 提出的纠错路径。JSD 的对称、有界性质则进一步削弱了从 teacher 到 student 的方向性指导。
Table 6 报告了 Qwen3-8B 在 8K 和 16K 预算下的 matched-budget 控制:
| 方法 | 预算 | 平均准确率 | 平均 token |
|---|---|---|---|
| OPSD Standard | 8K | 29.17 | 4,252 |
| OPSD TTS | 8K | 28.47 | 8,192 |
| DCE+SRCL Cue | 8K | 35.07 | 7,500 |
| OPSD Standard | 16K | 30.28 | 5,109 |
| OPSD TTS | 16K | 30.76 | 16,384 |
| DCE+SRCL Cue | 16K | 57.64 | 12,407 |
这张表直接反驳了“提升只是更长输出”的解释。在 8K 预算下,OPSD-TTS 把 OPSD Standard 的 29.17% 降到 28.47%,却把平均长度从 4,252 推到 8,192;同预算下 DCE+SRCL Cue 达到 35.07% 且只用 7,500 tokens。16K 预算下,OPSD-TTS 相比 OPSD Standard 只从 30.28% 增到 30.76%,而 DCE+SRCL Cue 达到 57.64%,平均 token 为 12,407。也就是说,强制延长回答不会自动产生纠错能力,DCE 学到的修订行为在更紧预算下仍然有效。
跨模型家族方面,Table 2 显示 Gemma-4-12B-IT 上 DCE 达到 62.01%,DCE+SRCL 达到 63.61%,均高于 OPSD 的 51.04%、GRPO 的 55.63% 和 SFT 的 55.14%。Table 8 进一步显示 Qwen3-14B 从 base 的 21.39% 上升到 step 30 的 66.39%,但 step 50 虽然仍有 65.21%,平均 token 从 15,877 增到 20,050。这提示递归改进不是只在 8B 成立,但训练步数、早停和长度控制仍是实践边界。
深度洞察与总结
论文的真正机制贡献是把 privileged self-distillation 从“固定教师监督流动学生”改成“教师和学生互相塑造监督分布”。Dynamic Co-Evolution 让每一轮 checkpoint 同时成为下一轮 student 和 privileged teacher,因此 student 学到的错误识别、回溯和修正能力能够反过来增强教师的 token-level guidance。Self-Refined Concise Learning 则把修订能力约束到更短且正确的自改写分布上,避免反思行为膨胀成无终止的自我审查。两者结合后,主要增益来自 DCE,SRCL 负责改善 accuracy-length frontier。
从证据质量看,DCE 的主结论在 Qwen3-8B、Qwen3-4B、Qwen3-1.7B 和 Gemma-4-12B-IT 上都比较稳。Table 1、Table 2 和 Table 8 显示跨规模和跨家族都能超过 OPSD、SFT 和 GRPO;Table 13、Table 16 和 probe results 又把增益归因到教师刷新、assistant-side prefill 和 reflection/EOS 概率变化。不过,论文的证据主要来自四个 30-problem competition math benchmarks,每个问题采样 12 次,样本量小且领域窄。Table L 中的 MATH-500、GPQA-D 和 AMC23 显示方法能泛化到额外基准,但在这些更广任务上 DCE+SRCL 往往伴随更长输出,例如 Qwen3-8B 的 AMC23 从 OPSD 的 78.54% 与 2,633 tokens 变为 95.42% 与 7,604 tokens。这说明 concision gain 并不自动跨任务成立。
局限性也具体可检验。第一,λ_S 并非统一:Table 24 显示 14B、8B、4B、1.7B 分别使用 12.5、25、35、25,说明简洁性目标对不同模型规模敏感,论文未系统证明自动选择策略。第二,小规模稳定性不足:Table 19 显示 Qwen3-1.7B DCE 在 step 100 只有 1.53% accuracy 与 30,241 tokens,DCE+SRCL 在 step 200 也只有 1.53% accuracy 与 32,005 tokens,因此 early stopping 在这个规模上是必需而非可选。第三,privileged solution placement 的证据来自 separately trained models,而不是同一个模型上的严格 intervention,Table 17 和 Table 18 能说明训练动态差异,但不足以完全隔离 prompt position 的因果作用。第四,方法仍保留很高 token cost,Qwen3-8B 主结果平均 17,561 tokens,即使经过 SRCL 也远高于 Base 的 3,922;如果工程目标是短答案场景,这种长度仍需要额外 budget-aware training。
未来更值得推进的方向不是简单把方法搬到更多任务,而是把递归监督、验证器选择和预算控制放进同一目标。一个具体判断是:可以把 DCE 的 dynamic teacher 更新从每轮同步改成 error-driven refresh,只在 fixed-trace probe 显示 EOS 概率回升或 reflection probability 下降时触发刷新;也可以把 SRCL 的 acceptance rule 从更短且答案正确扩展为多目标约束,例如加入 latency-aware reward 或 verifier uncertainty weighting。论文已经证明,自蒸馏的瓶颈不仅是有没有 teacher,而是 teacher 是否能和学生一起进化。