
[实证研究] RFT 真的能让大模型智能体举一反三吗?深度解析 LLM Agent 强化微调的泛化之谜
Does Reinforcement Fine-Tuning Improve Generalization of LLM Agents? An Empirical Study
本文对多轮决策场景下大语言模型(LLM)智能体的强化学习微调(RFT)泛化性进行了系统性实证研究。通过在五个代表性环境(如 WebShop, AlfWorld 等)上的大规模实验,揭示了 RFT 在同环境下跨难度任务、跨环境迁移以及连续学习中的泛化表现与失效模式。
TL;DR
强化学习微调(RFT)已成为提升 LLM 智能体(Agent)多轮决策能力的利器。然而,本论文通过系统实验泼了一盆冷水:虽然 RFT 在同一环境内“学得很快、很深”,但在面对完全陌生的环境(观测空间和动作接口改变)时,智能体往往会陷入严重的“经验主义”错误,甚至产生负迁移。
背景定位
在 LLM 的学术坐标系中,这篇论文填补了智能体事后训练(Post-training)泛化性评估的空白。它不只是刷榜 SOTA,而是作为一名“严谨的质检员”,利用类似 DeepSeek 的 GRPO 算法,对智能体在任务难度、环境迁移和连续学习三个维度进行了深度扫描。
1. 痛点:被禁锢在“温室”里的智能体
目前的 LLM 智能体研究大多遵循“在 WebShop 训练,在 WebShop 测试”的逻辑。但这忽略了真实场景的复杂性:
- 背景知识漂移:从购物网站切换到家庭机器人。
- 接口突变:一个环境需要输入
search[],另一个环境则需要go to。 - 认知过拟合:智能体在某些提供“可用动作列表”的环境(如 BabyAI)中训练久了,会丧失在复杂环境下自主 Reasoning 的能力。
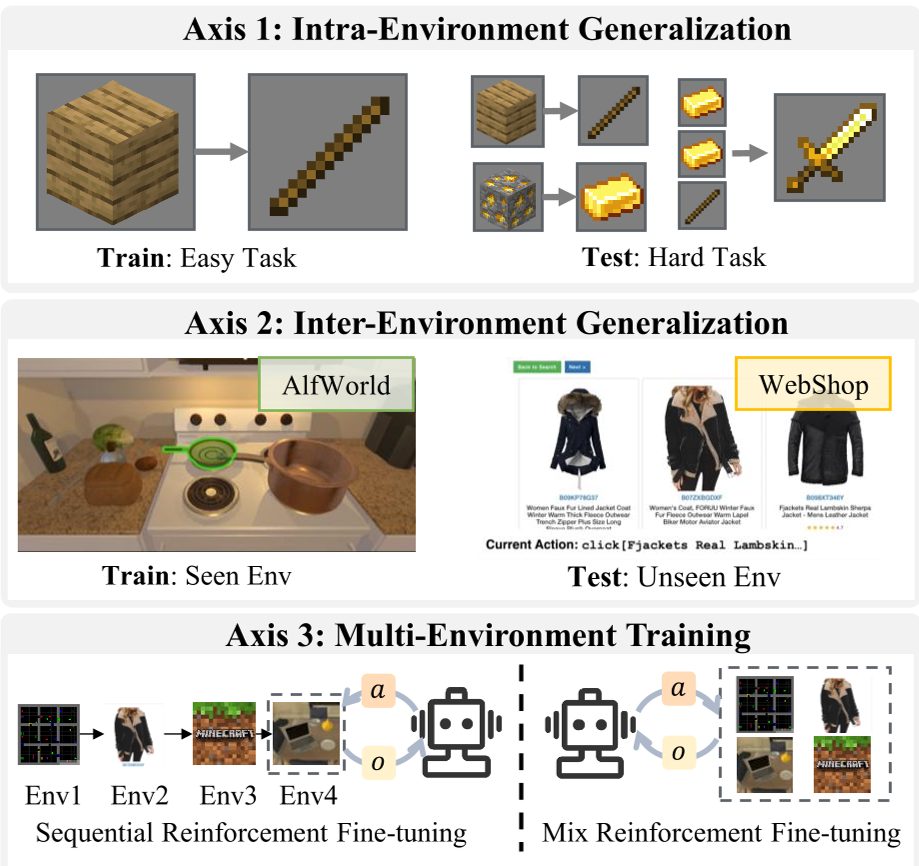
2. 方法论:三轴评估框架
研究者采用了 Qwen2.5-3B/7B-Instruct 作为基座,通过 AgentGym-RL 框架进行 RFT。
核心机制:GRPO 与 课程学习
论文采用了 GRPO(Group Relative Policy Optimization) 算法,通过组内相对优势估计基准,避免了 PPO 繁重的 Critic 网络,极大提升了训练效率。
- 物理直觉:通过“易 -> 难”的课程学习(Ueasy -> Uhard),智能体先掌握环境语法,再攻克长程逻辑,比直接混合训练效果更佳。
3. 实验发现:泛化性的“红与黑”
同环境:超强的“自我进化”
在同一环境下,RFT 表现完美。智能体不仅学会了如何成功,还学会了如何更高效。
- 实验数据:在 BabyAI 中,平均交互轮数从 10.76 暴降至 4.19。
- 结论:RFT 强制模型舍弃废话,进行目标导向的极简路径探索。
跨环境:敏感的“动作先验”
这是最令人深思的部分。如表 3 所示,跨环境迁移(Held-out)的平均增益远低于域内(Held-in)。
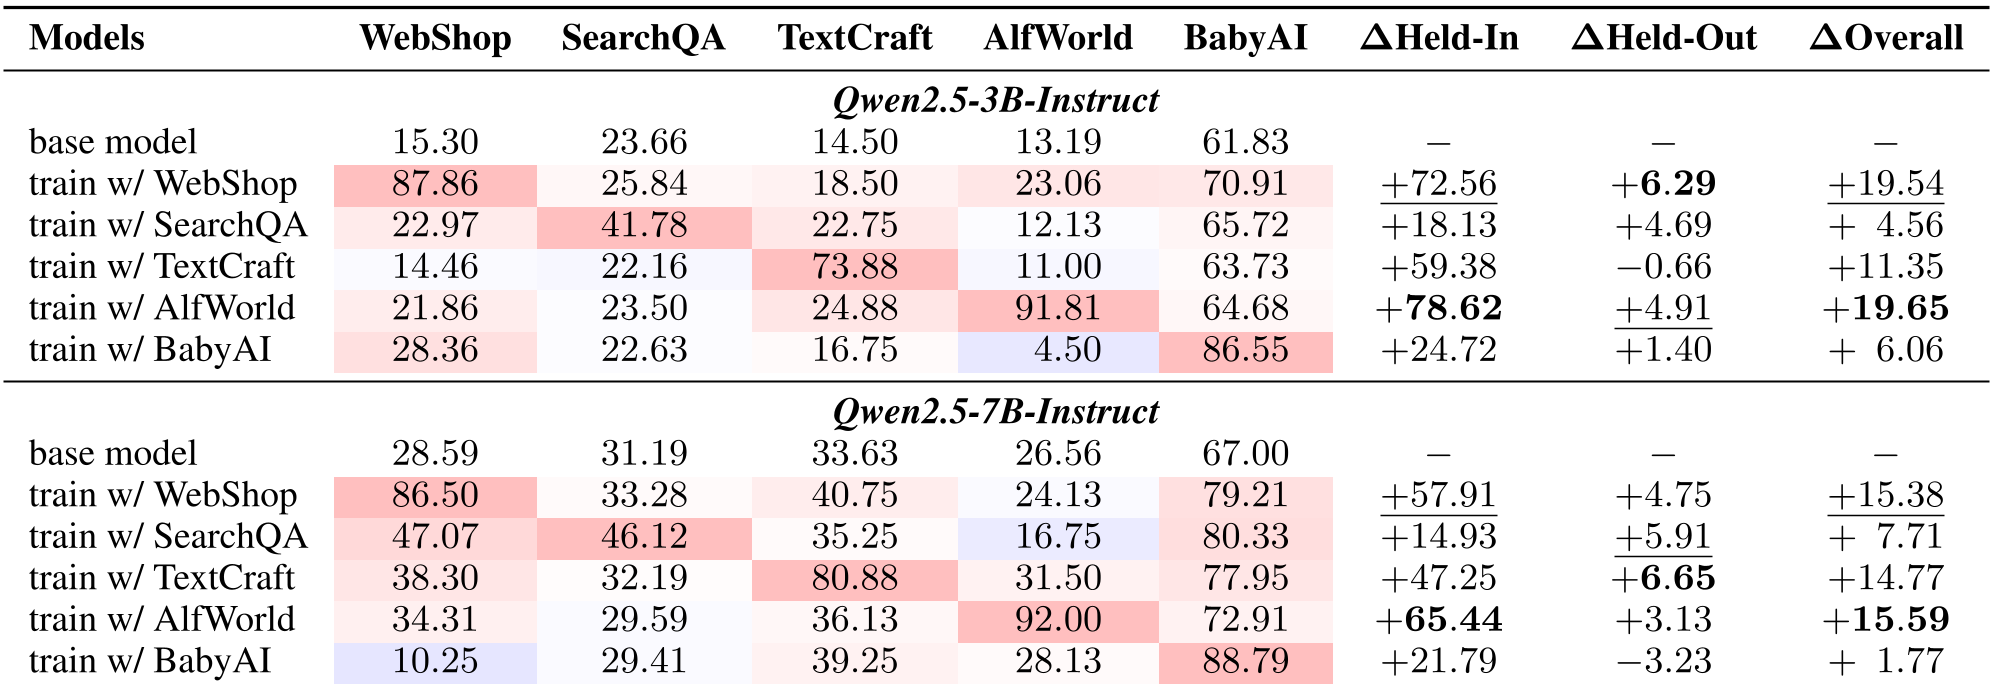
- 负增长警告:在 BabyAI(强反馈环境)训练后的模型,去打 WebShop(弱反馈)时,性能大幅缩水。原因是它习惯了环境“喂饭式”的动作提示,丧失了在 HTML 中提取关键信息的能力。
- 成功案例:从 SearchQA 迁移到 WebShop 表现良好,因为两者都需要“搜索-提取”的底层元能力。
连续学习:意想不到的抗遗忘
令人惊讶的是,智能体在连续学习五个环境时,遗忘现象并不显著。Sequential RFT 的最终表现竟然与所有数据混合(Joint Training)的效果旗鼓相当。
4. 深度洞察:为什么智能体会“变傻”?
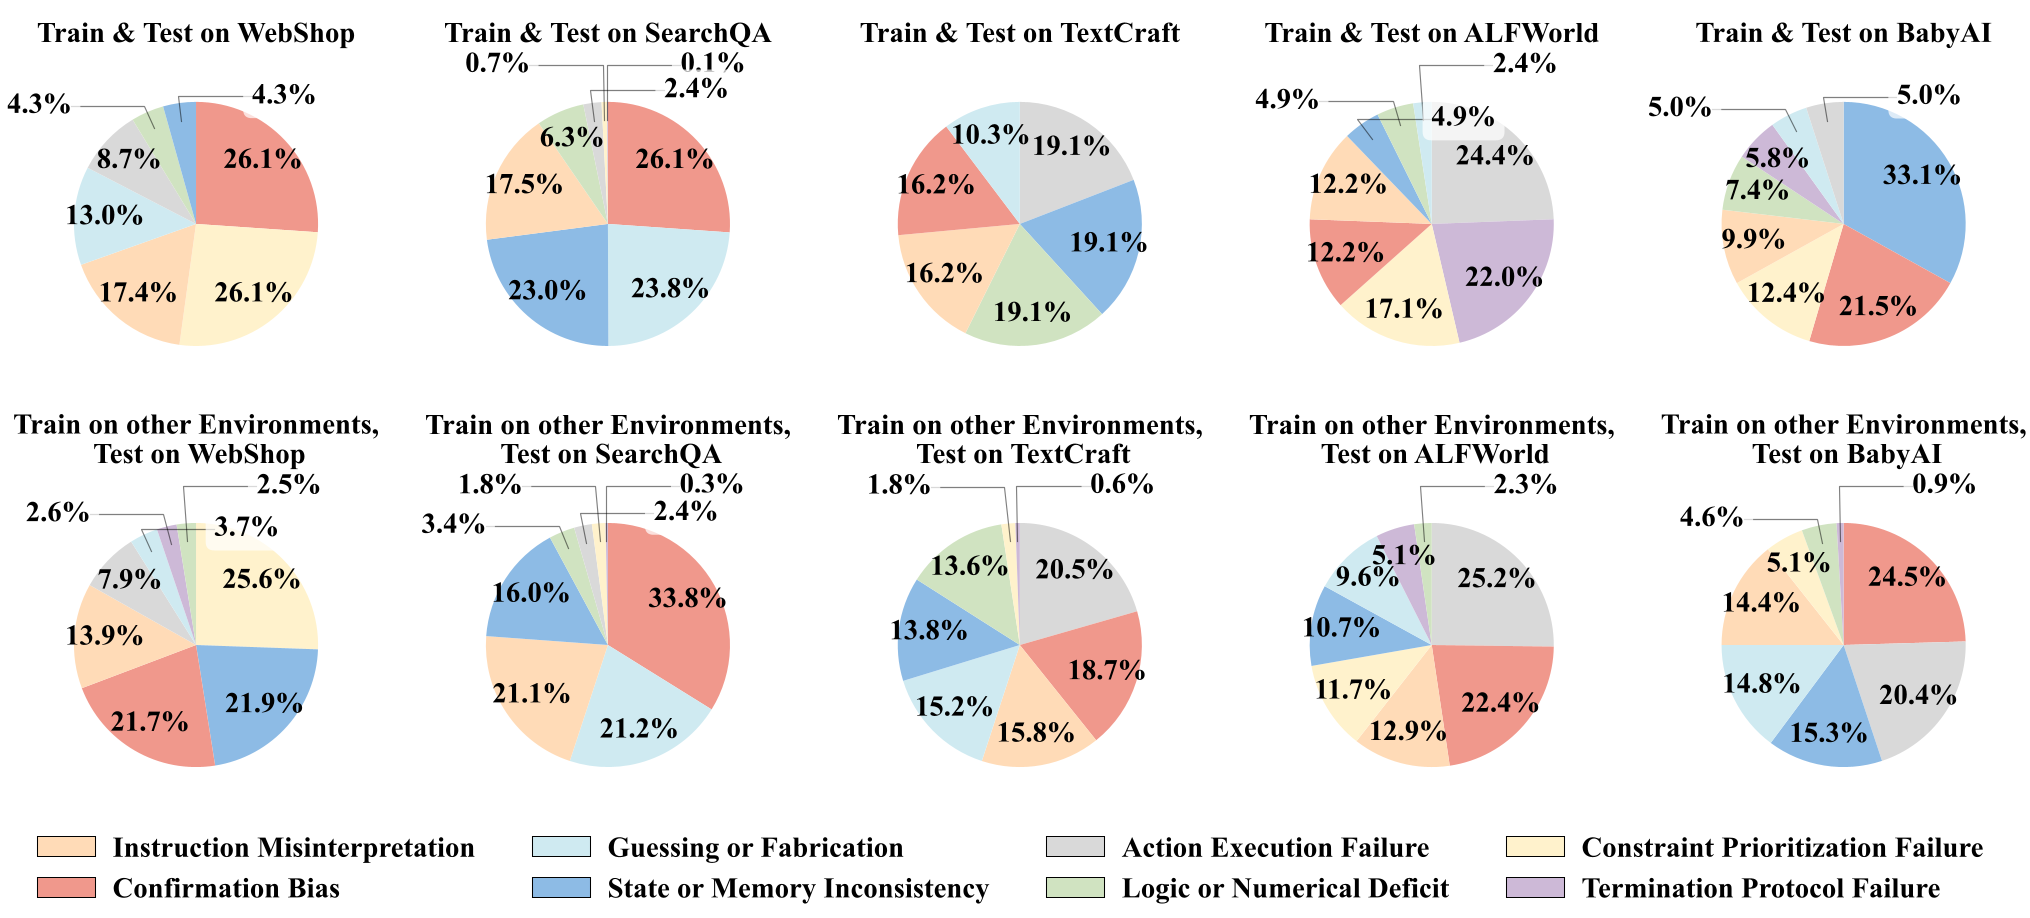
通过对失败案例的定性分析,作者总结了 8 种失败模式。其中最核心的是 “确认偏见”(Confirmation Bias)。
- 表现:经过 RFT 训练的智能体虽然变得果断,但往往“蜜汁自信”。一旦搜索失败,它不会反思是否关键词错了,而是在死胡同里原地打转(反复尝试相同的错误动作)。
5. 总结与未来展望
核心价值:
- 别盲信 In-domain 成绩:RFT 带来的可能是对特定环境接口的“过拟合”。
- 课程学习是王道:先易后难不仅收敛快,通用性也更好。
- 安全隐患:由于 RFT 有很强的记忆保留能力,如果上游训练中存在“后门”或不安全行为,在后续微调中也很难被洗掉。
局限性:当前仅验证了 Qwen 系列和 GRPO 算法,且由于算力限制没能穷举所有训练顺序。未来的智能体需要更强的“自我纠错”机制,而不是单纯的路径依赖。