
[Future Internet 2025] 强化学习驱动的动态模糊 UI:让教育软件真正“懂”学生的节奏
Reinforcement Learning-Based Dynamic Fuzzy Weight Adjustment for Adaptive User Interfaces in Educational Software
本文提出了一种基于强化学习(RL)动态调整模糊权重(Dynamic Fuzzy Weight Adjustment)的自适应用户界面系统,旨在优化 Java 编程教育软件的个性化体验。该系统通过模糊推理对学习者进行分类,并利用 Q-learning 算法自实时微调隶属度函数阈值,从而在 SOTA 级别上实现了对提示、难度和引导的精确干预。
TL;DR
本文介绍了一种结合**模糊逻辑 (Fuzzy Logic)与强化学习 (Reinforcement Learning)**的新型自适应 UI 系统。它不仅仅是简单地根据分数换题目,而是像一位经验丰富的教练,通过 RL 实时调整模糊边界,精准判断何时该给提示、何时该增加难度。实验数据表明,这套系统让编程学习者的独立成功率提升了近 30%。
1. 痛点:死板的规则 vs. 灵活的头脑
在开发 Intelligent Tutoring Systems (ITS) 时,研究者常面临一个悖论:规则太死,则自适应不足;规则太松,则系统不稳定。
传统的模糊控制器虽然能处理“学生进度较慢”这种模糊信息,但其背后的数学阈值(如完成时间超过 10 分钟判为慢速)通常是专家预设的静态值 (Static Thresholds)。然而,学习者的状态是波动的,同一名学生在学习循环结构和递归算法时的表现截然不同。静态规则无法应对这种高维度的动态变化。
2. 核心架构:模糊推理与 RL 的“双剑合璧”
作者提出了一种两层架构,试图让系统具备“进化”能力:
2.1 模糊推理模块 (FIM)
系统根据学生在 Java 练习上花费的时间 ,利用三角形隶属度函数 (Triangular Membership Functions) 将其映射到 Fast, Moderate, Slow 三个维度。
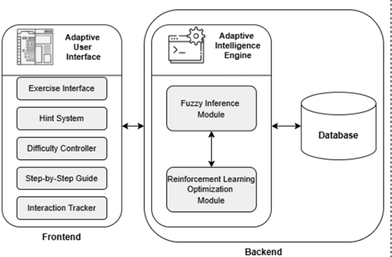 图 1:模糊推理与 RL 优化模块协同工作的系统架构
2.2 强化学习优化模块 (RLOM) —— 系统的“大脑”
这是本文的最核心贡献。作者将三个关键阈值 作为 RL 代理的操作对象。
- 状态空间 (State):当前的练习时间及三个阈值。
- 动作空间 (Action):对阈值进行步长为 或 的微调。
- 奖励函数 (Reward):这是一个精妙的设计,公式如下: 它同时奖励效率的提升(完成时间缩短),惩罚剧烈的阈值波动,并引入提示惩罚项 (),以防止系统因过度提供提示而导致学生产生“AI 依赖”。
3. 实验见证:慢速学习者的福音
研究团队在 Java 编程课程中进行了为期六周的测试。结果揭示了一个深刻的洞察:动态 UI 调整对越困难的学习任务、越慢的学习者,其增益越高。
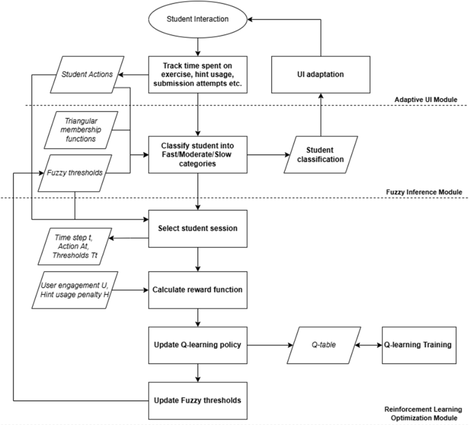 图 2:系统运行流程:从学生交互到 RL 权重更新的闭环
关键实验数据:
- 学习效率:慢速学习者的练习时间缩短了 15.5%。
- 准确率提升:错误率在 RL 介入后降低了 30.9%,这证明了精准的干预时机显著减少了学生的认知盲区。
- 自主性验证:提示请求数下降了 26.6%。这意味着系统通过动态调整,教会了学生如何通过自主思考而非依赖提示来解决问题。
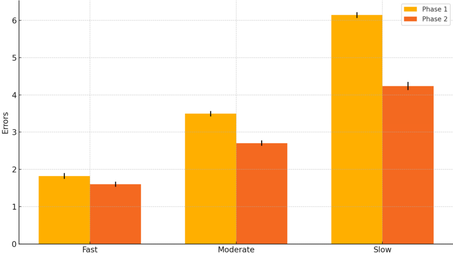 图 3:RL 优化前后错误率的显著下降对比
4. 资深主编点评 (Critical Analysis)
为什么这个方法奏效?
其本质在于解决了**“教育干预的介入边界问题”**。教育学中著名的“最近发展区 (ZPD)”理论指出,教学应略高于学生的当前水平。本文通过 RL 动态调节模糊权重,实际上是在数学层面上实时寻找每一位学生个体的 ZPD 动态边界。
局限性与改进空间
- 特征单一性:目前系统主要基于“时间”这一特征。在真实的编程学习中,编译错误类型、代码逻辑深度、甚至光标停留轨迹都是极具价值的特征。
- 泛化场景:Java 编程具有极强的逻辑结构,该方法在人文社科类非结构化学习任务中的表现仍待验证。
5. 总结 (Takeaway)
本文成功的核心在于:它不再试图编写一套完美的规则,而是编写了一套能够“优化规则”的元算法。对于未来 Adaptive UI 的设计者来说,如何让界面不仅仅是“漂亮”和“易用”,而是能通过强化学习具备“教学直觉”,将是下一个技术高地。
关键词:Fuzzy Logic, Reinforcement Learning, Adaptive UI, Java Education, Intelligent Tutoring Systems.