
[IJAIED 2025] 强化学习进军教育界:系统性综述揭示个性化教学的“进化论”
Reinforcement Learning in Education: A Systematic Literature Review
本文是一篇关于强化学习(RL)在教育领域应用的系统性文献综述(SLR)。通过对 2000 年至 2024 年间发表的 89 篇核心论文进行多维度分析,该研究总结了 RL 在教学序列优化和学习指导方面的最新进展、算法趋势及其实际教学效果。
TL;DR
强化学习(RL)正成为自适应教育系统的“大脑”。本研究通过对近 25 年 89 篇核心文献的深度拆解,发现 RL 在提升学生参与度和学习效率方面潜力巨大,但也揭示了一个残酷现实:我们往往过度依赖模拟器(Simulator),而忽视了真实课堂的复杂性。
背景定位:这是一篇典型的“坐标系”式综述,它不仅总结了 SOTA 战绩,更通过对基准线(Baselines)质量的批判性分析,为教育 AI 的工程落地提供了最佳实践指南。
痛点深挖:为何个性化教学这么难?
在传统的 Intelligent Tutoring Systems (ITS) 中,教学逻辑往往由人类专家手写,这被称为“专家策略”。然而:
- 状态空间爆炸:每个学生的知识背景、认知负荷和情感状态组合起来是无穷的,静态规则无法穷举。
- 延迟奖励问题:当系统给出一记“提示(Hint)”时,其对期末成绩的影响往往在数周后才显现,信用分配(Credit Assignment)极难。
- 黑盒困境:Deep RL 虽然效果亮眼,但其决策过程的不可解释性让教师难以放心交付。
核心方法论:教育 RL 的技术版图
作者将教育 RL 的应用归纳为两大核心任务:
- Instructional Sequencing(内容测序):决定下一个学习任务是什么,旨在优化学习路径(Content-related)。
- Pedagogical Guidance(教学指导):在学生做题时决定何时给提示、给什么反馈(Guidance-related)。
模型架构的多样性
论文展示了从经典 Tabular RL 到前沿 Deep RL 的演进过程。
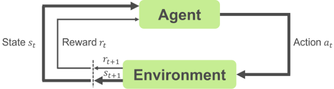 图 1: 强化学习 Agent 与教育环境(学生)的交互逻辑
研究发现,Model-free 方法(如 Q-learning, PPO)占据主流(n=72),因为建立一个准确的学生认知模型(Model-based)实在太难。
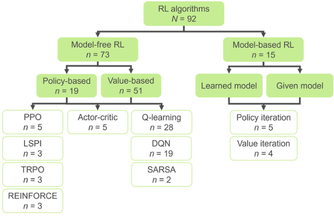 图 2: 教育场景中 RL 算法的分类图谱
实验与结果:RL 真的比人类老师强吗?
1. 战绩评估
在所有进行统计分析的研究中,51% 的 RL 策略击败了专家设计的策略或随机策略。
- Affective Variables(情感变量):RL 在提升学生动力(Motivation)方面表现最强(显著性达 63%)。
- Learning Gain(学习增益):使用“归一化学习增益(Normalized Learning Gain)”作为奖励函数的研究,更有可能获得显著提升。
2. 真实世界的冷思考
作者指出,约有一半的评估是在模拟器中完成的。虽然模拟评估效率高,但无法模拟学生在真实课堂中的“分心”或“挫败感”。
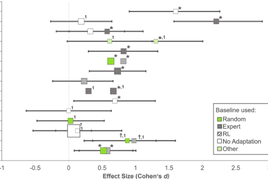 图 3: 不同研究中 RL 相对于基准线的效应量 (Cohen's d) 分布。可见大部分显著性研究集中在中、高效应量区间。
深度洞察:给开发者的 8 条“军规”
- 首选经典 RL:除非状态空间极其巨大且连续,否则经典 Q-learning 往往比复杂的 DRL 更稳定。
- 奖励函数秘籍:务必将“归一化学习增益”作为 Delayed Reward 的核心。
- 基准线警示:不要只对比随机策略,要对比非自适应的固定课程和人类专家策略,这才是 RL 的真实试金石。
- 关注“指导”而非“测序”:数据表明,RL 在提供即时 Hint 和 Feedback 上的成功率高于改变整个课程大纲。
总结与展望
RL 在教育领域的应用正从“玩具模型”向“生产力工具”转型。未来的突破点可能在于 XAI(可解释 AI) 与 RL 的结合,让老师理解为什么系统让小明先学几何而不是代数。同时,向幼儿教育、非 STEM 领域的扩展也是尚未挖掘的蓝海。
局限性:当前研究中长周期(Longitudinal)的实验仍然稀缺,我们仍不确定这种 AI 诱导的效率提升是否能转化为长期的学业成就。