
Real-Time EXPO-FT:把 VLA 的慢推理与快反应拆开,让 RL 真正适配实时操控
Reinforcement Learning for Real-Time Vision-Language-Action Policies
本文提出 Real-Time EXPO-FT,用于在固定推理延迟下对预训练 VLA 模型进行在线强化学习微调。方法把大规模 VLA 的慢速候选动作生成与轻量编辑策略的快速反应分开,并用学习到的 Q 函数在最新观测下选择动作块。论文在 Kinetix 上将 4 步延迟下的平均成功率提升至 96.2%,并在四项真实动态任务中把十分钟内平均成功率从 42% 提升到 97%。
TL;DR
Real-Time EXPO-FT 要解决的是预训练 VLA 模型太大、推理太慢,导致动作执行时观测已经过时,进而破坏在线强化学习的可靠微调。论文的核心做法不是继续压模型延迟,而是把“表达性生成”和“实时反应”解耦:大 VLA 异步生成多个候选动作块,轻量编辑策略在真正执行前根据最新观测修正剩余动作,再用 Q 函数选择最高价值动作块。结果方面,仿真中它在 Kinetix 的平均成功率达到 96.2%,比 EXPO-FT w/ RTC 高 14.5 个百分点;真实世界四项动态任务中,在线数据上限为十分钟,平均成功率从 12.5/30 提升到 29/30。
背景定位
这项工作属于方法改进型实时机器人学习:它站在 EXPO-FT 与 Training-Time RTC 两个已有体系之上。EXPO-FT 提供面向 VLA 的样本高效 RL 微调骨架,RTC 提供延迟条件下动作块连贯执行的技术;本文的推进点是把二者放进同一个强化学习闭环里,让策略在高频率控制中同时具备大模型行为先验和最新观测下的反应能力。摘要与引言将其实验定位概括为:在 Kinetix 的 10 out of 10 个环境中,延迟策略达到延迟与非延迟方法中的最佳表现;真实世界任务上则强调十分钟在线数据、无人工干预和高成功率。
问题与动机
大 VLA 的优势来自容量,问题也来自容量。容量越大,多步行为、语义条件和跨任务泛化越好,但推理越慢。控制循环不会等待模型,机器人执行动作时,模型用来产生该动作的观测已经滞后了若干步。论文把这描述为 distribution shift:训练时若仍假设动作由当前状态生成,执行时却实际依赖旧状态,就会让标准 RL 的马尔可夫假设失效,使信用分配变偏。
更细地看,现有实时 chunking 方法,例如 RTC,主要解决“异步执行时动作块是否连贯”的问题。它们可以在旧 chunk 执行期间通过 inpainting 生成新 chunk,但没有机制主动利用强化学习去超过离线行为先验。论文的关键直觉是被实验和机制共同提示出来的:与其让大 VLA 慢吞吞地完整重新规划,不如让它异步提出候选,把真正依赖最新状态的决策交给一个很小的编辑策略和一个 Q 选择器。这样既保留大模型先验,又把实时反应做成强化学习可优化的对象。
核心章节:延迟、解耦与价值选择
基线的形式:延迟如何让动作不再由当前状态生成
论文在问题陈述中把控制频率记为 ,推理耗时为 ,延迟步数为 ,并假设 ,其中 是每次执行的动作块长度。于是,在第 步要执行的动作,实际上来自更早第 步发起的 VLA 推理。形式化地,这可以写成
其中 是在执行时刻真正被使用的动作, 是触发推理时的旧观测, 是预训练 VLA 的动作生成器。这个式子在论文论证链条里的作用,是把“推理延迟”从一个工程现象翻译成 RL 理论问题:标准在线 RL 更新通常假设当前动作由当前状态决定,而这里动作只看到了 步之前的世界状态。若 ,它退化成通常的无延迟策略,强化学习可以正常估计 ;但只要 大于零,最新状态 中关于物体运动、接触状态或对手动作的信息就缺失了,策略更新会高估旧观测对当前动作的解释力。
为了缓解这种不连贯,Training-Time RTC 一类方法会在生成新 chunk 时把推理窗口内已执行的动作前缀作为条件。论文在实时设置中沿用了这种思路,异步采样候选动作块:
其中 标记第 个候选 chunk, 是 VLA 预测的总动作块长度, 是旧 chunk 中已经或即将在推理期间执行的动作前缀, 是用于多样采样的噪声。相比单纯延迟执行,这个式子的改动在于显式告知模型“接下来 步不能再改”,从而让新 chunk 的生成与旧 chunk 的执行边界对齐。它的边界也很清楚:RTC 解决的是动作连贯性,不解决价值最优性;即使 chunk 平滑,它仍然主要依赖离线行为先验,没有利用最新观测和 RL 把策略推向更高成功率。
本文的改动:慢生成、快编辑与最新观测下的选择
Real-Time EXPO-FT 的核心结构是把慢速 VLA 候选生成放在后台,把执行前的价值选择放到前台。生成出的候选只保留真正需要执行的那一段,即 。在到达执行时刻 后,轻量编辑策略根据最新观测 对每个候选生成修正量 ,然后 Q 函数在原始候选和编辑后候选之间选择:
其中 是候选数量, 来自 VLA 的原始候选, 来自编辑策略, 是学习到的动作块价值函数, 是最终执行的动作块。这个式子是论文最本质的设计:大模型负责提出“看起来像专家”的行为分布,小模型和 Q 函数负责在执行前把候选拉到当前状态的高价值区域。相比直接用 VLA 输出,它让最终动作重新依赖 ;相比只编辑一个候选,它在 个候选上搜索,利用生成先验的多样性。若去掉编辑策略,选择只在过期候选间进行;若去掉 Q 函数,就无法判断哪个编辑动作在当前状态下更好;若把 VLA 换成即时推理,虽然可以保持当前状态条件,但大模型无法满足控制频率,这正是论文要规避的工程约束。
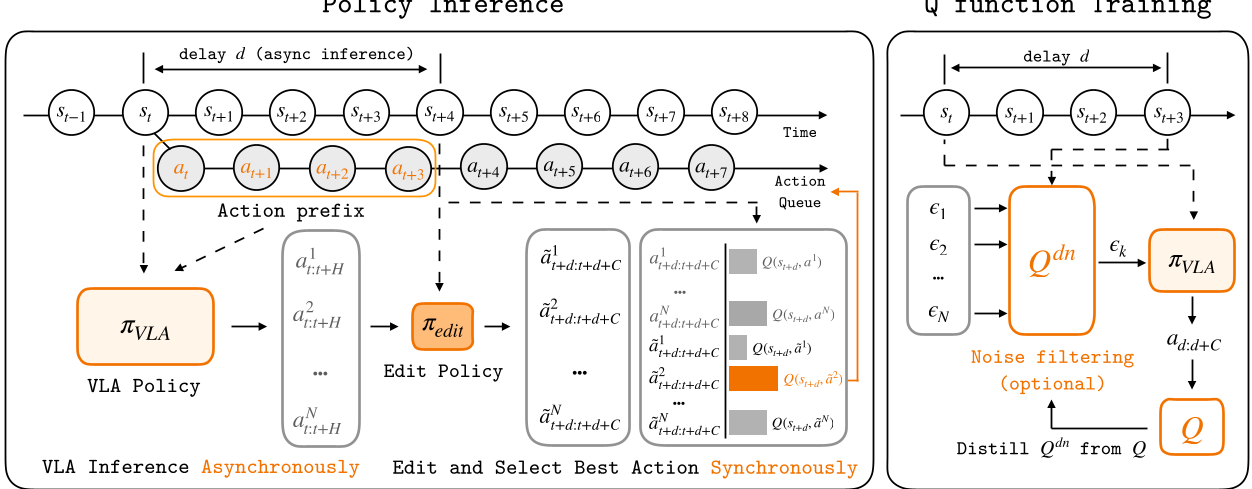
这张图说明的正是上述时间分工:左侧的慢路径在旧观测 下异步产生多个候选 chunk,右侧的快路径在最新观测 下编辑并选择一个执行。论文将这种结构视为对实时控制的 RL 化改造:不是让 RL 去优化整个大模型每一步的推理速度,而是只优化那些必须即时反应的动作修正与候选排序。
训练依据:chunk-level 价值学习与噪声过滤
训练侧的关键不是单步 TD,而是 chunk-level TD,因为动作块执行 步后才到下一次重规划边界。论文用下面的式子拟合 critic:
其中 是回放缓冲, 是本次执行的动作块, 是动作块结束后的状态, 是目标 critic, 是用延迟感知方式构造的下一块选择, 是折扣因子。这个式子在论证链条里承担“价值如何匹配实时动作块”的角色:它把一次 transition 定义为跨越 步的 chunk,而不是 30 Hz 控制循环中的单个动作。若把这里改成每一步更新,critic 会面对大量来自旧 VLA 输出的中间状态,容易把执行窗口内的延迟误差混入信用分配;而 chunk-level backup 更接近真实决策边界:机器人在 才重新选择下一块。
另一个重要设计是噪声空间过滤。论文指出,构造下一块 需要多次 VLA 解码,代价很高。为降低训练计算,它先用一个轻量 noise critic 在噪声空间打分,再只对高分噪声做解码:
其中 是候选噪声种子, 是直接给噪声打分的轻量 critic, 是预测下一块时实际触发 VLA 推理的延迟观测。这个式子相对完整动作空间选择减少了一个数量级的计算:它不要求对每个 都走完整的 VLA 去噪过程,而是让 noise critic 先筛选,再解码最高分噪声,并只生成一次编辑候选。论文在附录中把这一机制归因于 FASTER 一类价值引导采样思想;若取消噪声过滤,就要对 个候选都做完整去噪,训练计算显著增加。Figure 7 则提供了效率证据:在相同训练计算下,使用噪声过滤的学习曲线明显更靠上。
实验与证据
仿真:延迟策略反而超过零延迟基线
Table II 汇总了 Kinetix 上各方法在零延迟与四步延迟设置下的平均成功率:
| 设置 | 平均成功率 |
|---|---|
| BC,无延迟 | 90.7% |
| RLPD,无延迟 | 81.4% |
| BC,延迟 4 | 55.2% |
| RTC,延迟 4 | 80.0% |
| DSRL,延迟 4 | 61.7% |
| DSRL w/ RTC,延迟 4 | 76.1% |
| EXPO-FT,延迟 4 | 74.9% |
| EXPO-FT w/ RTC,延迟 4 | 81.7% |
| Real-Time EXPO-FT,延迟 4 | 96.2% |
这张表的核心信息不是单纯刷榜,而是证明本文结构能“补偿延迟并超过无延迟基线”。Real-Time EXPO-FT 在四步延迟下平均 96.2%,不仅高于 EXPO-FT w/ RTC 的 81.7%,也高于零延迟 RLPD 的 81.4%。正文进一步给出与四个延迟基线的差距:分别比 DSRL、DSRL w/ RTC、EXPO-FT 和 EXPO-FT w/ RTC 高 34.5、20.1、21.3 和 14.5 个百分点。由于 RLPD 的轻量 Gaussian policy 不需要大模型推理,它在零延迟时拥有当前状态,而 Real-Time EXPO-FT 的 VLA 部分必须依赖旧观测,这个结果说明反应式编辑与价值选择确实改变了延迟下的信息瓶颈。
真实世界:十分钟在线数据下的样本效率
Figure 5 展示了四项真实任务在最多十分钟在线机器人交互中的训练成功率曲线。图中可见,Real-Time EXPO-FT 的训练曲线在多个任务上更快爬升到高位,而基于 SFT 或延迟不敏感 RL 的方法停留在较低成功率。
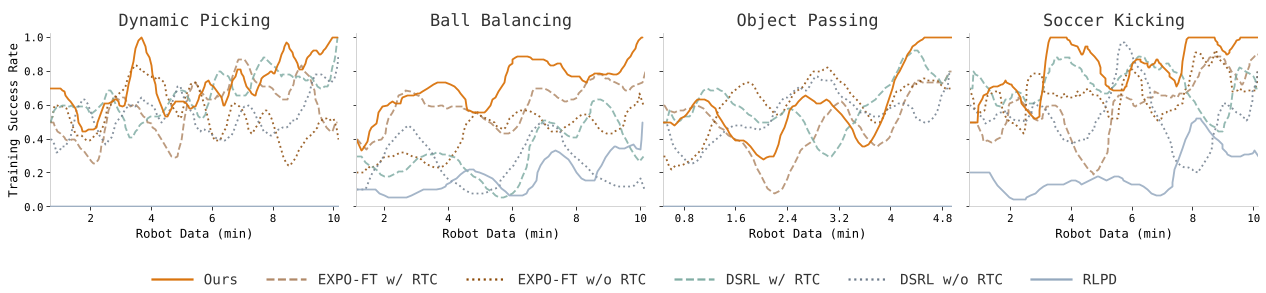
Table I 报告了四项真实任务在每任务 30 次评测中的成功次数,训练在线数据上限为十分钟:
| 任务 | SFT | SFT w/ RTC | RLPD | DSRL | DSRL w/ RTC | EXPO-FT | EXPO-FT w/ RTC | Real-Time EXPO-FT |
|---|---|---|---|---|---|---|---|---|
| Dynamic Picking | 19/30 | 22/30 | 0/30 | 23/30 | 25/30 | 21/30 | 24/30 | 30/30 |
| Ball Balancing | 8/30 | 12/30 | 12/30 | 11/30 | 15/30 | 18/30 | 23/30 | 28/30 |
| Object Passing | 10/30 | 22/30 | 0/30 | 23/30 | 23/30 | 19/30 | 27/30 | 30/30 |
| Soccer Kicking | 13/30 | 16/30 | 6/30 | 16/30 | 17/30 | 17/30 | 26/30 | 28/30 |
| Average | 12.5/30 | 18/30 | 4.5/30 | 18.3/30 | 20/30 | 18.8/30 | 25/30 | 29/30 |
表格最直接的结论是平均值从 SFT 的 12.5/30 提升到本文的 29/30,摘要将其写成 42% 到 97%。任务层面也有强信号:Ball Balancing 中没有任何先前方法超过 23/30,而 Real-Time EXPO-FT 达到 28/30;Dynamic Picking 和 Object Passing 上它拿到 30/30。论文同时说明,Ball Balancing 环境随机性强,小球位置的小扰动会迅速改变未来状态,因此最新观测下的动作编辑特别重要。Soccer Kicking 则需要空间与时间双重精准,28/30 说明方法并非只适合连续控制,也能处理带时序门控的交互。
延迟与速度敏感性:设计是否真的来自结构
Figure 6 在两个维度上检查方法的适用边界:H17 Unicycle 中的推理延迟变化,以及真实 Object Passing 中的传球速度变化。随着延迟增大,RTC 的表现退化,而 Real-Time EXPO-FT 保持稳定;随着环境更快,EXPO-FT 无实时处理会掉点,Real-Time EXPO-FT 仍接近 100% 成功率。
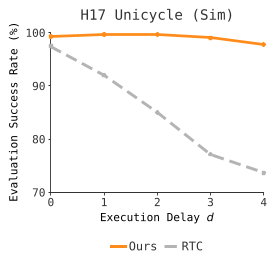
这些证据与核心章节的设计是一一对应的。延迟鲁棒性来自执行前的编辑与选择,而不是把整个 chunk 一次性定死;速度鲁棒性来自最新观测下 Q 函数对高价值动作块的判断。附录中报告实际设置时,π0.5 在服务器上的推理约 67 ms,控制频率 30 Hz;对于 Ball Balancing、Object Passing 和 Soccer Kicking,论文额外注入 100 ms,使总延迟约 167 ms,对应 ;Dynamic Picking 保留 67 ms,对应 。Table IV 给出环境步数约在 5k 到 18k 之间,且候选数量 ,这支持了“十分钟在线数据”并非通过无限交互堆出来的结论。
证据质量与局限
从证据强度看,仿真部分提供了跨 10 个 Kinetix 环境的平均结果,并显式对比零延迟与四步延迟,说明“延迟策略超过无延迟基线”不是单点结果。真实世界部分虽然只有四项任务和每任务 30 次评测,但任务类型覆盖连续平衡、高速抓取、外部物体交互和时序射门,且在线数据严格限制在十分钟,这对外部效度是有力补充。论文也承认一些不对称:RLPD 和 DSRL 以异步 learner 运行,享有更高 update-to-data ratio,而 EXPO-FT 与本文方法按 episode 更新;作者保留了对基线更有利的设置仍报告本文优势,这提高了结论可信度。
但证据也有边界。第一,真实世界延迟并非完全在统一条件下比较:Dynamic Picking 不注入额外 100 ms,而其他三项用 对应约 167 ms,论文解释是因为继续增加延迟会使非异步基线接近零,但这意味着最难动态任务上的延迟设定更轻。第二,成功率检测依赖任务规则或分类器,且环境 reset 仍需人工或任务特定自动流程;论文没有展示完全自主的 reset-reward-learning 闭环。第三,wall-clock 条件通过 sleep 注入延迟来近似更慢硬件,而不是直接报告端侧 GPU 上的端到端部署延迟;这能验证算法机制,但离真实硬件工程仍有距离。
深度洞察与总结
Real-Time EXPO-FT 的真正贡献不是又一个实时 chunking 技巧,而是把“延迟”从推理优化问题转化为强化学习价值选择问题。大 VLA 被降级为动作提案器,轻量编辑策略和 Q 函数被提升为实时决策器。这样做的理论好处是恢复执行时刻的当前状态依赖:编辑策略以 为条件,选择器也以 为条件,因而组合策略在延迟框架下更接近可优化的实时控制对象。相比直接对 VLA 做 RL,它避免让昂贵模型承担每一步反应;相比只做 RTC,它提供了可被 Q 函数持续改进的在线目标。
从工程角度看,这套架构对后续系统很有吸引力:它允许团队保留大而强的 VLA 行为先验,同时用一个小型、可快速推理的编辑与选择层满足 30 Hz 控制。未来最值得推进的方向不是泛泛“扩展到更多机器人”,而是把这套异步候选生成、编辑和噪声过滤结构放到真实端侧 GPU 的波动延迟下,而不是固定 sleep 模拟;同时研究自动 reset、跨任务共享 critic 表示,以及更强 reward classifier 或通用 success detector 对成功率稳定性的影响。若这些环节能闭环,Real-Time EXPO-FT 的“十分钟 RL 微调”就不再只是实验设置,而会成为可部署实时机器人策略学习的一个标准骨架。