
CUDRT:揭开 LLM 生成文本的隐形外衣——中英双语全操作评估框架深度解析
Towards Reliable Detection of LLM-Generated Texts: A Comprehensive Evaluation Framework with CUDRT
本文提出了 CUDRT,一个旨在提升大语言模型(LLM)生成文本检测可靠性的综合评估框架和双语基准。该框架通过 Create, Update, Delete, Rewrite, Translate 五类核心操作对 LLM 活动进行系统分类,涵盖了从内容创作到翻译的完整生命周期,并在中英双语环境下评估了 SOTA 检测器的性能。
TL;DR
随着大语言模型(LLM)的爆发,区分“人言”还是“机语”已成为内容安全的核心挑战。来自人大等机构的研究者提出了 CUDRT 框架,首次从 Create, Update, Delete, Rewrite, Translate 五大操作维度构建了 48 万规模的中英双语基准。研究发现:翻译后的机生文本隐蔽性最强;而“删除类”任务(如摘要)则是训练检测器的“黄金方案”,具备极佳的泛化效果。
1. 现状之痛:检测器的“舒适区”与“盲点”
目前的检测器研究大多在玩“打地鼠”游戏:
- 数据集静态化:模型在 A 数据集表现好,换到 B 数据集就崩盘。
- 任务单一:现有的基准(如 HC3)重度集中在问答(QA),而现实场景中,人类更多使用 LLM 进行润色(Polish)或翻译。
- 语言短板:中文互联网环境下的机生文本检测研究进度显著慢于英文,且受限于分词与语义复杂性。
2. CUDRT 核心机制:五大脑图分类法
研究者将 LLM 的操作直观地归纳为五个核心动作:
- Create(无中生有):包括续写(Complete)和问答(QA)。
- Update(锦上添花):包括润色(Polish)和扩展(Expand)。
- Delete(去粗取精):包括摘要(Summary)和细化(Refine)。
- Rewrite(改头换面):风格迁移与重写。
- Translate(跨界转换):中英双向翻译。
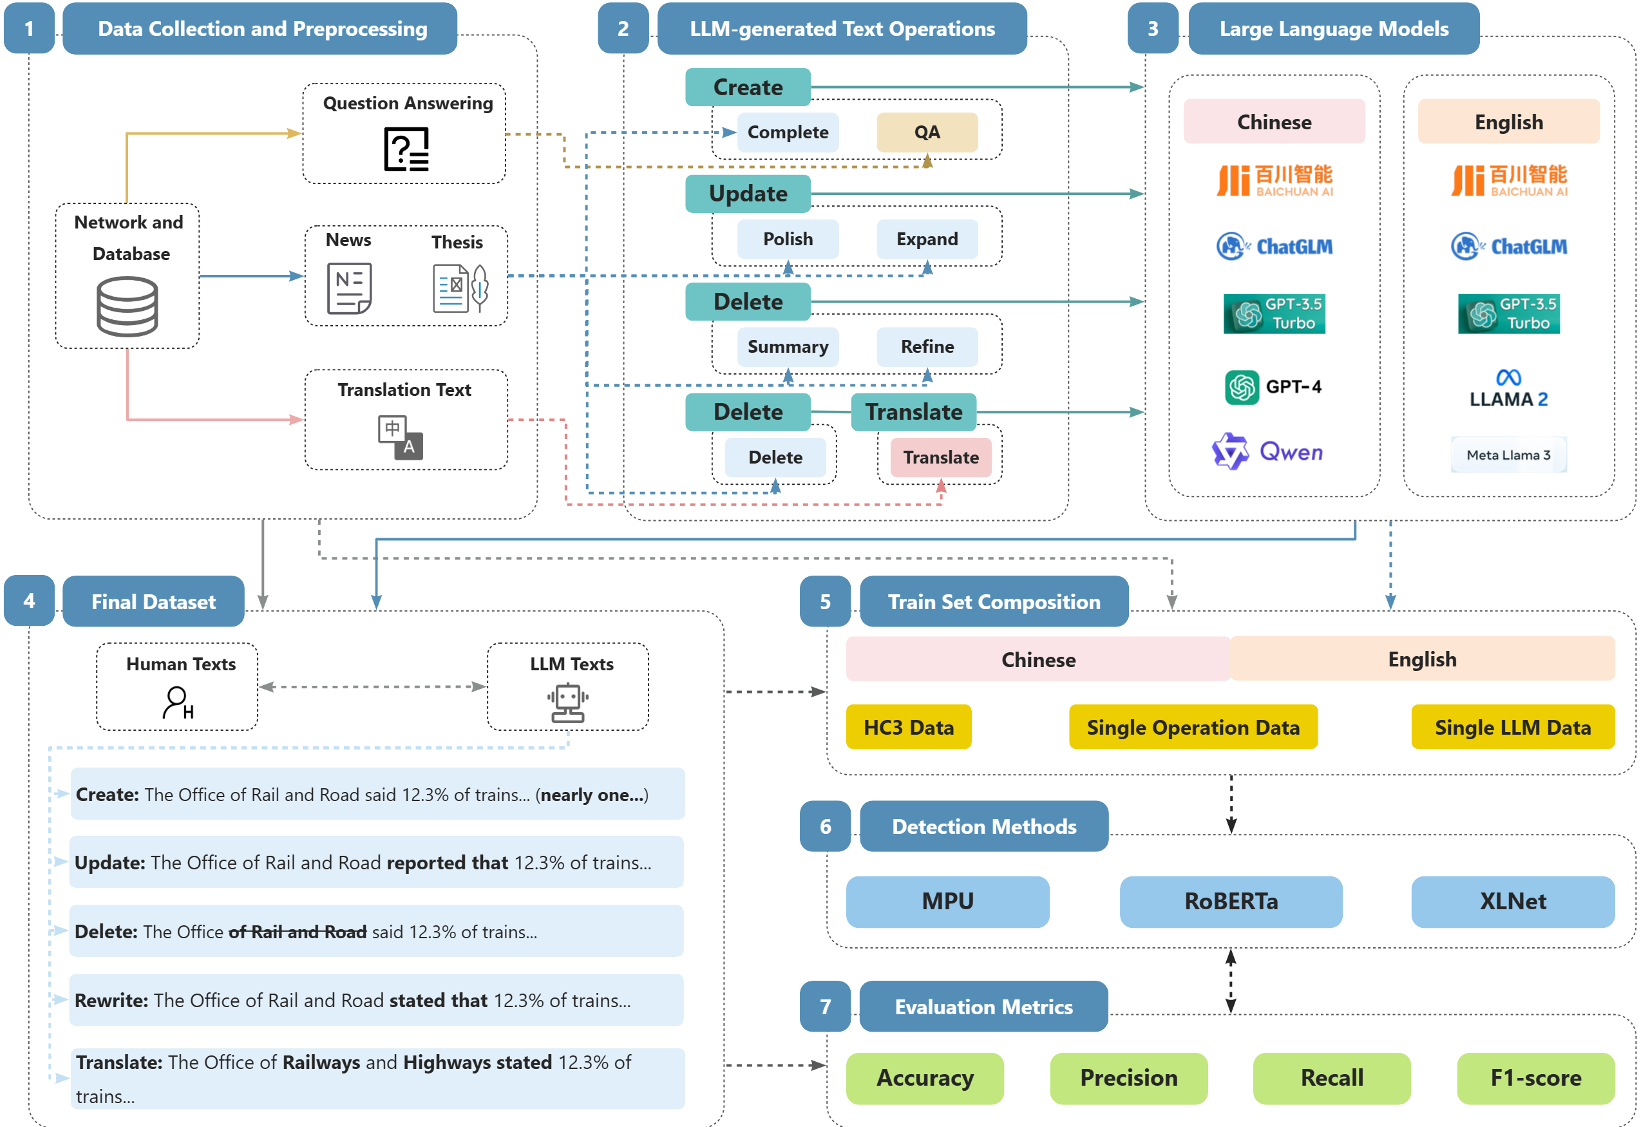 上图展示了从数据源选择、到五大操作生成、再到多维度检测实验的 CUDRT 完整生命周期。
3. 核心实验与发现:谁才是检测的“阿喀琉斯之踵”?
困惑度(Perplexity)的真相
研究发现,除了翻译任务外,LLM 生成文本的 PPL 分布通常比人类文本更低且更集中。这揭示了 LLM 创作的本质——它在概率预测上更加“稳健”且保守,缺乏人类写作中那种由于知识跳跃或逻辑断裂带来的“突兀感”。
跨操作检测的“黄金法则”
如果训练数据有限,应该优先训练哪类数据?CUDRT 给出了明确答案:Delete 任务。 实验数据显示,以摘要后的文本作为训练源,训练出的 RoBERTa 或 XLNet 检测器在测试 Rewrite 或 Update 任务时,其准确率和 F1-score 显著高于其他预修。 Insight:Delete 操作强迫 LLM 对原始文本进行语义蒸馏,会留下极其明显的 LLM 架构特征痕迹。
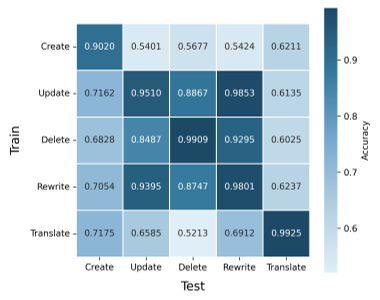 热图显示了在不同操作间训练与测试的交叉表现,Delete 操作在跨任务中的泛化性“全线飘红”。
4. 深度洞察:为什么翻译后的 AI 文本难以识别?
在跨数据集测试中(Table 4 & 5),Translate 操作的各项指标全面沦陷。
- 根源分析:翻译任务有极强的源文本约束性(Identity Constraint),LLM 在翻译时被限制在特定语序和语义中,大幅抹平了其在自由创作时的概率偏好,使得模型输出的分布与人类专业翻译极其接近。
5. 局限性与未来视野
CUDRT 虽然提供了双语和全维度的视角,但面对 Baichuan2-13B 等特定国产模型时,主流检测器的表现依然波动巨大。这不仅是检测器的问题,更是中文语料分布差异的体现。
未来方向建议:
- 轻量化实时推理:目前的 model-based 检测器计算开销大,难以在大规模内容审核中应用。
- 自学习机制:随着 LLM 快速迭代,检测器需要具备从少量样本中快速捕获新架构偏移的能力。
结语
CUDRT 框架为 LLM 时代的真实性防御筑起了更坚固的多彩防线。它告诉我们,不要只盯着 QA,真正的高级对抗正发生在翻译和细微润色之间。