
揭开 LLM 查询重构的“神话”:一项深度的可复现性研究
A Reproducibility Study of LLM-Based Query Reformulation
本文对基于大语言模型(LLM)的查询重构(Query Reformulation)进行了系统性的可复现性研究。作者在统一框架 QueryGym 下评估了 10 种代表性方法,涵盖 2 个模型家族、3 种检索范式和 9 个基准数据集。
TL;DR
在信息检索(IR)领域,利用大语言模型(LLM)进行查询重构(Query Reformulation)被视为提升搜索效果的捷径。然而,Waterloo 等大学的最新研究发现:我们在论文中看到的巨大增益可能带有“水分”。通过统一框架 QueryGym 对 10 种方法进行压测,研究指出:重构在传统词法检索(BM25)中效果卓著,但在神经检索器(Dense/Sparse)中往往表现平平,且模型越大并不意味着效果越好。
1. 动机:繁荣背后的“实验陷阱”
查询重构的本质是解决用户查询与文档之间的“词汇鸿沟”。从 GenQR 到 Query2Doc,LLM 凭借其强大的参数化知识,展现了优于传统伪相关反馈(RM3)的潜力。
但在学术界,我们一直面临一个尴尬的现状:
- Backbone 不统一:有人用 GPT-4,有人用 Llama。
- Decoding 随机性:Temperature、Top-p 的微小差异可能大幅改写实验结果。
- 检索范式单一:大多数研究只拿 BM25 说事,忽略了现代工业界更常用的稠密检索(Dense Retrieval)。
2. 核心方法论:重构策略的三大家族
作者将当前主流方法归纳为三个维度,这为我们理解 LLM 在 IR 中的角色提供了清晰的坐标系:
- 关键词级(Keyword-Level):如 GenQR、GenQREnsemble。核心是“扩充词表”。
- 文档级(Document-Level):如 Query2Doc (Q2D)、MUGI。其 Insight 是通过生成一段类似答案的伪文档,为检索提供更丰满的语义背景。
- 语料库增强型(Corpus-Grounded):如 LameR、CSQE。这类方法不仅靠 LLM 盲猜,还会结合检索到的初始证据进行“二次创作”。
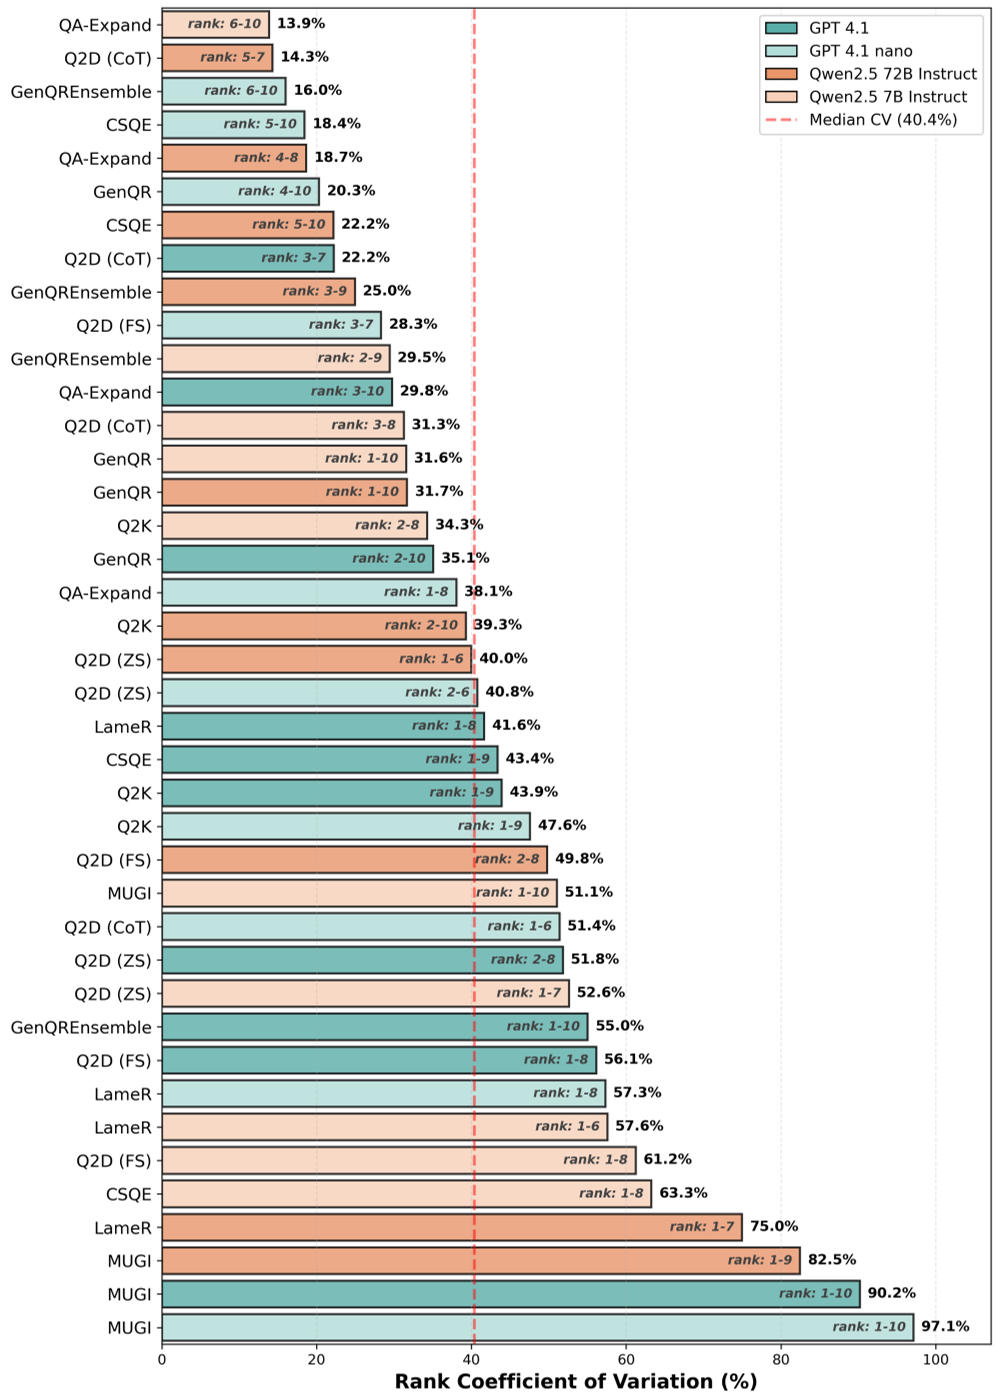 (上图展示了不同 LLM 后端在 DL-HARD 和 BEIR 基准上的性能雷达图,可见 GPT 家族即便在 nano 规模下也保持了极佳的稳定性)
3. 震荡发现:重构增益在神经检索中大幅“缩水”
这是该研究最硬核的结论:查询重构的有效性与检索器的表示空间(Representation Space)强相关。
- BM25(词法检索):LLM 增加的关键词能直接匹配到文档,效果提升显著(Accuracy +20% 以上是常态)。
- SPLADE(学习型稀疏检索):由于 SPLADE 已经在 Encoder 阶段自带了类似“语义扩充”的功能,LLM 生成的重构内容与其功能高度冗余,增益迅速摊平。
- BGE(稠密检索):这是重灾区。在连续向量空间中,LLM 引入的额外文本有时会引入噪声,导致向量重心的偏移。在多个数据集(如 COVID, DBPedia)上,重构后的效果反而不如原始查询。
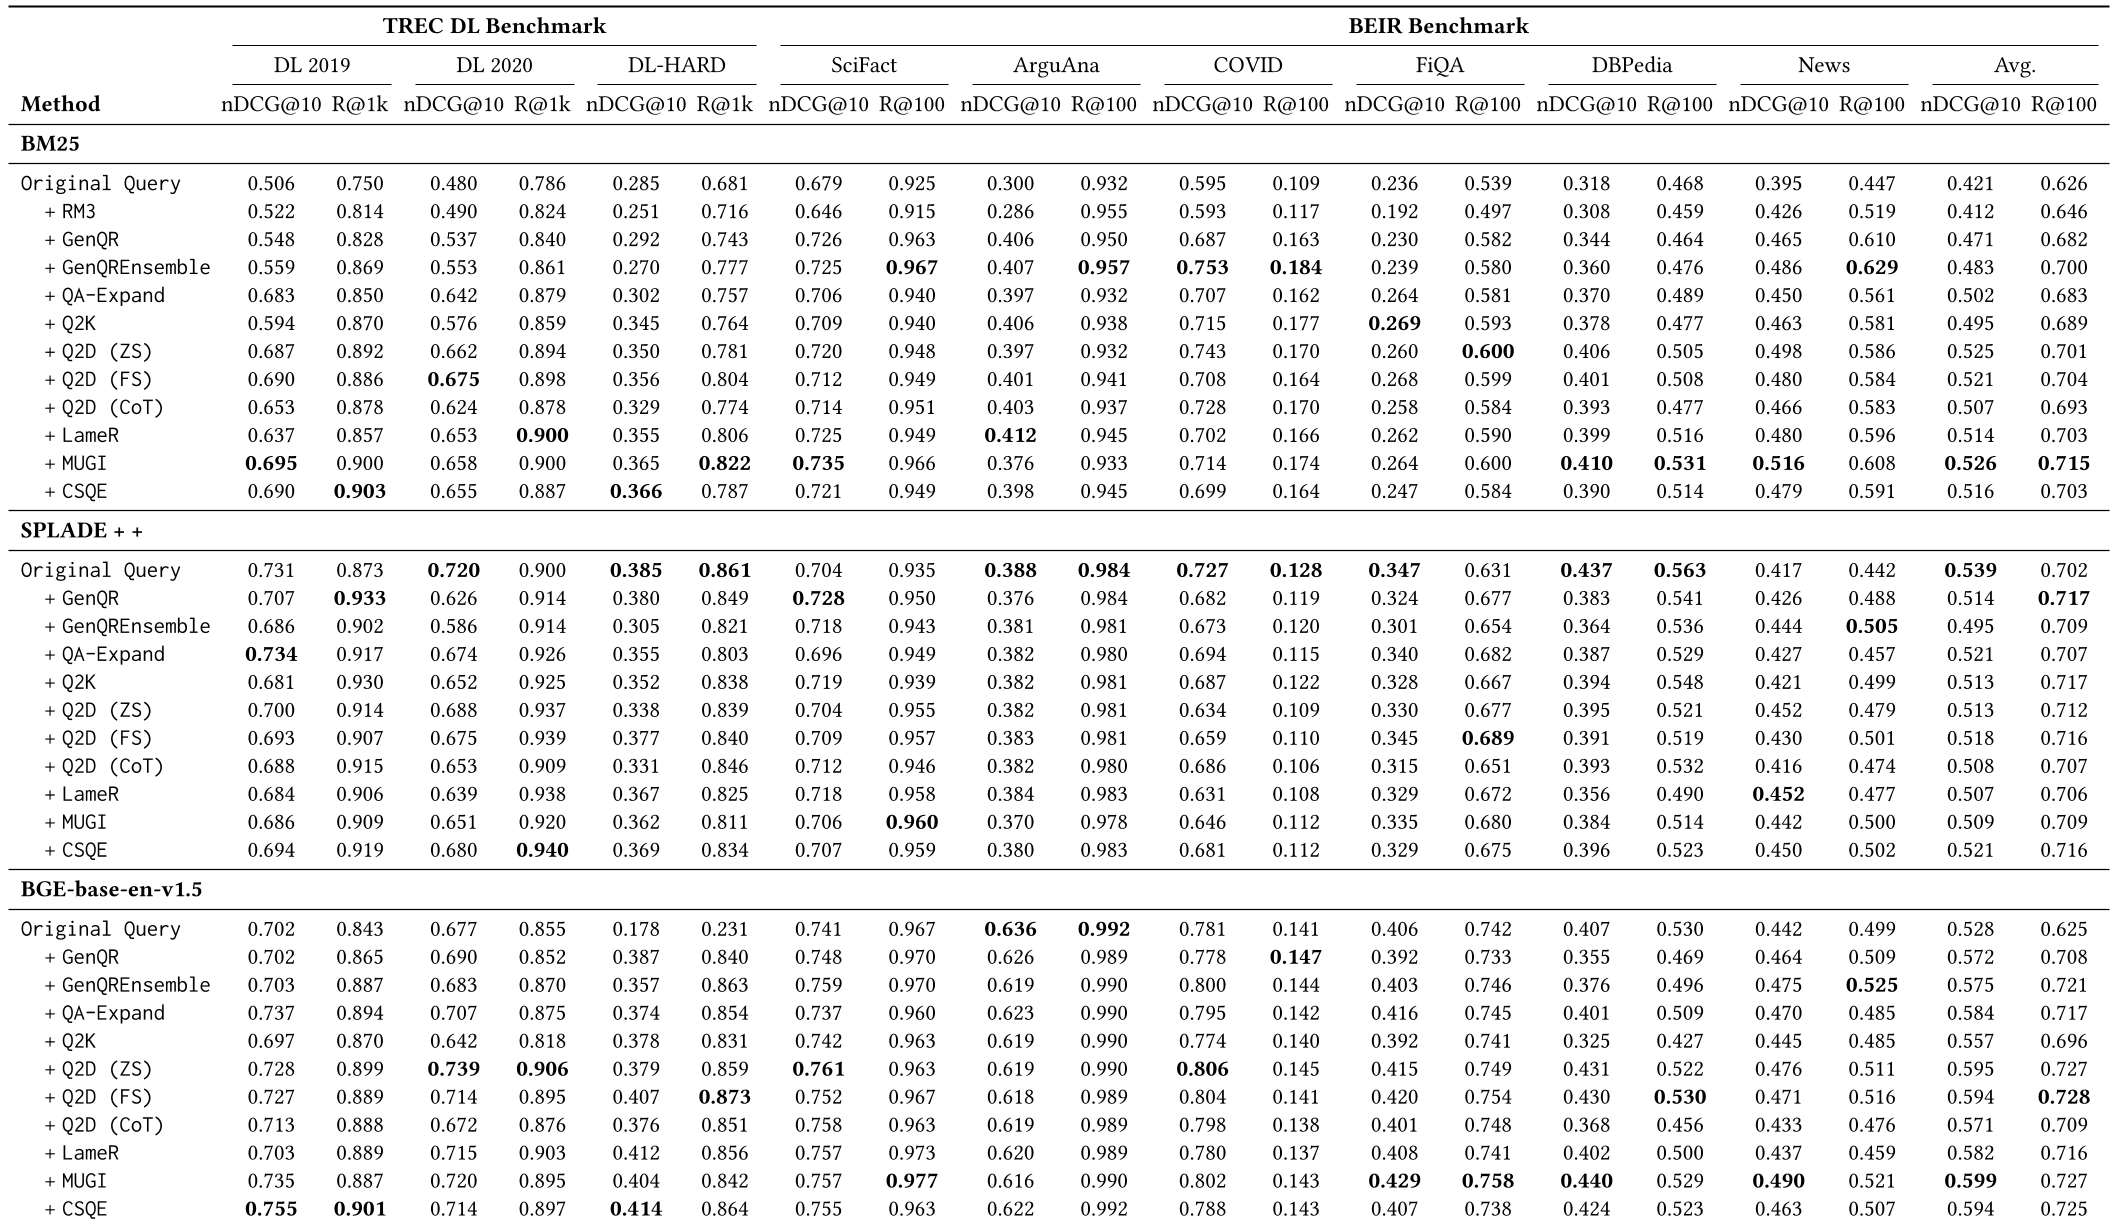 (从表中可以看出,随着从 BM25 迁移到 SPLADE 和 BGE,nDCG@10 的增益显著减小)
4. 深度洞察:规模并不代表一切
作者对比了 GPT-4.1 vs GPT-4.1-nano,以及 Qwen2.5-72B vs Qwen2.5-7B。
- 稳定性惊人:GPT-4.1 nano 虽然规模小,但在查询重构任务中表现得极其坚韧,在多数数据集上甚至逼近其完整版。
- 交互项陷阱:研究揭示了 LLM × Method 的显著交互作用。这意味着不存在“放之四海而皆准”的重构策略。某方法在 Qwen 上是 SOTA,换到 GPT 可能就名落孙山。
5. 局限性与展望
尽管该研究为领域设立了基准,但仍存在局限:
- 成本考量:虽然验证了小模型的有效性,但多次调用 LLM 进行重构的延迟(Latency)在实时搜索中依然是巨大挑战。
- 静态评估:目前的评估仍基于离线数据集,未考虑用户点击反馈的动态演化。
结论
这项 Reproducibility Study 告诉我们:查询重构的未来不在于盲目堆砌模型参数,而在于如何让重构内容与底层的**神经网络索引(Neural Index)**协调一致。如果你正在构建基于 BM25 的简单系统,重构是神器;如果你已经在使用 BGE 等 SOTA 稠密检索器,请谨慎对待 LLM 的“二次创作”。
本博客基于论文《A Reproducibility Study of LLM-Based Query Reformulation》重构撰写。