
ReSeek:赋能搜索智能体实时自纠错,终结多跳推理“一路错到底”
ReSeek: A Self-Correcting Framework for Search Agents with Instructive Rewards
本文提出了 ReSeek,一个为搜索智能体设计的自纠错框架。该方法引入了 JUDGE 动作和细粒度的指令性奖励函数,使智能体能在线识别并跳出错误搜索路径,在多跳知识问答任务中达到 SOTA 水平。
TL;DR
在处理复杂知识任务时,AI 搜索智能体常因第一步“搜错了”而导致全局崩盘。腾讯团队发表的论文 ReSeek 提出了一种创新的自纠错框架:通过让智能体学会执行一个特殊的 JUDGE(判断) 动作,它可以像人类一样在看到结果后停下来质疑:“这个信息对我解决问题有用吗?”配合密集的过程奖励函数,ReSeek 在多跳问答(Multi-hop QA)性能上刷新了 SOTA。
痛点深挖:为什么当前的搜索 AI 容易“钻牛角尖”?
传统 RAG 或早期的强化学习(RL)驱动的智能体通常存在两大致命伤:
- 奖励稀疏(Sparse Reward):RL 往往只看“最后答案对不对”。如果中间搜索词偏了,智能体得不到及时反馈,就会在错误的道路上渐行渐远。
- 缺乏元认知:一旦执行了错误的 Action,智能体通常没有“掉头”或“撤回”的机制,轨迹一旦生成就不可逆。
如下图所示,传统的搜索智能体在查询 obscure entity 时,即便初次检索未果,也会试图基于不完整的信息生搬硬套,导致幻觉。
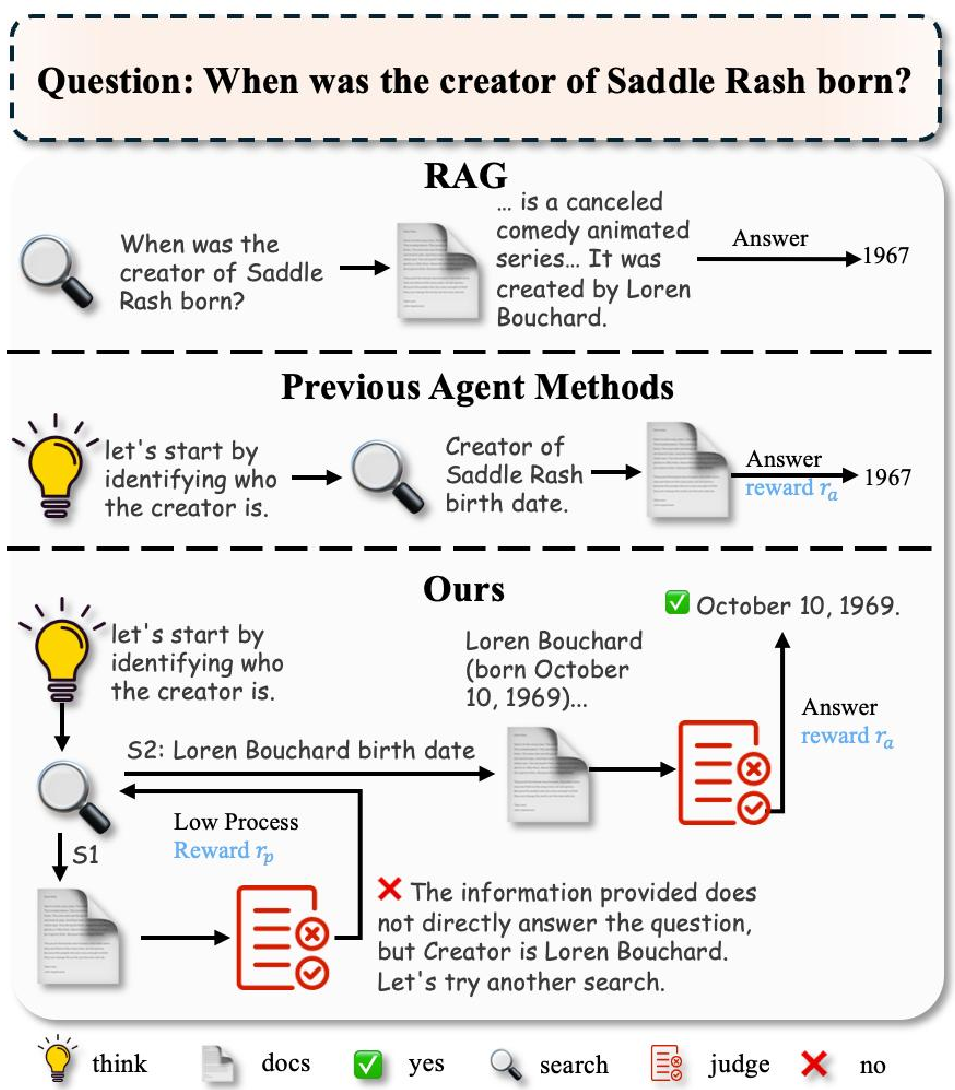
核心机制:JUDGE 动作与密集奖励
ReSeek 的核心贡献在于将 “评估信息效用” 融入了智能体的策略空间(Action Space)。
1. JUDGE 动作:智能体的“心流控制”
智能体不再是简单的 Search -> Answer。在每次获取 Observation(检索结果)后,它必须强制执行一个 <judge> 标签。
- 如果判断为
Yes且信息足够,则回答; - 如果判断为
Yes但信息仍欠缺,则继续搜索; - 如果判断为
No,则必须标记该路径无效并重新规划查询词。
2. 指令性过程奖励(Instructive Process Reward)
为了训练出精准的 JUDGE 能力,作者引入了 BGE-Reranker 作为“陪练”。
- 理想判断 (Ideal Judgment):如果检索内容与真实答案的语义相关度 > 0.7,则标准答案为 Yes。
- 非对称惩罚:为了防止智能体懒惰,ReSeek 对“误把噪声当有用”(False Positive)惩罚更重(-0.6),这迫使智能体只有在确信信息有效时才停止搜索。
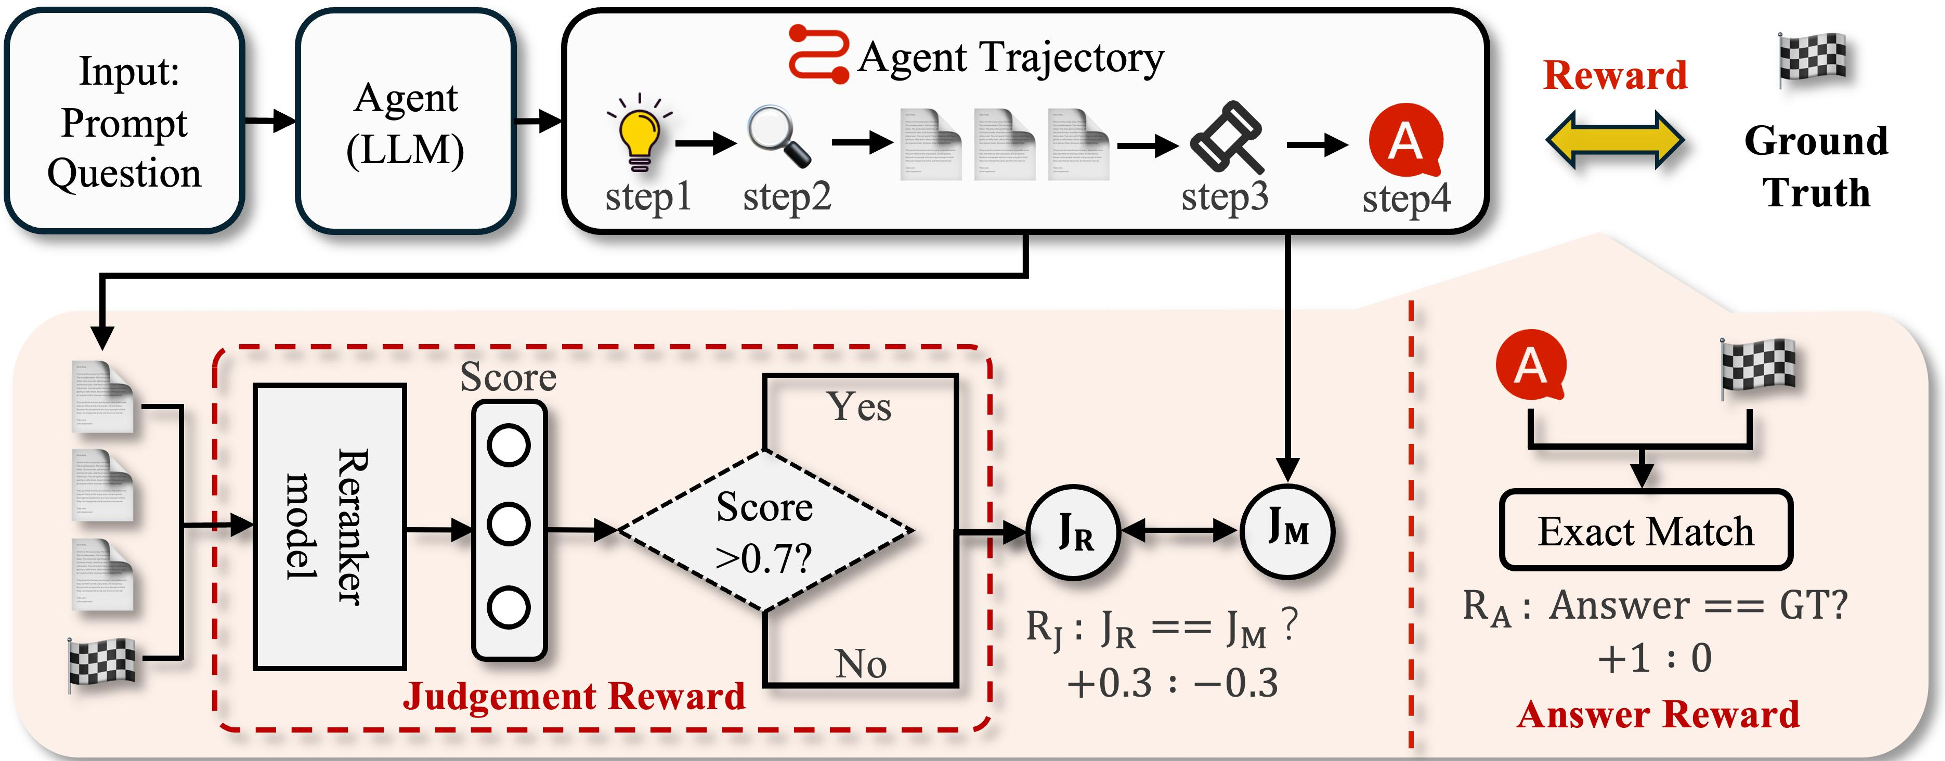
FictionalHot:专治靠背书拿高分的 LLM
为了防止 LLM 利用预训练阶段背下的 Wikipedia 知识“偷分”,作者构建了 FictionalHot 基准。通过 GPT-5 将现实实体替换为虚构实体(例如 Taylor Swift 改名为 Lila Starling),并伪造配套的百科文档。这要求智能体必须 真的会用工具检索并推理,而不是靠记忆。
实验战绩:多维度超越现基准
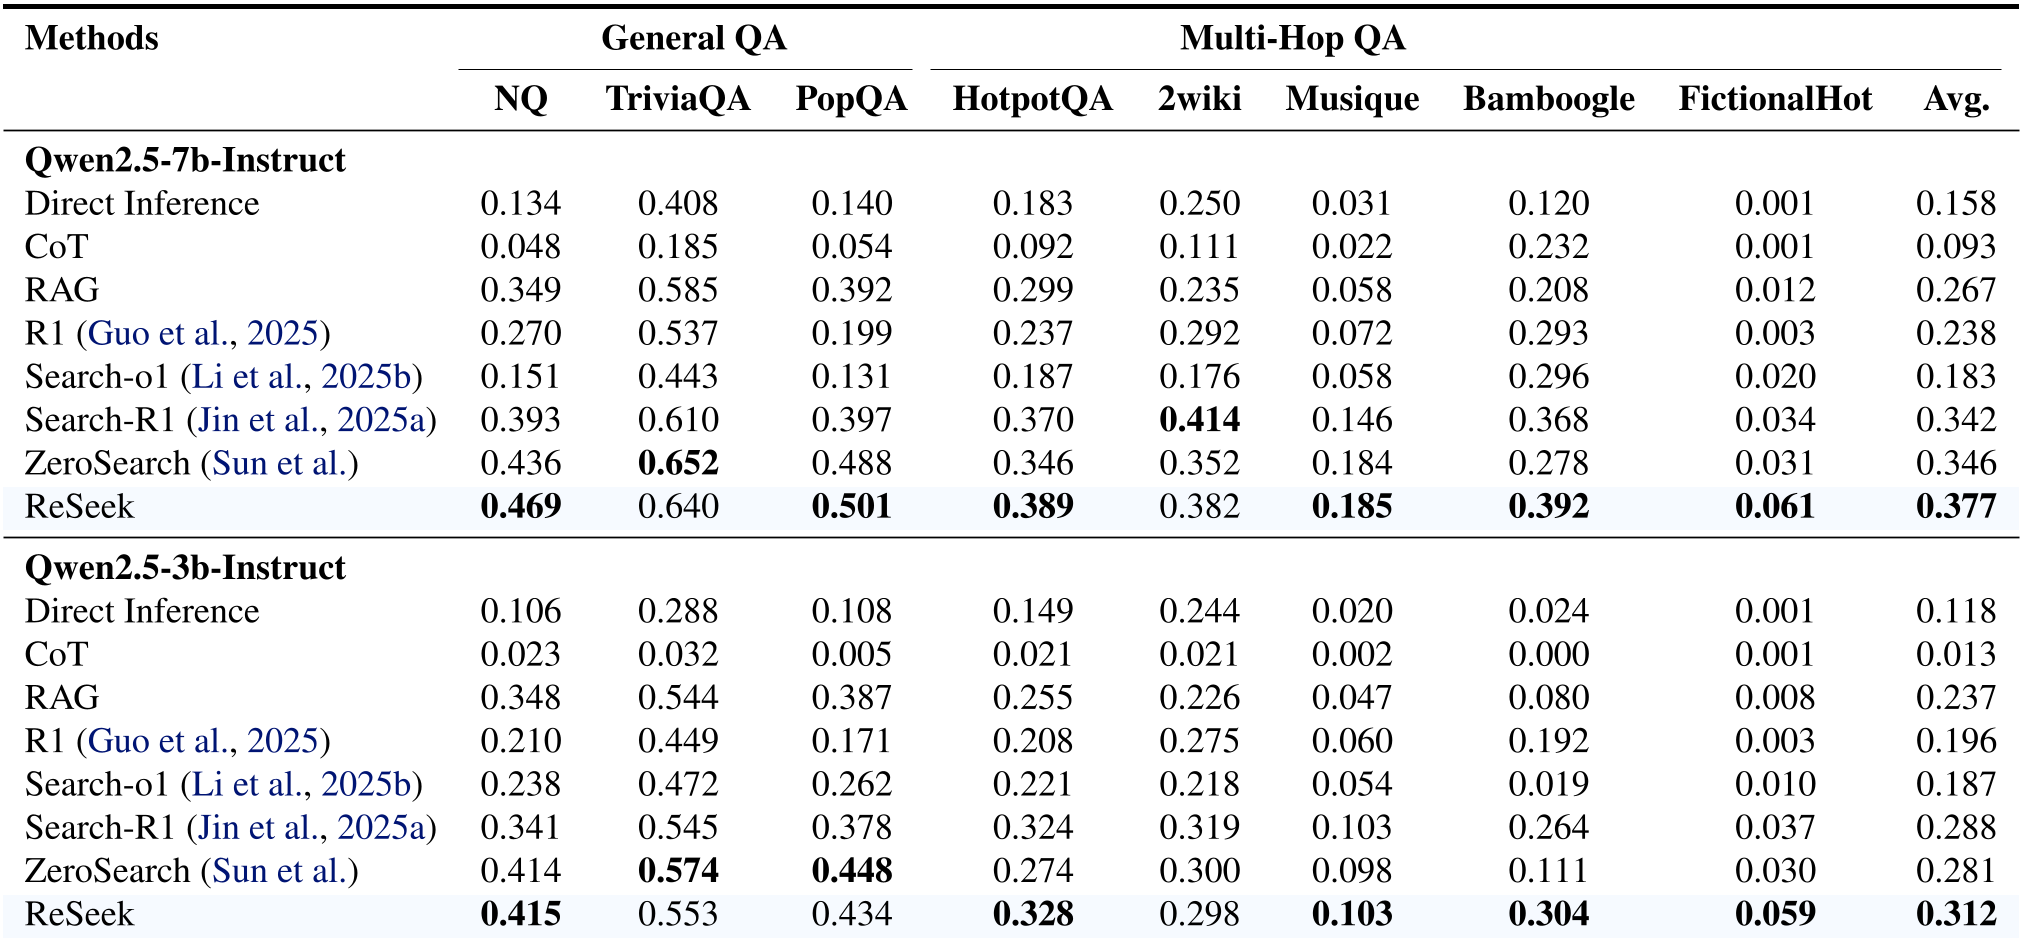
在 Qwen-2.5 系列模型上,ReSeek 的表现令人惊艳:
- 全能表现:在包括 NQ, HotpotQA 在内的 8 个主流榜单上平均 EM(Exact Match)提升显著。
- 纠错红利:在多跳任务 HotpotQA 上,即便在 4 步(Turns)的搜索预算下,ReSeek 依然能持续获得性能增益,而传统基线在 2 步后就开始性能饱和。
深度洞察:为什么 GRPO 比 PPO 更适合?
论文在附录中专门探讨了训练稳定性。在处理长 Chain-of-Thought (CoT) 时,传统的 PPO 极易发生策略崩溃(Policy Collapse)。而采用 GRPO (Group Relative Policy Optimization),通过组内相对优势计算,ReSeek 表现出了极强的鲁棒性,能够稳定地内化 JUDGE 的结构化约束而不产生复读机现象。
总结与局限
ReSeek 成功地证明了:搜索智能体的瓶颈不在于“检索不到”,而在于“不知道检索到了没用”。
局限性:目前的 JUDGE 信号高度依赖最终答案的相关性。对于需要极深逻辑链(如 A->B->C->D)的任务,中间步骤 A 可能与最终答案 D 的语义相关性偏低,导致 JUDGE 给错信号。未来的方向将是引入“中间证据链”级别的奖励。
这是一篇典型的“工程直觉推动算法创新”的佳作,对于构建下一代智能 Agent 系统具有极高的启发性。