
重新审视 LLM 在线策略蒸馏:现象学、机制与实操秘籍
Rethinking On-Policy Distillation of Large Language Models: Phenomenology, Mechanism, and Recipe
本文对大语言模型的在线策略蒸馏(On-Policy Distillation, OPD)进行了系统性研究,提出了 OPD 成功的两大核心条件:思维模式一致性与教师模型的增量知识。通过深入的细节分析,作者揭示了其 Token 级别的对齐机制,并开源了 OPD 研究框架。
TL;DR
在线策略蒸馏(On-Policy Distillation, OPD)已成为 LLM 后训练阶段的标配,但在实践中却像玄学一样脆弱。清华等机构的这项研究彻底拆解了 OPD 的黑盒:OPD 的本质不是学习正确答案,而是学生在教师的引导下,对自身思维路径(Thinking Patterns)进行重对齐。 研究指出,仅仅靠更强的教师模型是不够的,如果思维模式不匹配,哪怕是 SOTA 教师也会带偏学生。
核心速览
- 地位:填补了 OPD 训练动力学理论的空白,为 Qwen3、GLM-5 等工业界方案提供了实证支撑。
- 核心发现:OPD 的成功依赖于“思维模式一致性”和“教师拥有新知识”。
- 机制突破:证明了 99% 的蒸馏增益来自于学生与教师前 K 个高频 Token 的重合区域(Overlap Region)。
1. 痛点:为什么“名师”带不出“高徒”?
在知识蒸馏的传统认知里,模型越大、能力越强,蒸馏效果应该越好。然而在 OPD 环境下,研究者观察到了惊人的反直觉现象:
- 失效案例:一个在 Benchmark 上得分更高的 7B 教师模型,在蒸馏 1.5B 学生时,效果竟然不如一个能力稍弱但同系列的 1.5B 教师。
- 现象本质:如果教师和学生的“思维逻辑”差得太远,学生生成的 Token 序列超出了教师的“理解范畴”,教师给出的 Token 级奖励就会变成噪声。
2. 只有思维对频,蒸馏才能“共鸣”
论文提出了两个决定 OPD 成败的决定性条件:
- 思维模式一致性 (Thinking-pattern Consistency):学生和教师在处理同一问题时,其 Top-K Token 的候选空间必须有较高的重合率。
- 增量知识 (New Knowledge):如果教师只是学生的放大版(训练数据完全一致),OPD 的提升空间将极其有限。
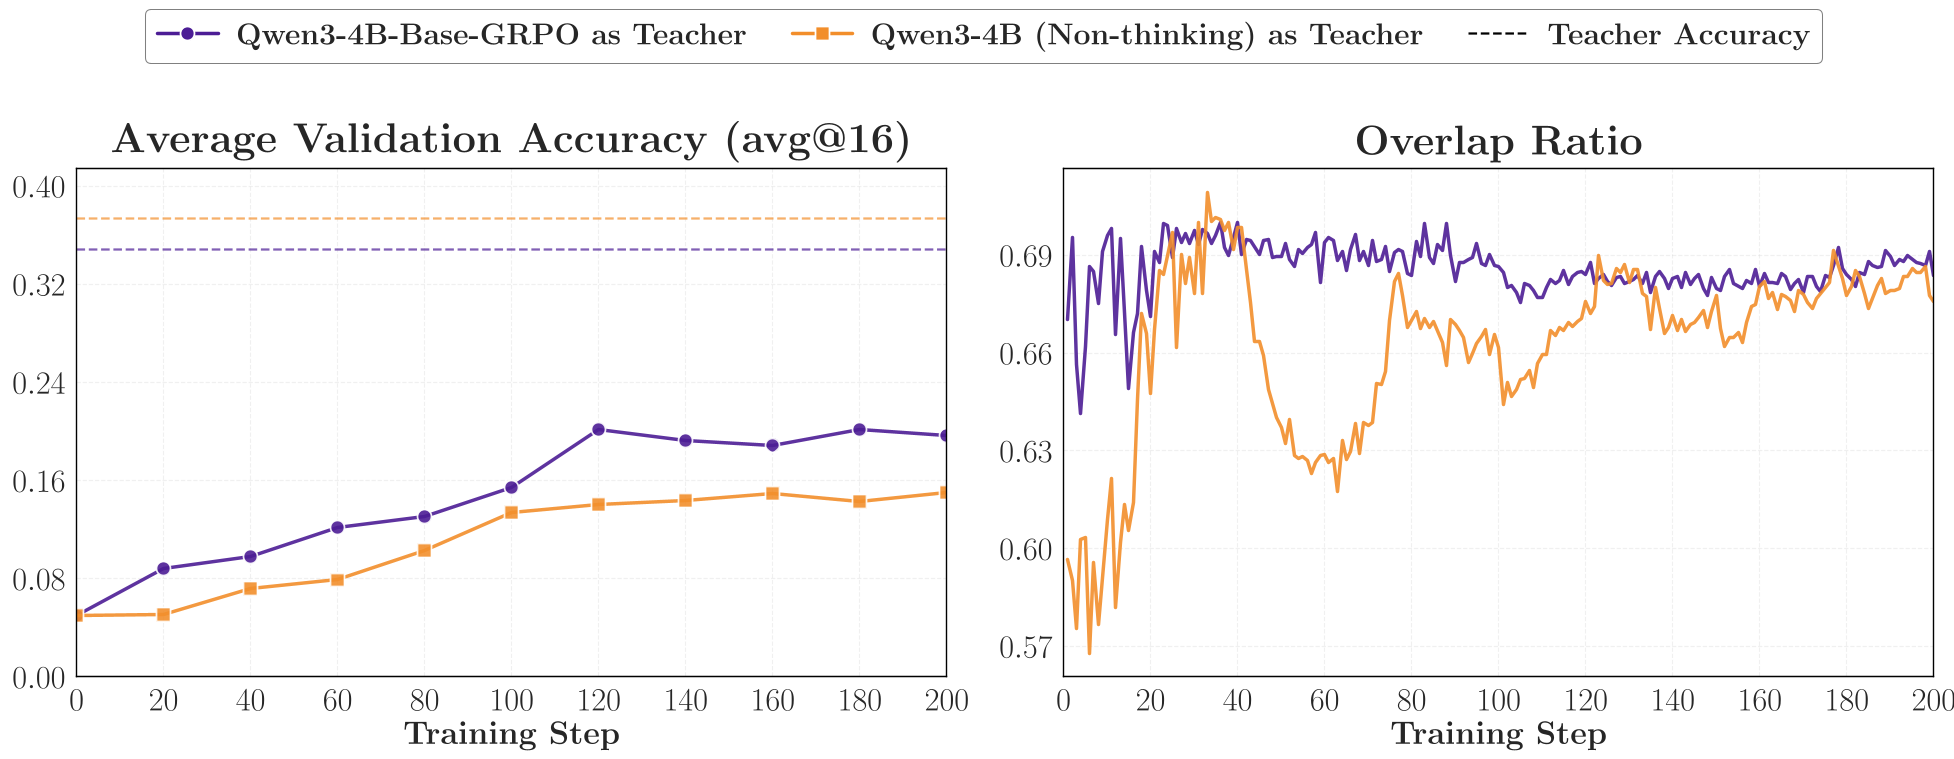 上图展示了:尽管两个教师性能相似,但思维模式更贴近学生的那个(GRPO 训练版),其蒸馏出的学生性能(左图)和 Overlap Ratio(右图)显著更高。
3. 机制拆解:高频 Token 的“虚拟循环”
研究者深入 Token 级别发现,成功的 OPD 表现出一种 “渐进式对齐”:
- 重合区即核心:学生与教师的 Top-K Token 重合率会从 72% 稳步升至 91%。
- 概率质量集中:这少量的重合 Token 占据了 97%-99% 的概率质量。
- 实验洞察:作者尝试了一个极端实验——仅对重合的 Token 计算 Loss。结果显示,这种方式竟然完美复现了全量 Token 蒸馏的性能。这意味着 OPD 实际上是在微调学生在这些关键决策点上的置信度。
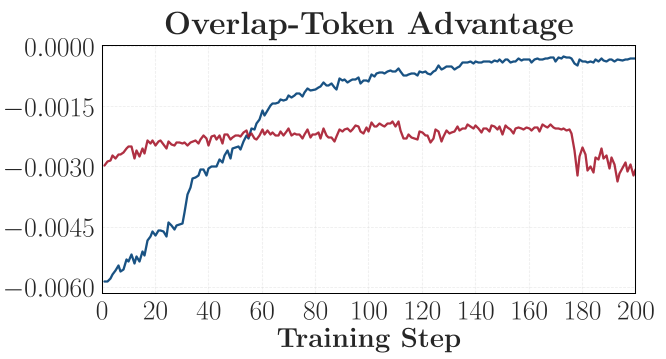 成功的蒸馏(实线)伴随着熵差(Entropy Gap)的收缩和重合率的提升。
4. 实操秘籍:如何挽救失效的蒸馏?
针对学生/教师不匹配的问题,论文给出了两套特效药:
- 离线冷启动 (Off-policy Cold Start):先让学生在教师生成的点心(静态数据)上做 SFT,强行把学生的思维拉近教师,再开启在线蒸馏。
- 提示词对齐 (Teacher-aligned Prompts):使用教师在强化学习阶段见过的 Prompt 模板。即使是微小的格式差异(如
Answer:还是\boxed{}),也会极大影响蒸馏的稳定性。
5. 局限性与警示:长文本并非“免费午餐”
OPD 的密集颗粒度监督是有代价的。研究发现:
- 奖励质量随深度衰减:当推理长度超过 3K-7K 后,OPD 的收益开始平滑甚至下降。
- 不稳定性的传播:训练中的不稳定信号往往从序列的末尾(Later Tokens)产生,并逐步向前端蔓延,导致整个分布坍塌。
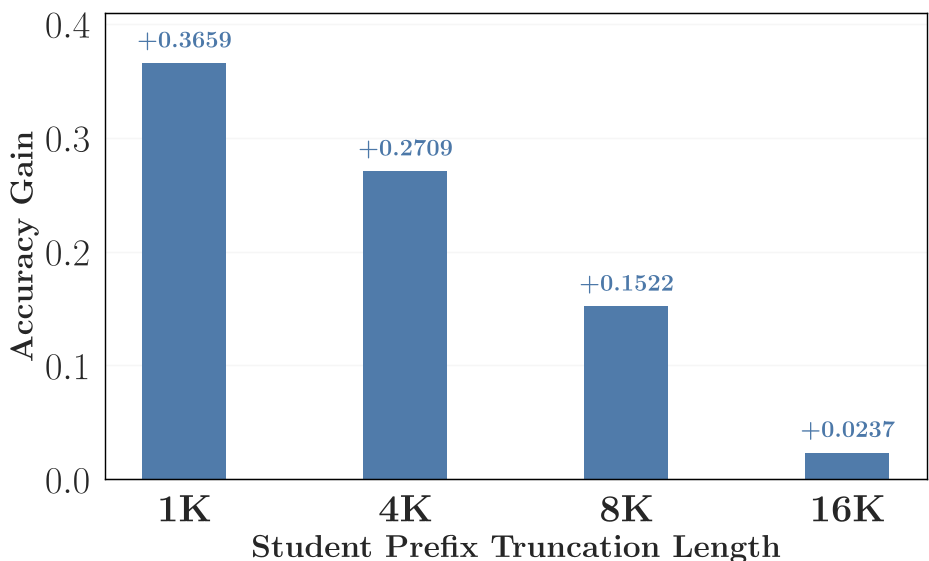 随着前缀长度增加,教师模型相比于学生的改进潜力(Accuracy Gain)迅速归零。
6. 总结
这篇论文撕掉了 OPD 的神秘面纱。它告诉我们,在线策略蒸馏不是万能药。在构建蒸馏流水线时,选择一个“思维频率”相近的教师,或者通过 SFT 预热来建立“共识”,比单纯追求教师的规模更加重要。对于未来迈向超长链式推理(Long-horizon Reasoning)的研究,如何解决长序列下的奖励漂移,将是下一个关键战场。