
[MergeRAG] 告别 Top-k 截断:将 RAG 从“筛选”进化为“动态合成”
Rethinking Retrieval-Augmentation as Synthesis: A Query-Aware Context Merging Approach
本文提出了 MergeRAG,一种将检索增强生成(RAG)从传统的“检索-选择”范式转变为“检索-合成”范式的创新框架。通过查询感知的上下文合并机制,MergeRAG 在有限的 Token 预算下通过对称和非对称合并显著提升了信息密度。
TL;DR
传统的 RAG 就像是在一大堆拼图碎片中只捡起最清楚的几块(Top-k),却往往丢掉了拼接真相的关键边缘。MergeRAG 提出了一种全新的思路:不再是生硬地挑选切片(Chunks),而是利用 LLM 作为一个高效的“裁缝”,将分散的、冗余的信息通过**查询感知(Query-Aware)**的方式缝合成高密度的上下文。实验表明,这种方法在多步推理任务中将 F1 分数提升了高达 13.7 点。
背景定位:RAG 的“信息瓶颈”之困
在学术界,RAG 一直被视为解决 LLM 幻觉和知识时效性的利器。然而,受限于模型有限的上下文窗口(Context Window),研究者们被迫在“信息充足性”和“Token 消耗”之间做平衡。现有的 Top-k 贪心选择策略本质上是子优的(Suboptimal):
- 长尾证据丢失:复杂的推理往往依赖于多个低分切片中的蛛丝马迹。
- 语义冗余浪费:排名前几的文档可能都在说同样的话,白白占用了 Token 位。
MergeRAG 首次将这一问题形式化为基于信息瓶颈(Information Bottleneck)理论的率失真优化问题(Rate-Distortion Optimization)。
核心机制:Symmetric & Asymmetric 合并
MergeRAG 的核心在于它不把切片看作不可变的原子,而是可重塑的原材料。
1. 对称合并 (Symmetric Merging):弱信号补强
针对那些单个看起来相关性不高但蕴含关键信息的“长尾”切片,MergeRAG 将它们成对融合。这不是简单的拼接,而是引导 LLM 提取能回答 Query 的共同事实。
- 直觉:两个 0.5 的信号合成后,其对答案的贡献度可能远超 1.0。
2. 非对称合并 (Asymmetric Merging):熵导向去重
针对冗余问题,MergeRAG 利用条件负对数似然 (NLL) 来评估切片间的重叠度。如果有切片 A 的内容在切片 B 的语境下极易被预测(低熵),那么 A 就是冗余的。
- 锚定策略:选择一个高分切片作为“锚点”,将低分冗余切片中的独特细节并入锚点,随后删除冗余件。
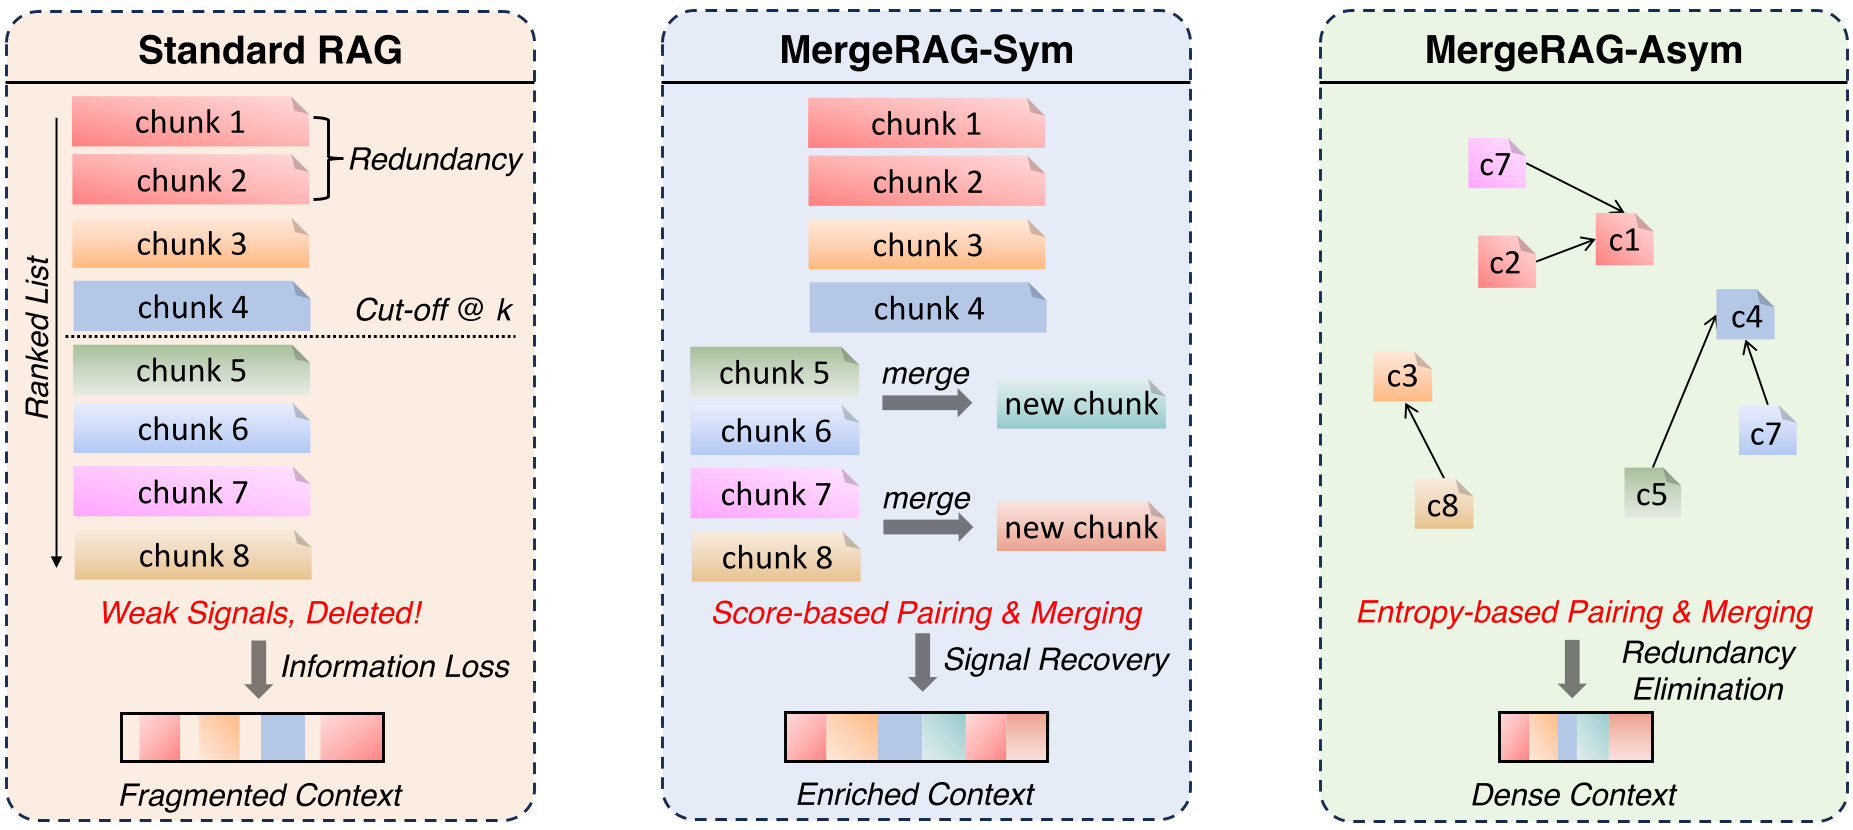 图 1:标准 RAG 流程与 MergeRAG 合并流程的对比
加速利器:分层并行合并 (Hierarchical Parallel Merging)
顺序合并 N 个切片会导致极高的延迟(N-1 次推理)和严重的递归幻觉。 MergeRAG 借鉴了归并排序的思想,构建了一棵合并树:
- 并行化:GPU 可以同时处理同一层级的多个合并对。
- 低深度:将处理深度从 降至 ,有效限制了语义漂移。
实验战绩:多步推理的全面超越
在针对多步推理(Multi-hop Reasoning)的挑战性数据集 MuSiQue 和 2WikiMQA 上,MergeRAG 展现了统制级的表现。
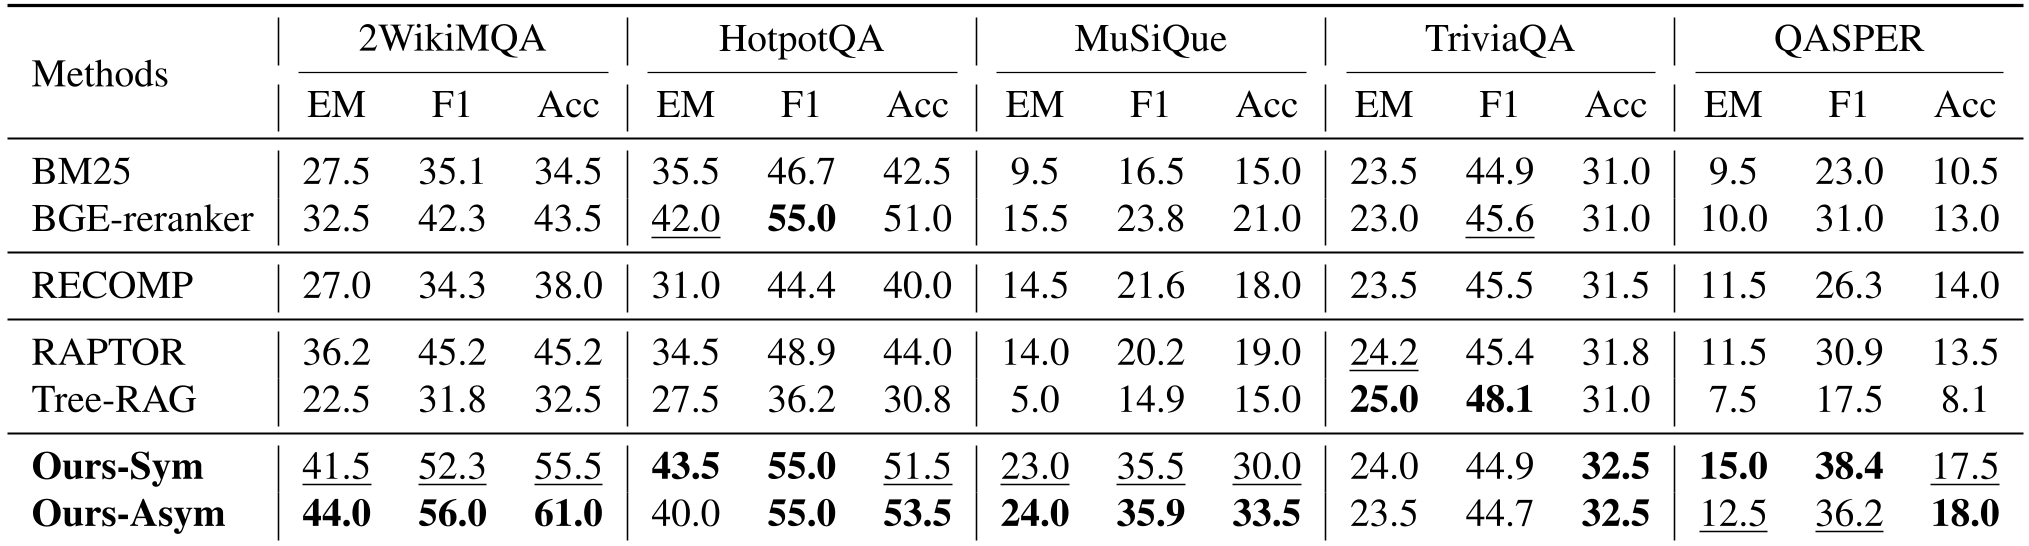 表 1:MergeRAG 在各个基准测试中的性能对比
关键结论:
- 极高效率:在仅使用 1/5 的 Token 预算下,MergeRAG 的准确率(Acc)依然能吊打全量输入的传统方法。
- 鲁棒性:即使只允许保留一个切片的长度(k=1),MergeRAG 也能通过预先合成多方信息,保持极高的 F1 分数,而传统 RAG 的性能则会腰斩。
深度洞察与总结
MergeRAG 的成功在于它深刻理解了 RAG 的本质不是“寻找答案的藏身之处”,而是“构建回答所需的逻辑链条”。
局限性分析:
- 计算开销:虽然引入了并行化,但相比于直接选择 Top-k,合并过程依然增加了预处理的推理开销。
- 依赖评分质量:合并对的选择高度依赖于 Reranker 的评分,如果初始召回质量太差,合成也难以“妙手回春”。
未来展望: 这种“以合成代筛选”的思路预示着 RAG 正在进入 2.0 时代——检索不再是结果,而只是模型重构知识的开始。
Takeaway:如果你在处理长文档 RAG 或多跳提问时面临上下文长度超标或准确度不足,MergeRAG 提供的动态合成策略是目前最值得尝试的研究方向。