
重新审视 LLM 不确定性:单序列度量 G-NLL 为何能击败复杂的采样方法?
Rethinking uncertainty estimation in natural language generation
本文提出了 G-NLL,一种基于 Single-sequence(单序列)的 LLM 不确定性估计方法。该方法通过理论证明,将最可能输出序列的 Negative Log-Likelihood (NLL) 作为不确定性度量,在多个问答任务中达到了 SOTA 性能,同时显著降低了计算开销。
TL;DR
长期以来,学术界普遍认为评估 LLM 的“自信程度”需要通过多次采样(Sampling)并观察输出的一致性来实现(如著名的 Semantic Entropy)。然而,来自 JKU Linz 的研究团队在本文中提出了反直觉的结论:仅仅使用一次 Greedy Decoding 生成的序列及其负对数似然(NLL),在理论和实证上都比复杂的多序列采样更可靠且高效。 这一方法被称为 G-NLL。
痛点深挖:昂贵且冗余的采样
评估自然语言生成(NLG)的不确定性之所以困难,是因为输出空间(YT)是指数级爆炸的。
- 计算成本:目前的 SOTA 方法(如 SE)通常需要采样 5-10 个序列,这意味着推理成本直接翻了 5-10 倍。
- 语义噪声:即使两个序列在 Token 级别不同,它们语义可能一致。以往方法试图通过 NLI 模型进行聚类来解决,但这又引入了额外的计算负担。
- 采样不稳定性:基于 Monte Carlo 采样的熵估计在高维空间下具有极高的方差(Variance)。
方法论:基于 Proper Scoring Rules 的物理直觉
作者通过 Proper Scoring Rules(适当评分规则) 框架重新推导了不确定性度量。
核心直觉
- Logarithmic Score:对应于我们熟悉的 Shannon Entropy。它关注的是整个概率分布的平衡性,计算时需要遍历(或采样近似)整个输出空间。
- Zero-one Score:对应于 Maximum Sequence Probability (MSP)。它只关注“最可能的那个序列”有多大把握。
作者证明,衡量 aleatoric uncertainty(偶然不确定性)时,使用 Zero-one Score 导出的 MSP 的负对数似然(NLL) 是一个理论完备且稳健的指标。
图注:不同评分规则下的不确定性分解,展示了从 Logarithmic Score 到 Zero-one Score 的演进。
G-NLL:极致的简洁
由于寻找全局最优序列是 NP-hard 问题,作者提出使用 Greedy Decoding(贪婪解码) 得到的 Token 序列概率之和作为近似。这不仅免去了采样的麻烦,而且与 LLM 现有的推理流程完美兼容。
实验与战绩:少即是多
研究人员在 Llama-3.1 系列(Transformer 架构)和 Falcon Mamba(状态空间模型架构)上进行了深度评测。
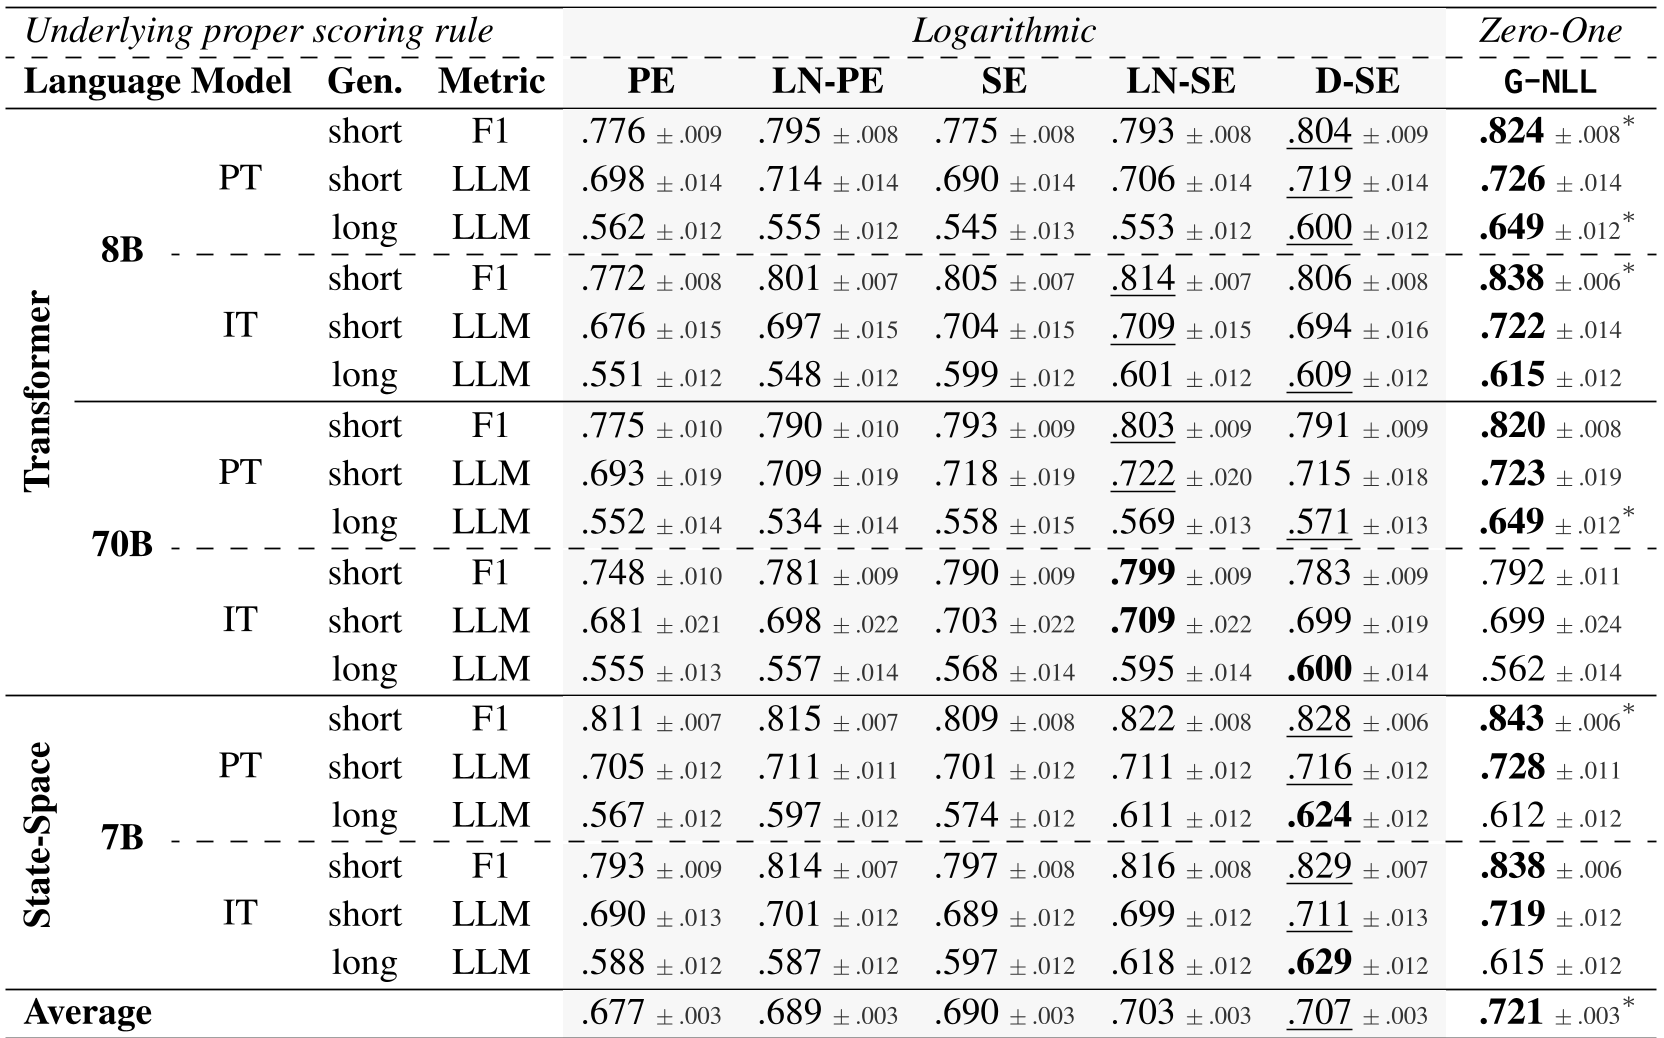 表 1:G-NLL 与各种基线方法(PE, SE, D-SE 等)在不同模型和任务下的 AUROC 对比。
关键发现:
- 全面超越:在 18 个实验场景中的 13 个,G-NLL 都优于需要 10 次采样的 Semantic Entropy。
- 无需长度归一化:出人意料的是,不经过长度归一化的 G-NLL 效果更好,因为累加的 Log-probs 能更敏锐地捕捉到序列中出现的低信心 Token。
- 确定性与超参无关:G-NLL 是确定性的,不需要像采样方法那样去调 Temperature 等超参数。
深度洞察:为什么单序列反而更准?
作者通过理论分析(Theorem 1)揭示了本质:
- 采样复杂度(Sample-Complexity):估计 Shannon Entropy 的样本需求量取决于整个分布的范围和最坏情况下的权重平衡;而估计 MSP 则仅取决于最可能序列附近的局部集中度。
- 在 LLM 的实际应用中,分布往往高度集中在少数几个高频序列上,因此关注“领头羊”的确定性比去统计“长尾”序列的分布要高效得多。
局限性与未来展望
虽然 G-NLL 在问答任务中表现卓越,但它尚未显式地考虑语义(Semantics)。作者指出,如何以极低的成本将语义一致性融合进单序列提取中,是下一个研究风口。
总结
G-NLL 的出现为大规模部署 AI 的不确定性监控提供了“免费的午餐”。它告诉我们:有时候,最简单的物理量(NLL)在正确的数学框架(Proper Scoring Rules)指引下,往往比复杂的启发式算法更接近真理。