
sLA-tKGF:当 RAG 遇见“白板”训练,时序知识图谱预测的新高峰
Retrieval-Augmented Generation Meets Data-Driven Tabula Rasa Approach for Temporal Knowledge Graph Forecasting
本文提出了 sLA-tKGF 框架,一种专为时序知识图谱(tKG)预测设计的检索增强生成(RAG)方案。该方法弃用预训练大模型直接预测,转而采用“白板(Tabula Rasa)”策略,从零训练小型语言模型,并结合 tKG 历史数据、Web 实时搜索及大模型生成的语义描述进行 Zero-shot 预测,在多个基准数据集上达到 SOTA 性能。
TL;DR
在 AI 预测领域,预训练大模型(PLLMs)虽然博学,但在时序知识图谱(tKG)预测中却常因“幻觉”和“偷看答案(数据泄露)”而翻车。本文介绍的 sLA-tKGF 框架,通过从零训练小型语言助手,并利用高效的 RAG(检索增强生成)管道整合图谱历史、实时网页与语义总结,不仅彻底解决了泄露问题,还在预测精度上将现有基线提升了一倍以上。
背景定位与痛点:大模型的“时间焦虑”
时序知识图谱(tKG)描绘了实体关系随时间演进的动态过程。预测未来的 quadruples 是业界难题。
- 幻觉与过时:PLLMs 无法实时更新其参数,面对突发事件极易产生幻觉。
- 数据泄露(Data Leakage):这是一个隐形杀手。闭源模型在训练时可能已经见过测试集中的“未来事实”,导致评估结果虚高。
- 长尾挑战:当出现全新的实体(Zero-shot 问题)或非均匀的时间跨度时,传统基于嵌入(Embedding)的方法往往失效。
核心机制:sLA-tKGF 的三支柱 RAG
sLA-tKGF (small-scale language assistant for tKG forecasting) 的核心逻辑是:“大模型出知识,小模型做决策”。
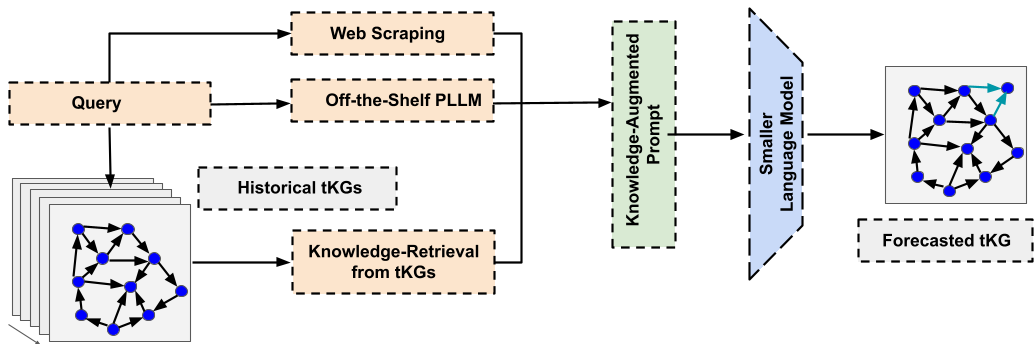
1. 结构化历史检索(HKR)
框架不仅检索与主体(Subject)相关的历史事实,还根据语义相似度过滤掉噪声。它将图谱数据“口语化”,例如将 转化为自然语言查询。
2. 带有“时间墙”的 Web 检索
为了获取实时上下文,框架引入了 Web Scraping。关键在于时间去敏:通过时间标注技术,严格剔除目标时间点 之后的网页信息,确保预测的公平性。
3. “白板”训练的小模型
不同于直接微调 Llama,作者从 scratch(从零)训练了一个小型 Transformer。通过“Tabula Rasa”策略,模型被迫学会依靠 Prompt 中的上下文进行逻辑推理,而非记忆训练数据中的事实。
实验战绩:全线霸榜
在 ICEWS 系列、YAGO 和 WIKI 等权威数据集上,sLA-tKGF 展现了统治级的性能。
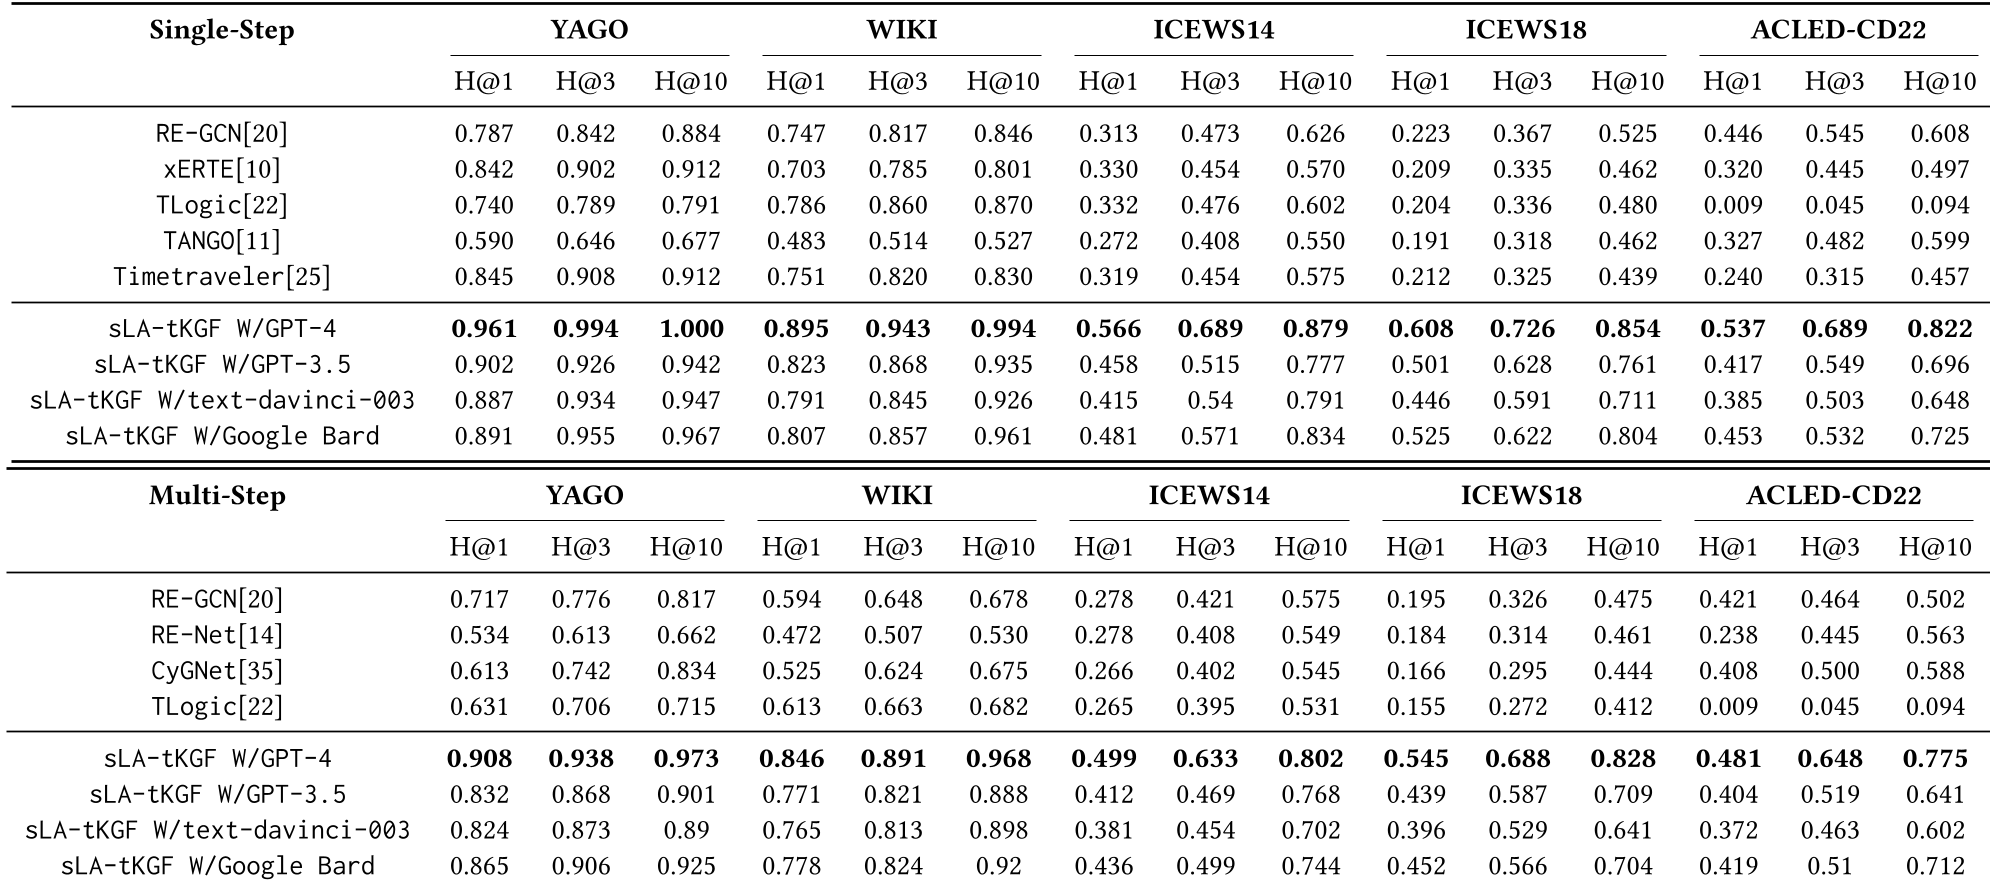
- 性能跨越:在 ICEWS18 上,该方法的 Hits@1 达到 0.608,对比之前的强力对手 RE-GCN(0.223)和 TLogic(0.204),实现了量级的跨越。
- 长程预测稳定性:即便将预测窗口拉长到 8 天,sLA-tKGF 依然能保持较高的准确率(Hits@10 保持在 85% 以上),显示出极强的鲁棒性。
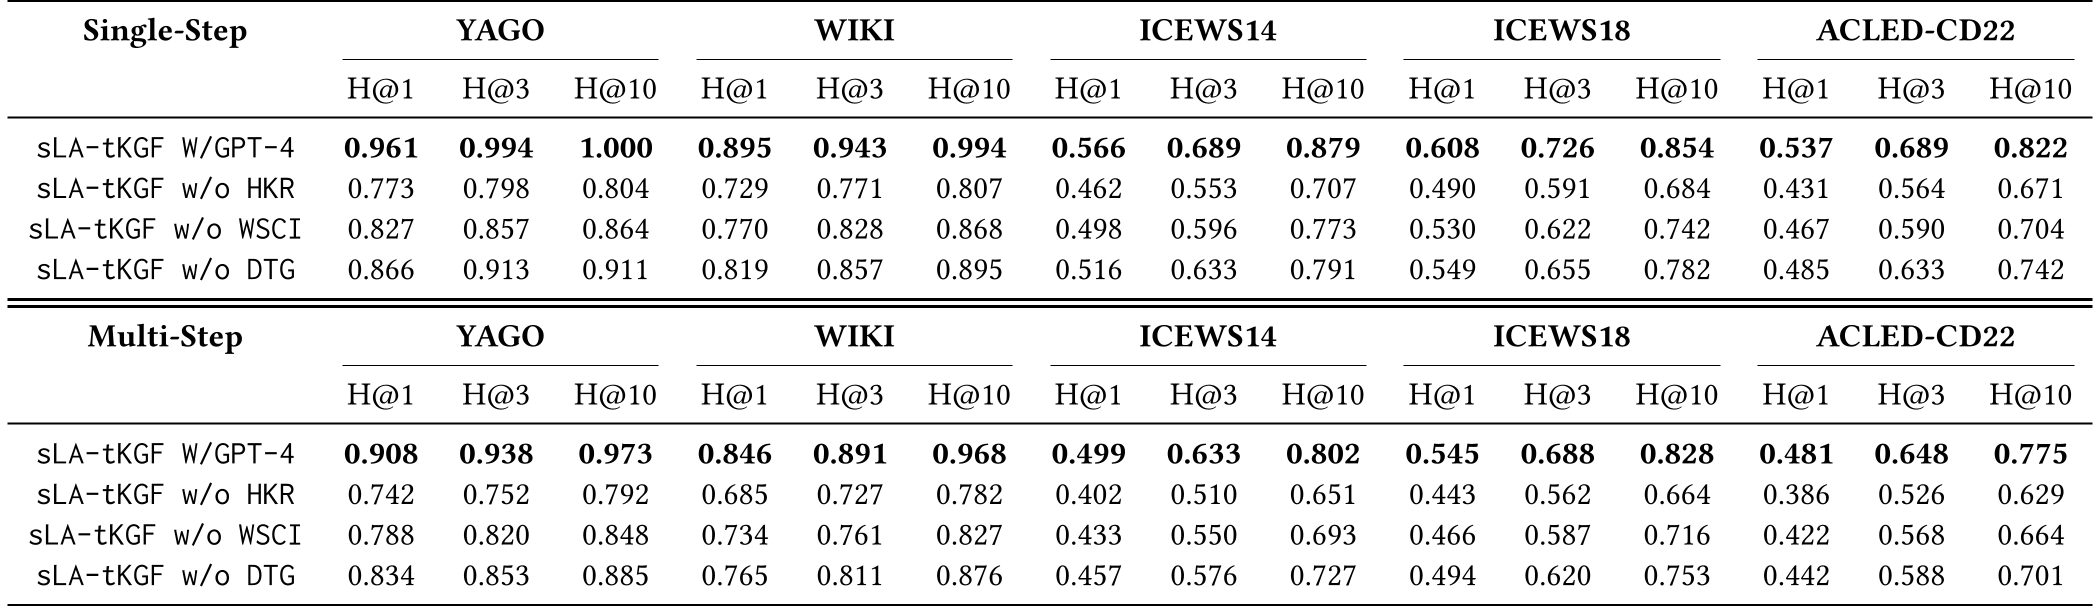
- 消融实验验证:如下表所示,去除任何一个 RAG 组件(历史数据、Web 搜索或语义总结)都会导致性能显著下降,证明了多源知识融合的必要性。
深度洞察:为什么这种做法更有效?
- Inductive Generalization(归纳泛化):由于小模型不依赖记忆实体 ID,而是理解 Prompt 中的文本描述,因此在处理训练集中从未见过的新实体(Inductive Link Prediction)时,sLA-tKGF 依然能够凭借网页和 PLLM 的背景知识给出正确预测。
- 时间序列感:论文通过实验发现,如果打乱 Prompt 中事实的顺序或移除时间戳,性能会急剧下降。这说明基于 Transformer 的小模型确实捕捉到了事实演进的序列特征。
- 效率与精准的平衡:配置 25 个历史窗口事实能达到 MRR 与计算开销的最佳平衡点。
总结与局限
sLA-tKGF 为我们展示了一个极具吸引力的方向:不再迷信超大规模模型在垂直领域的直接表现,而是将其作为高质量的“特征提取器”或“知识库”,驱动轻量化、可追溯的小型模型进行最终任务执行。
未来展望:目前的框架仍依赖外部 PLLM 的调用(如 GPT-4),这在工业实时预测中可能存在延迟和隐私成本。未来如何将这种三源 RAG 能力完全集成到本地轻量化模型中,将是极具潜力的研究方向。