
Auepora:拆解 RAG 评估的“黑盒”,构建大规模语言模型的度量衡
Evaluation of Retrieval-Augmented Generation: A Survey
本文提出了 Auepora (A Unified Evaluation Process of RAG),这是一个针对检索增强生成(RAG)系统的统一评估流程框架。该研究系统总结了当前 RAG 评估在检索、生成及全系统层面的挑战,并对 12 种主流评估工具(如 RAGAs, ARES)及其数据集、指标进行了深度对比探索。
TL;DR
随着大语言模型(LLM)与检索增强生成(RAG)技术的深度融合,如何准确评估一个 RAG 系统的好坏成了工业界的头号难题。本文提出的 Auepora 框架,通过对“检索”与“生成”两大组件的解耦与重构,提供了一套从目标定位到数据集构建、再到量化指标的完整方法论。它是目前该领域最全面的综述与基准指南之一。
痛点深挖:为什么 RAG 评估这么难?
传统的全量微调评估往往只看长文本的困惑度(Perplexity),但 RAG 是一个杂合系统。它面临着以下独特挑战:
- 检索的动态性:外部知识库是实时更新的,传统的静态测试集(如 SQuAD)无法验证模型处理“最新消息”的能力。
- 逻辑的脆弱性:即使检索到了正确文档,模型也可能产生“忠实度”问题(即回答不符合检索到的上下文)。
- 系统的耦合性:检索组件的微小误差(如 Top-K 检索中包含噪声)可能在生成阶段被无限放大。
Methodology:Auepora 统一评估框架
作者提出的 Auepora 框架核心直觉在于:所有评估本质上都是“输出”与“参照系(Ground Truth)”之间的配对。
1. 评估目标 (Target)
Auepora 将 RAG 拆解为三个评估对:
- 检索端:关注
Query ↔ Relevant Documents的相关性。 - 生成端:关注
Response ↔ Relevant Documents的忠实度 (Faithfulness) 以及Response ↔ Ground Truth的正确性。 - 全系统:关注噪声稳健性、负向拒绝(当检索不到答案时闭嘴)以及反事实稳健性。
2. 模型架构与评估流程
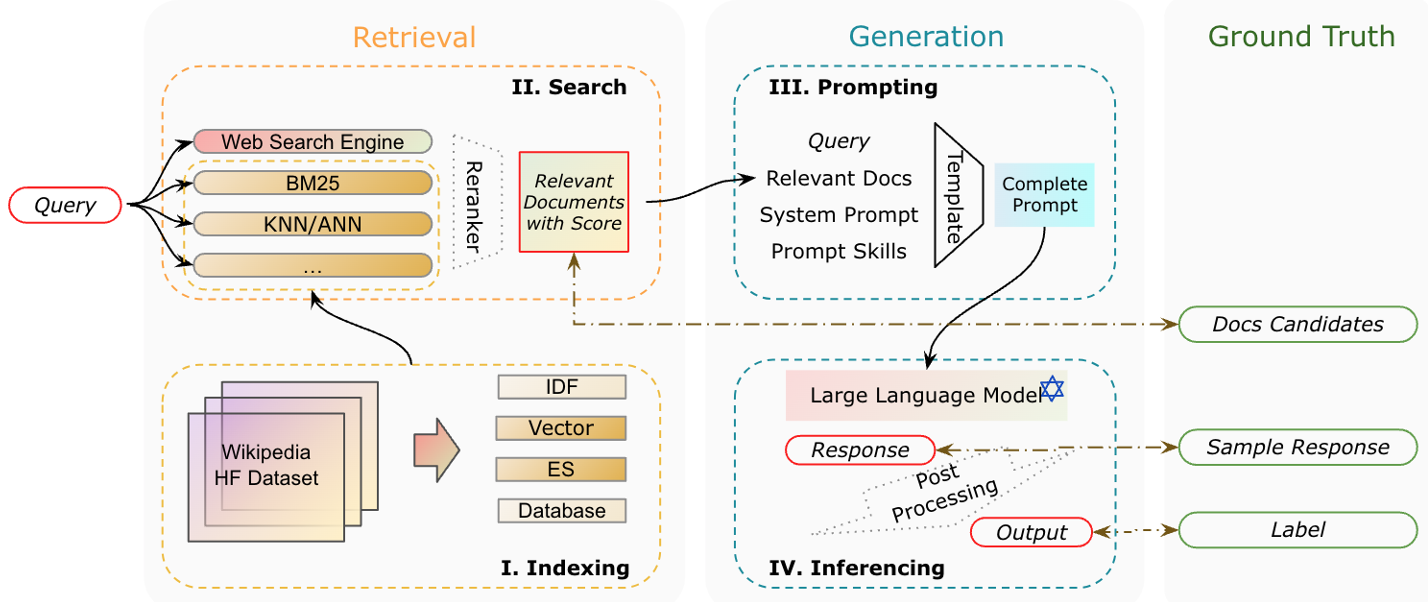 图 1:展示了 RAG 从 Indexing 到 Inference 的全生命周期,及其对应的评估锚点。
核心指标:从词法重合到语义判官
博客在此重点分析文中提到的评估演进趋势:
传统指标的局限
BLEU 和 ROUGE 等指标在 RAG 场景下表现乏力,因为它们只关注词汇重合。如果模型用同义词给出了完美回答,这些指标可能会给出极低的分数。
“LLM-as-a-Judge” 的兴起
文中高度评价了利用 GPT-4 等强模型作为“裁判”的做法。这种方式能够识别语义逻辑,甚至能给出 1-5 分的精细化评分。
| 框架 | 检索评估指标 | 生成评估指标 | 核心特色 |
|---|---|---|---|
| RAGAs | LLM as a Judge | 忠实度、答案相关性 | 自动化程度高 |
| ARES | LLM + 分类器 | 答案忠实度 | 引入 PPI 减少统计偏差 |
| RGB | - | 噪声稳健性、拒绝率 | 关注系统压力测试 |
实验洞察与关键结果
论文对比了 12 种框架,发现现在的趋势是数据集生成的自动化。利用 LLM 针对特定领域(如医疗 MedRAG 或大学招生 DomainRAG)自动生成 QA 对,已成为构建 benchmark 的主流方案。
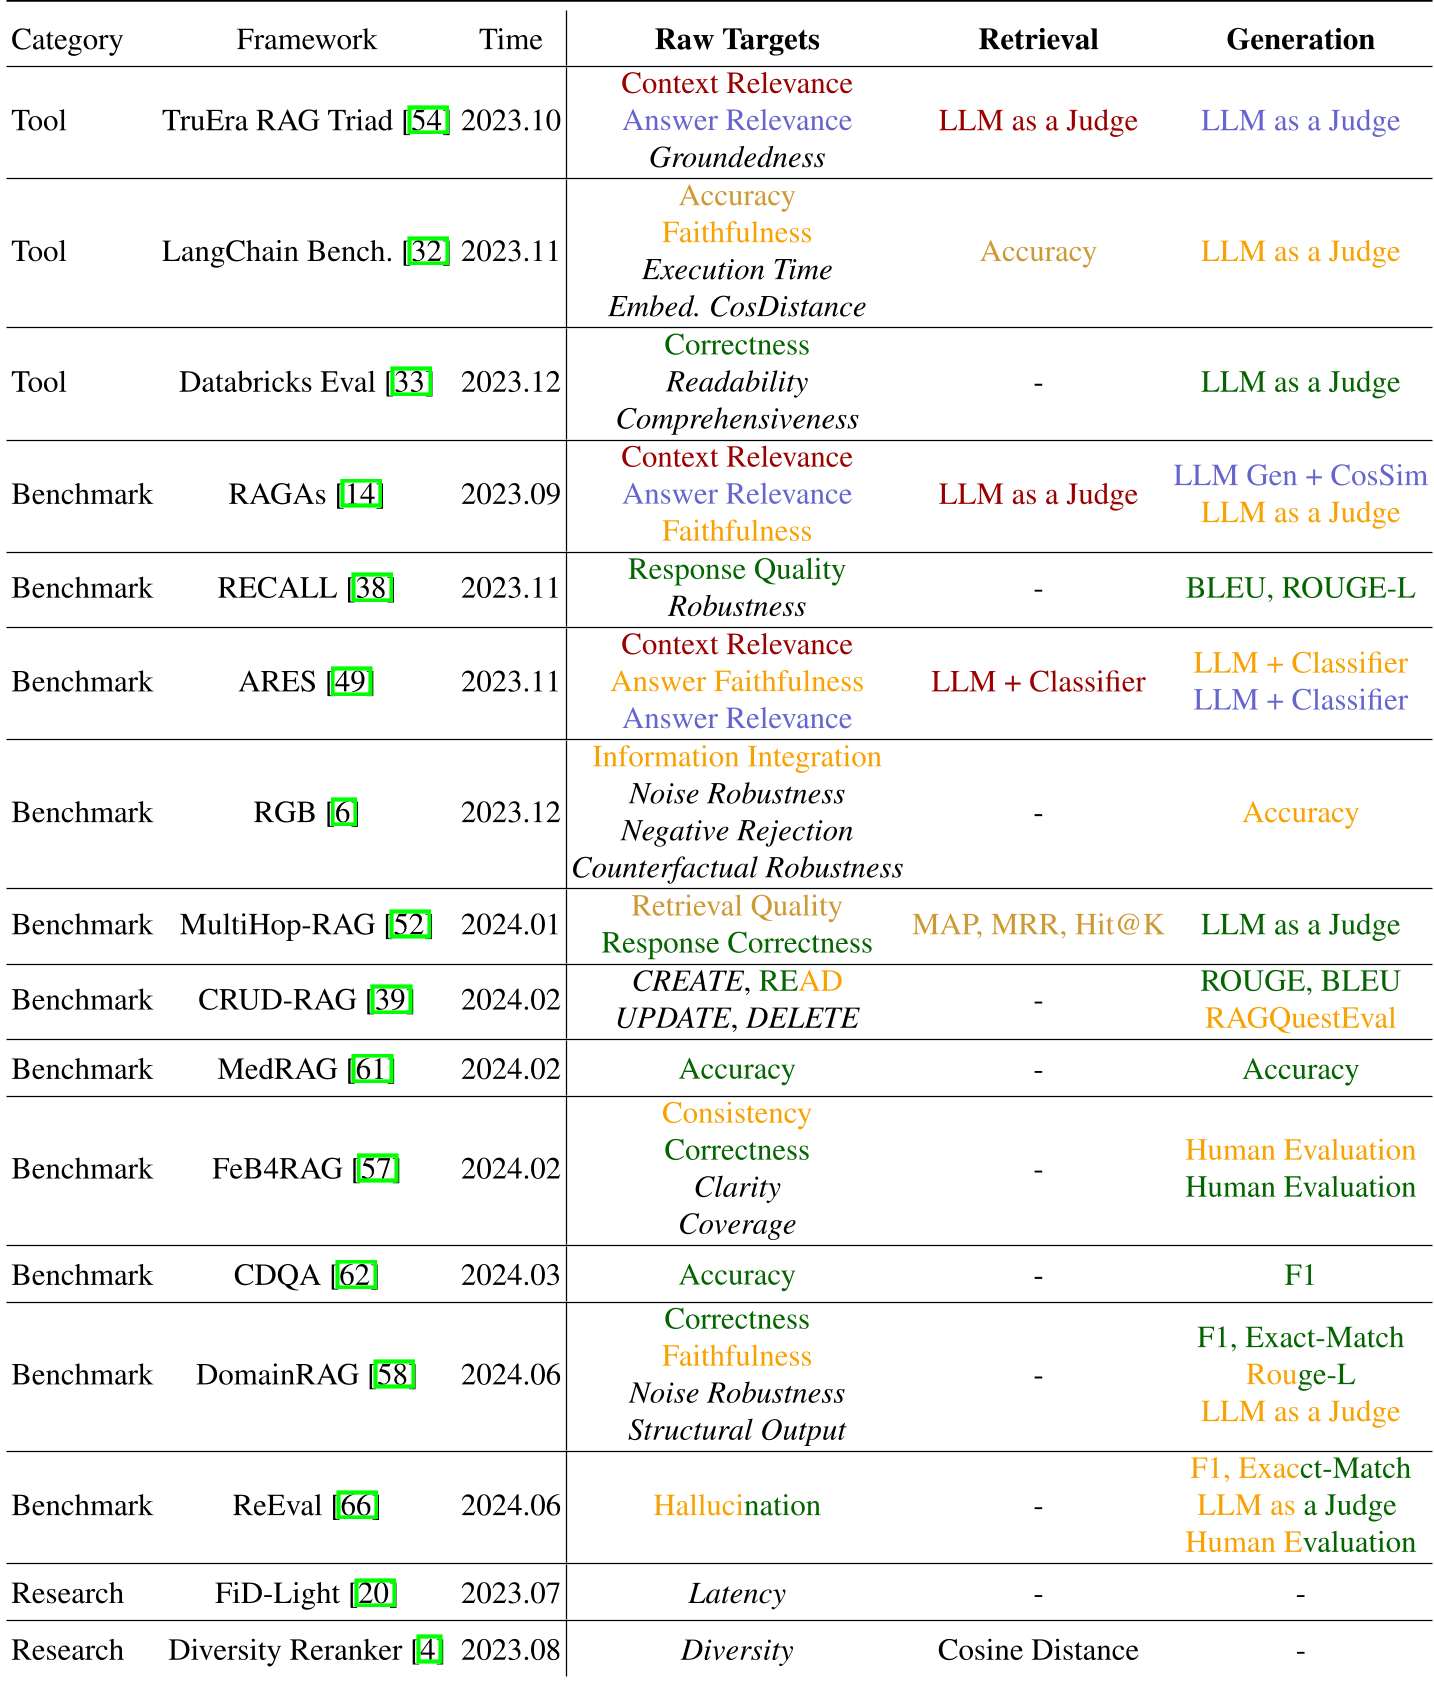 表 1:总结了各主流框架在检索和生成两个维度的侧重点。
深度洞察与总结
Takeaway
RAG 评估不再是单一的 Accuracy 指标。一个优秀的 RAG 系统必须具备高忠实度(不胡编乱造)、高相关性(找得准)以及低延迟。
局限性与未来
- 开销问题:使用 LLM 作为裁判虽然准,但 API 调用成本极高。
- 偏差问题:LLM 裁判可能存在自恋偏差(倾向于给自己生成的文本打高分)。
- 未来展望:开发更轻量化的判别模型,以及针对多跳(Multi-hop)推理建立更复杂的长链评估集,将是下一个技术高地。
结论:Auepora 不仅仅是一个综述,它为开发者提供了一份 RAG 系统的“体检报告”模板。如果你正在构建工业级 RAG 应用,本文提及的“负向拒绝”和“反事实稳健性”应该是你上线前的必测项。