
RivuletMLP:重塑 MLP 潜力,实现超高效压缩视频画质增强
RivuletMLP: An MLP-based Architecture for Efficient Compressed Video Quality Enhancement
本文提出了 RivuletMLP,一种基于 MLP 架构的高效压缩视频质量增强网络。该方法通过引入动态引导可变形对齐(DDA)、时空特征流(SFF)和良性选择补偿(BSC)模块,在 MFQEv2.0 数据集上取得了 SOTA 性能,同时显著降低了计算复杂度。
TL;DR
在视频流媒体爆发的今天,如何在有限带宽下平衡压缩比与画质是行业痛点。传统的 CNN 或 Transformer 方案往往在“性能”与“效率”间反复横跳。由西电与蚂蚁集团联合提出的 RivuletMLP 给出了一份近乎完美的答卷:利用纯 MLP 架构,通过创新的特征流排列机制,在仅需传统方法 1/3 计算量的情况下,实现了更强的全局建模能力与画质恢复效果。
痛点深挖:为何视频恢复这么难?
视频压缩后的画质退化呈现出复杂的时空特性。
- 空间维度的全局相关性:压缩伪影(如块效应、环状伪影)往往跨越较大的像素空间,CNN 固有的局部感受野难以有效覆盖。
- 时间维度的运动不连续性:帧间运动估计与量化过程会导致时间轴上的纹理闪烁。
- 计算成本瓶颈:虽然 Transformer 模型(如 Swin-CNN)效果卓越,但其 Attention 机制的平方级复杂度让实时推理成为奢望。
核心方法论:RivuletMLP 的三大武器
1. DDA:动态引导的可变形对齐
常规的对齐方法在面对大运动或严重伪影时容易产生偏离。RivuletMLP 引入了 Dynamically Guided Deformable Alignment (DDA)。
- 直觉:通过 U-Net 结构的轻量化偏移网络获取时空位移,避免了误差在帧间传播。
- 架构优势:实现了自适应的多帧特征对齐,为后续重建打下了坚实的特征基础。
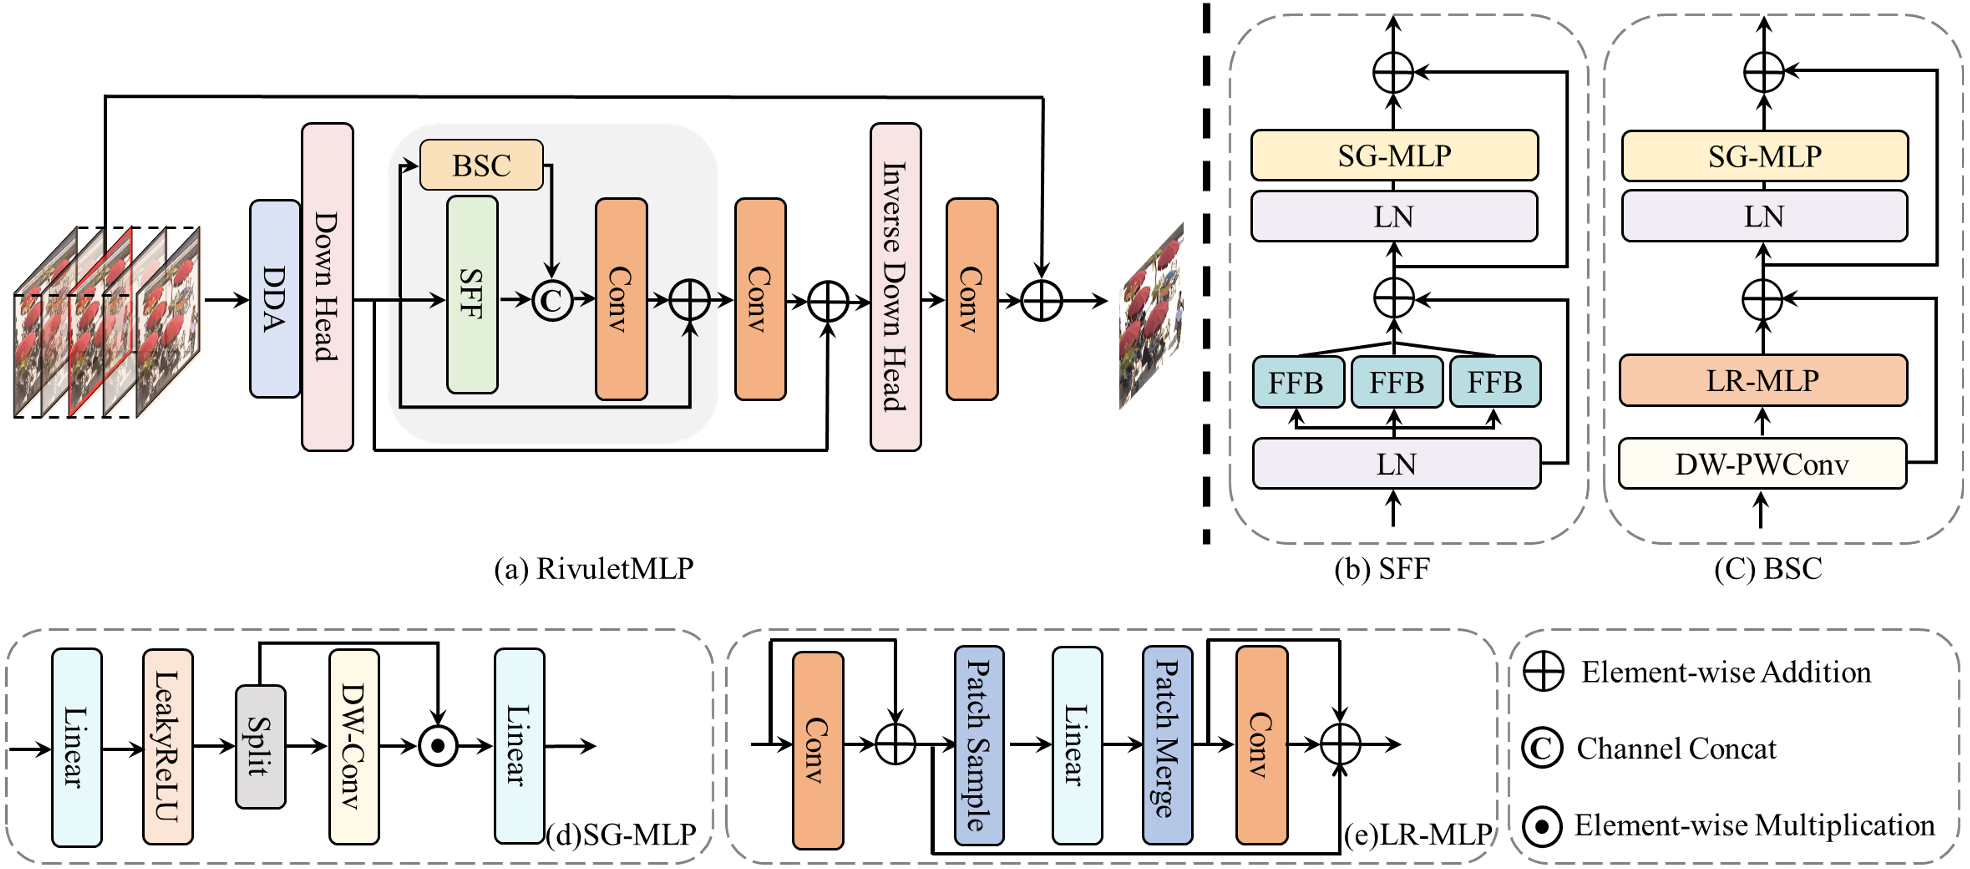 图 2:RivuletMLP 总体架构,包含 DDA、SFF 与 BSC 三大模块。
2. SFF:时空特征流(Spatio-temporal Feature Flow)
这是本文最精妙的创新。为了克服传统 MLP 处理长距离依赖的弱点,作者提出了 SFF 模块。
- 特征排列机制:通过“窗口划分 -> 特征映射 -> 圆周排列 -> 窗口合并”的流程,将原本处于感受野之外的远端特征“搬运”到当前计算单元内。
- 物理直觉:这种做法类似于在数据矩阵中铺设了“高速公路”,让非局部的特征能够跨空间直接进行交互,从而低成本地构建了全局感受野。
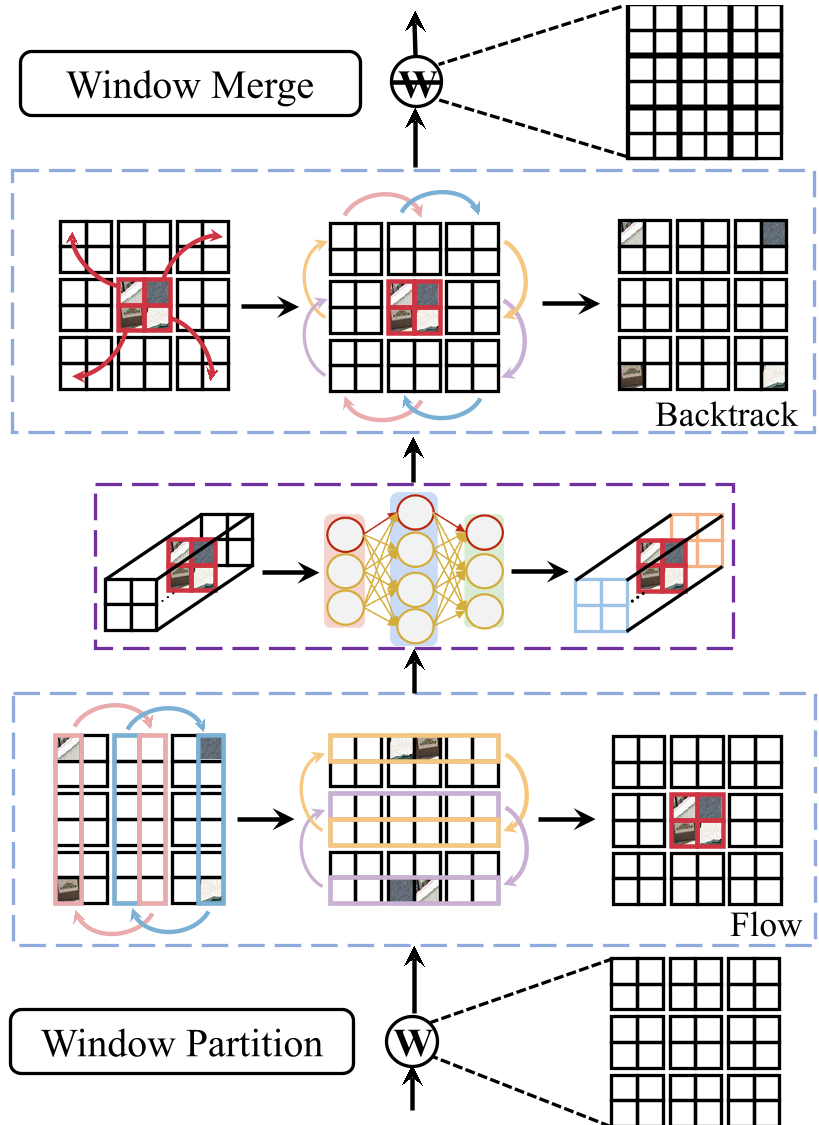 图 4:FFB 组件通过特征重组打破固定感受野限制。
3. BSC:良性选择补偿(Benign Selection Compensation)
SFF 负责全局,而 BSC 负责细节补偿。它利用 DWConv 和重叠区域的微型 MLP(LR-MLP)针对性地修复运动造成的纹理断裂。
实验战绩:效率与画质的双重飞跃
定量分析
在 MFQEv2.0 标准榜单上,RivuletMLP 在各个压缩强度下均霸榜。
- 性能提升:相比 STCF,PSNR 提升了 0.11dB。
- 效率优势:计算量(FLOPs)从 1677.1G 降至 615.7G,推理帧率(FPS)提升了 3.5 倍 以上。
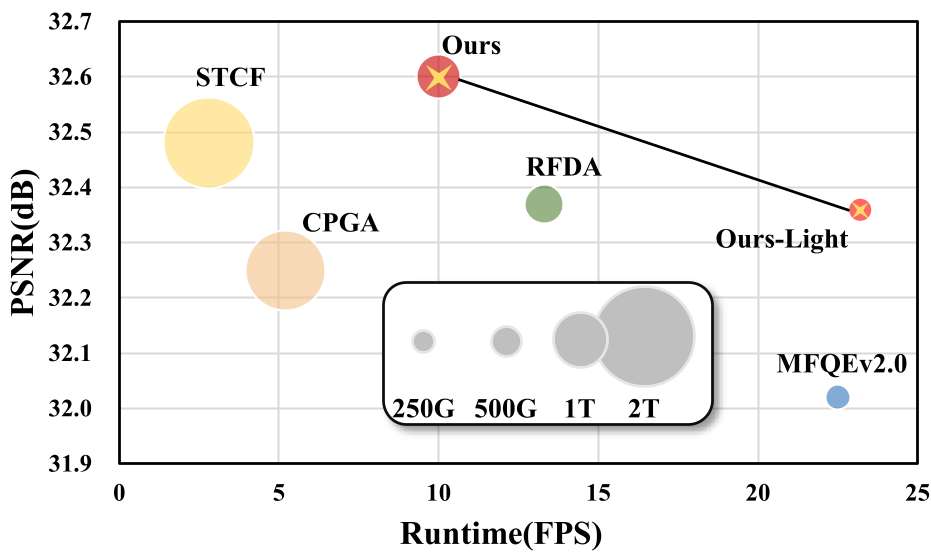 图 1:性能、计算量与推理速度的帕累托前沿对比。
定性对比
从视觉效果看,RivuletMLP 能够更准确地恢复物体边缘(如篮球视频中的线条)并有效抑制背景纹理的闪烁,且生成的图像边缘更加清晰,没有传统 CNN 容易产生的模糊感。
深度洞察
RivuletMLP 的成功再次证明了:网络的归纳偏置(Inductive Bias)设计比堆砌算力更重要。通过手动的“特征排列”模拟 Transformer 的全局交互,既保留了线性计算的高效,又获得了非局部的建模精髓。这为短视频、在线直播等对画质与延迟都有极高要求的实时场景提供了一种非常成熟的商用模型思路。
局限性与展望
尽管 RivuletMLP 表现优异,但其参数量(Params)与 Transformer 方案相当(约 6.9M),在移动端超轻量化部署上仍有压缩空间。未来,将这种“特征流”思想引入到 H.266/VVC 等新一代编码标准的后处理中,将是极具前景的研究方向。