
RLDX-1:跨越通用智能,赋予人形机器人全方位的“灵巧机能”
RLDX-1 Technical Report
RLWRLD 与 KAIST 联合发布了 RLDX-1,一个通用的视觉-语言-动作(VLA)模型,旨在通过 Multi-Stream Action Transformer (MSAT) 架构统一处理多种异构模态。该模型在 ALLEX 人形机器人任务上取得了 86.8% 的成功率,显著超越 π0.5 和 GR00T N1.6 等当前 SOTA 基线。
TL;DR
机器人领域的“GPT时刻”不仅需要模型懂语言和图像,更需要它具备运动直觉、长期记忆和物理触感。RLWRLD 团队推出的 RLDX-1 技术报告展示了一个全能型 VLA 模型,通过 Multi-Stream Action Transformer (MSAT) 架构,成功地在人形机器人上统一了运动感知、长程推理和物理反馈。在最具挑战性的 ALLEX 人形机器人任务中,它将成功率从基线模型的 40% 提升至近 90% 的工业级水平。
核心定位:从 Versatile 到 Functional
目前大部分 VLA 模型(如 OpenVLA, π0)擅长的是“通用性”——能认出苹果、能听懂指令。但 RLDX-1 的主编认为,这只是“脑子灵”,真正下地干活需要的是“手精准”。RLDX-1 针对性地填补了三个功能性大坑:
- 运动感知 (Motion Awareness):不在只盯着静态帧,能看懂传送带上物体的移动轨迹。
- 长期记忆 (Long-term Memory):记得几分钟前物体被藏在了哪个盒子里(如 Shell Game)。
- 物理感知 (Physical Sensing):在视觉遮挡下,靠触觉和扭矩传感器感知插入深度或抓取力度。
架构解析:Multi-Stream Action Transformer (MSAT)
RLDX-1 的核心是一个基于 Flow-matching 的扩散 Transformer(Action Model)。
- 异构模态流:与其将所有东西强行拼成一个向量,MSAT 为认知特征(C)、动作特征(A)和物理信号(P)分配了独立的处理流。
- 联合自注意力:在各个流内部处理后,通过跨模态注意力进行交互。这样既保留了触觉信号的超高精度,又利用了 VLM 的语义能力。
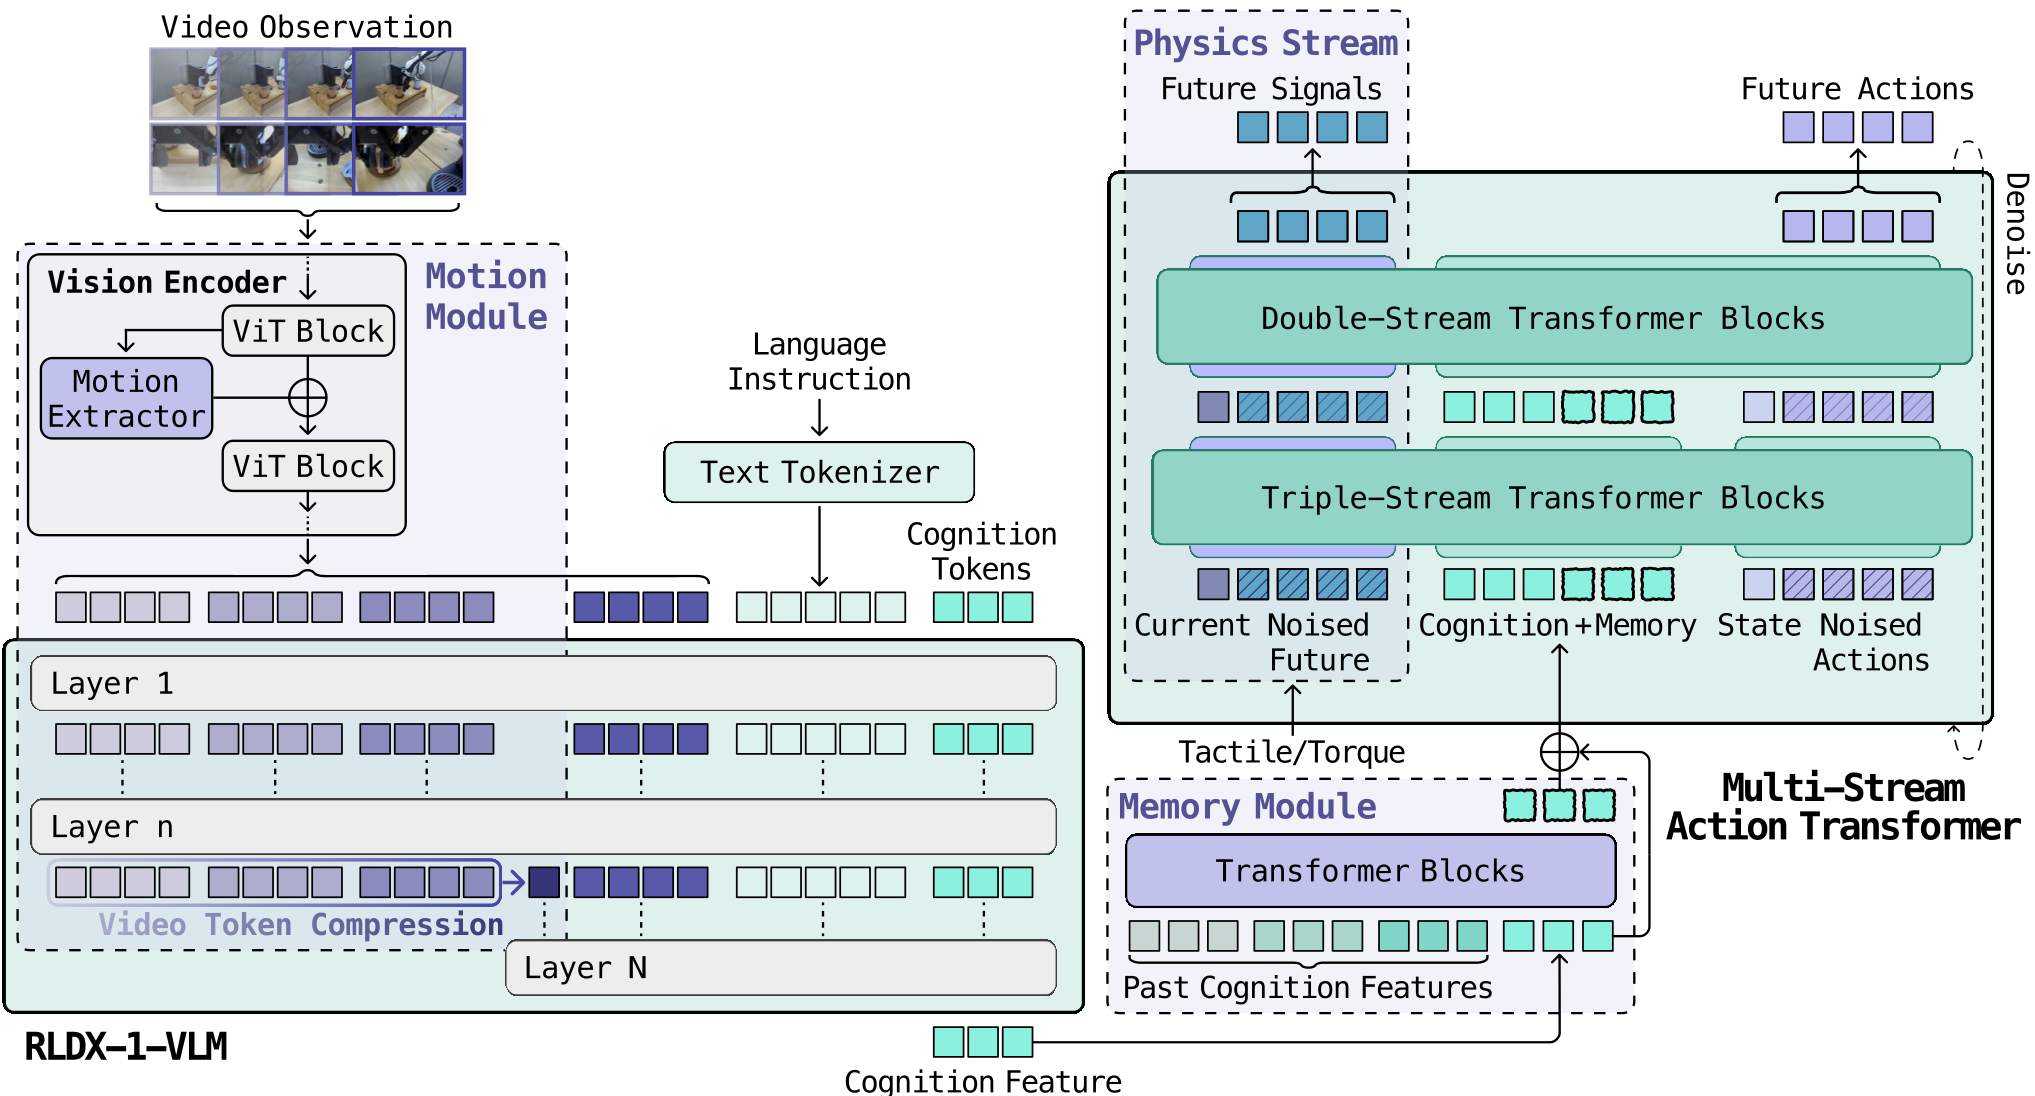 图 1:RLDX-1 的模型架构。左侧为基于 Qwen3-VL 改造的 Cognition 模块,右侧为多流动作解码器。
突破性的“数据内功”:合成与一致性过滤
要在真机上训练 48 自由度的人形机器人,真实数据永远不够。RLDX-1 建立了一套极其严苛的合成数据管线:
- 运动一致性过滤:不仅生成视频,还会用逆动力学模型(IDM)反推动作,然后在模拟器中“试跑”。只有预估动作跑出来的效果和生成视频一致的数据,才能进训练集。
- 三阶段进阶:
- Pre-training:在 150 万个跨机体案例上粗练。
- Mid-training:在 ALLEX 人形机体上针对性注入记忆和物理感知。
- Post-training:通过 RECAP 强化学习算法,利用 VLM 充当“评论家(Critic)”进行最后 1 英里的性能冲刺。
实验战绩:全方位的碾压
在模拟器(LIBERO, RoboCasa)和真机实验中,RLDX-1 表现出了极强的韧性。
- ALLEX 真机挑战:在涉及长期记忆的“盒子选物”任务中,RLDX-1 几乎满分,而基线模型 π0.5 表现得像在随机乱猜。
- 物理手感控制:在“灯泡螺旋拧入”任务中,由于引入了扭矩反馈,RLDX-1 的尝试次数比纯视觉 BC 减少了 3 倍,效率甚至超越了人类遥操作。
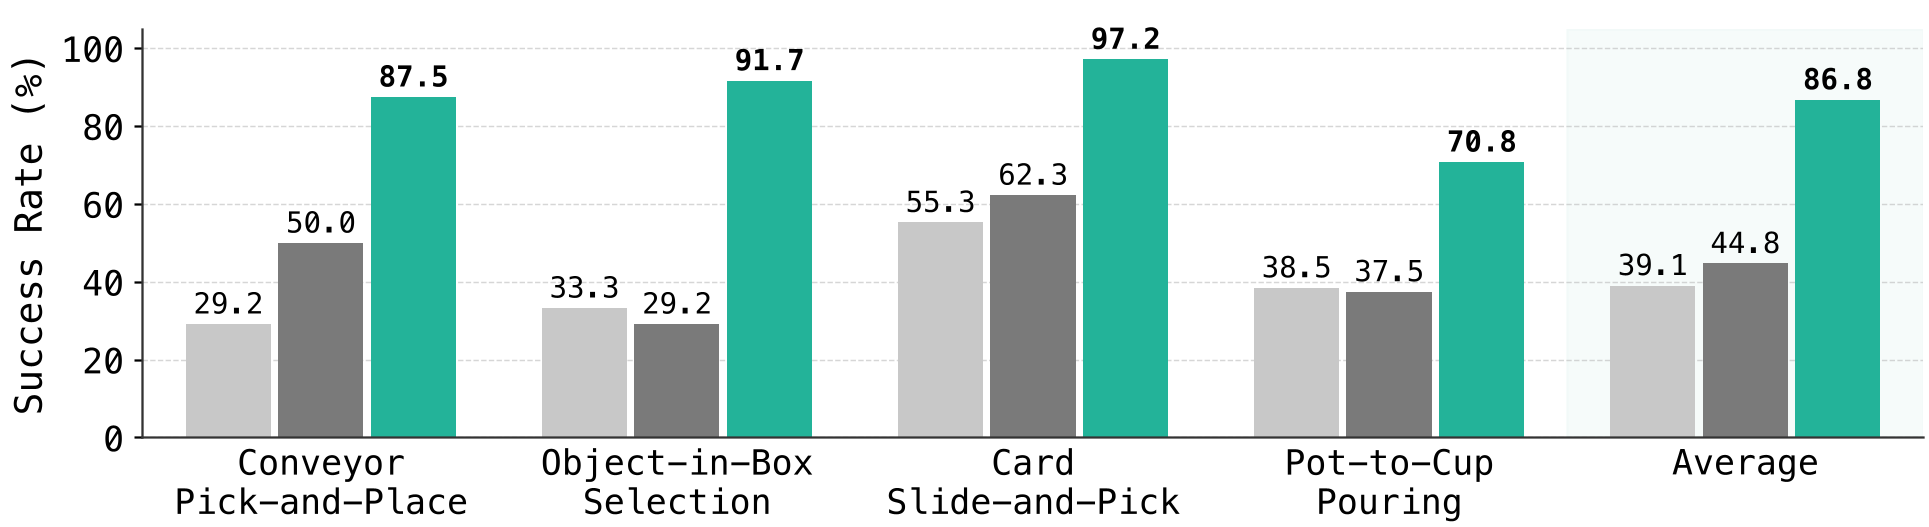 图 2:在 ALLEX 人形机器人上的各项功能性评估结果。
工程硬实力:43.7ms 的极致推理
对于实时控制,延迟就是杀手。论文特别强调了系统级优化:
- 静态图转换:通过预计算 RoPE 等配置依赖项,将整个前向传播捕获为单个 CUDA Graph,彻底解决 PyTorch Eager 模式下的碎片化问题。
- 定制核函数:手动融合了 RMSNorm, RoPE 和 SwiGLU,减少了显存的往返读写(HBM traffic)。最终在 RTX 5090 上实现了 1.63 倍的起飞级加速。
深度洞察与总结
RLDX-1 的成功标志着 VLA 研究正在从“大规模预训练”转向“针对物理交互的深度特化”。虽然 VLM 提供了常识,但要解决接触力学和非齐次环境下的控制问题,多流架构下的传感器融合才是关键。
局限性:尽管 RLDX-1 在灵巧性上表现优异,但其对罕见物理现象(如极度粘弹性的物体)的理解仍受限于 IDM 的拟合能力。未来,将世界模型(World Model)直接整合进 MSAT 的潜在状态空间,可能是实现真正具身进化论的下一站。